İçindekiler
Büyük bir restoranda her yemeği tek aşçının hazırladığını düşünün. Aşçı yetenekli olsa bile suşiden tatlıya kadar her konuda aynı derecede başarılı olması zordur. Mixture of Experts (MoE) mimarisi de benzer bir problemi çözer: Tek ve devasa bir sinir ağı yerine, farklı girdilerde uzmanlaşabilen alt ağlar kullanır. Üstelik her girdi bütün uzmanlara gönderilmez; bir yönlendirici, o girdi için en uygun birkaç uzmanı seçer.
``
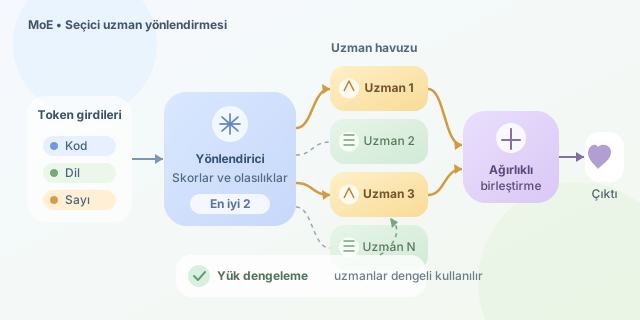
MoE mimarisinin temel fikri
Bir MoE katmanı üç ana parçadan oluşur:
- Uzmanlar: Genellikle birbirinden bağımsız ileri beslemeli sinir ağlarıdır.
- Router veya gating network: Hangi girdinin hangi uzmana gideceğini belirler.
- Birleştirme mekanizması: Seçilen uzmanların çıktılarını ağırlıklı biçimde toplar.
Bir token temsili $x$ ve $N$ adet uzman olduğunu varsayalım. Router önce her uzman için bir skor üretir:
\[s = W_r x\]Ardından skorlar olasılığa dönüştürülür:
\[p_i = \frac{e^{s_i}}{\sum_{j=1}^{N} e^{s_j}}\]Buradaki $p_i$, girdinin $i$. uzmana gönderilme uygunluğunu temsil eder. Teorik olarak bütün uzmanların sonuçları kullanılabilir:
\[y = \sum_{i=1}^{N} p_i E_i(x)\]Ancak bu yaklaşım hesaplama avantajını ortadan kaldırır. Modern MoE sistemleri çoğunlukla Top-k routing kullanır. Örneğin Top-2 yönlendirmede yalnızca en yüksek puanlı iki uzman çalıştırılır.
Her girdi neden farklı uzmana gider?
Çünkü girdiler aynı tür bilgiyi taşımaz. Bir dil modelindeki “Python sınıfı” ifadesi programlamayla ilişkiliyken, “yılanın yaşam alanı” ifadesi biyolojiyle ilişkilidir. Eğitim sırasında router ve uzmanlar birlikte öğrenir. Belirli örüntüler bazı uzmanlarda daha düşük hata oluşturdukça router benzer girdileri bu uzmanlara göndermeye eğilim kazanır.
Bu uzmanlaşma insan tarafından önceden etiketlenmez. Yani “3 numaralı uzman matematikçi olsun” denmez. Uzmanlıklar, optimizasyon sürecinin doğal sonucu olarak ortaya çıkar. Bazı uzmanlar sözdizimi, bazıları sayısal ilişkiler, bazıları da belirli dil kalıpları konusunda güçlenebilir.
| Özellik | Yoğun model | MoE modeli |
|---|---|---|
| Her girdide çalışan parametreler | Tüm parametreler | Seçilen uzmanlar |
| Hesaplama maliyeti | Modelle birlikte hızla artar | Daha kontrollü artar |
| Uzmanlaşma | Parametreler ortak çalışır | Alt ağlar farklılaşabilir |
| Yönlendirme ihtiyacı | Yok | Router gerektirir |
| Temel risk | Yüksek işlem maliyeti | Dengesiz uzman kullanımı |
Basitleştirilmiş bir router
Aşağıdaki PyTorch örneği, her girdi için en uygun iki uzmanı seçen sade bir yönlendirme mekanizması gösterir:
import torch
import torch.nn as nn

class SimpleRouter(nn.Module):
    def __init__(self, input_dim, expert_count, top_k=2):
        super().__init__()
        self.gate = nn.Linear(input_dim, expert_count)
        self.top_k = top_k

    def forward(self, x):
        scores = self.gate(x)
        probabilities = torch.softmax(scores, dim=-1)

        weights, expert_ids = torch.topk(
            probabilities, self.top_k, dim=-1
        )
        weights = weights / weights.sum(dim=-1, keepdim=True)
        return expert_ids, weights

router = SimpleRouter(input_dim=128, expert_count=8)
tokens = torch.randn(4, 128)
expert_ids, weights = router(tokens)
Kod, dört token için sekiz uzman arasından ikişer uzman seçer. expert_ids hangi uzmanların etkinleştirileceğini, weights ise çıktılarının hangi oranlarda birleştirileceğini belirtir. Gerçek sistemlerde tokenların seçilen uzmanlara dağıtılması ve sonuçların yeniden doğru sıraya konması da gerekir.
Herkes aynı uzmana koşarsa ne olur?
Router yalnızca ana görev kaybıyla eğitilirse popüler birkaç uzman bütün tokenları çekebilir. Bu durum kuyruk oluşmasına, kapasite aşımına ve diğer uzmanların yeterince öğrenememesine yol açar. Bu nedenle modele bir yük dengeleme kaybı eklenir:
\[L = L_{task} + \lambda L_{balance}\]$L_{balance}$, uzmanların daha dengeli kullanılmasını teşvik eder; $\lambda$ ise bu hedefin önemini ayarlar. Ayrıca her uzmana sınırlı token kapasitesi atanabilir. Kapasiteyi aşan tokenlar başka bir uzmana yönlendirilir veya nadiren işlenmeden bırakılır.
Sonuç olarak MoE, “her problem için bütün beyni çalıştırmak” yerine doğru anda doğru uzmanı çağırır. Böylece toplam parametre sayısı çok büyürken token başına hesaplama görece düşük kalabilir. Başarının sırrı yalnızca çok sayıda uzmana sahip olmak değil; router’ın onları dengeli, kararlı ve anlamlı biçimde kullanmayı öğrenmesidir.
Yorumlar