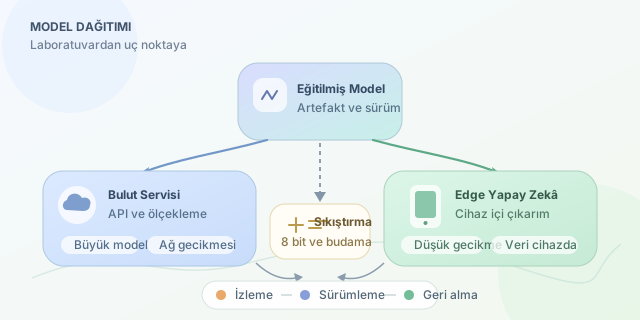
Bir makine öğrenmesi modelinin yüksek doğrulukla eğitilmesi, ürün yolculuğunun yalnızca başlangıcıdır. Asıl heyecanlı bölüm, modelin gerçek kullanıcıların fotoğraflarını sınıflandırdığı, sesli komutlarını anladığı veya dolandırıcılık işlemlerini yakaladığı dağıtım (deployment) aşamasıdır. Bu aşamada model; bulutta çalışan bir web API’sine, bir mobil uygulamaya, akıllı saate ya da internet bağlantısı sınırlı bir cihaza yerleştirilir.
``
Dağıtımın temel amacı, eğitim sırasında üretilen model artefaktını güvenilir bir tahmin servisine dönüştürmektir. Eğitim ortamında Python, GPU ve bolca bellek bulunabilir; üretimde ise saniyede binlerce istek, maliyet sınırı, veri gizliliği ve sürüm uyumluluğu gibi gerçek hayat misafirleri kapıyı çalar. Bir modelin uçtan uca gecikmesi kabaca şu şekilde düşünülebilir:
\[T_{toplam}=T_{ön\ işleme}+T_{çıkarım}+T_{ağ}+T_{son\ işleme}\]Bulut tabanlı mimaride $T_{ağ}$ bazen modelin hesaplama süresinden daha büyük hale gelir. Edge AI, yani uç nokta yapay zekâsı, çıkarımı kullanıcının cihazında gerçekleştirerek bu gecikmeyi ve veri aktarımını azaltmayı hedefler.
| Özellik | Bulut Dağıtımı | Edge AI Dağıtımı |
|---|---|---|
| Çıkarım yeri | Uzak sunucu | Telefon, saat, kamera, IoT cihazı |
| Gecikme | Ağ kalitesine bağlı | Genellikle düşük ve tutarlı |
| Gizlilik | Veri sunucuya gönderilebilir | Veri cihazda kalabilir |
| Model boyutu | Büyük modeller mümkündür | Bellek ve pil kısıtları vardır |
| Güncelleme | Merkezi olarak kolay | Cihazlara kontrollü dağıtım gerekir |
Sunucuda model servis etmek
Web tabanlı bir senaryoda model, sıkça REST veya gRPC uç noktası olarak sunulur. Python ekosisteminde FastAPI; doğrulama, dokümantasyon ve asenkron çalışma avantajları nedeniyle popülerdir. Aşağıdaki örnek, önceden yüklenmiş bir sınıflandırma modelini HTTP üzerinden erişilebilir yapar:
from fastapi import FastAPI
from pydantic import BaseModel
import joblib

app = FastAPI()
model = joblib.load("model.joblib")

class PredictionRequest(BaseModel):
    features: list[float]

@app.post("/predict")
def predict(payload: PredictionRequest):
    probability = model.predict_proba([payload.features])[0, 1]
    return {
        "label": int(probability >= 0.5),
        "probability": round(float(probability), 4)
    }
Bu kodun önemli fikri, modelin her istek geldiğinde yeniden eğitilmemesidir: model uygulama açılırken belleğe alınır, istekler yalnızca çıkarım yapar. Üretimde bunun önüne Docker konteyneri, yük dengeleyici, kimlik doğrulama, loglama ve izleme katmanları eklenir. Ayrıca yalnızca hata oranını değil, gecikme yüzdeliklerini de izlemek gerekir; örneğin p95 gecikmesi kullanıcı deneyimini ortalamadan daha iyi anlatır.
Edge cihazlarda model küçültme sanatı
Telefon veya saat, veri merkezindeki GPU gibi davranmaz. Bu nedenle TensorFlow Lite, Core ML ve ONNX Runtime Mobile gibi çalışma zamanları kullanılır. Modelin cihazda çalışabilmesi için quantization uygulanabilir: 32 bit kayan noktalı ağırlıklar 8 bit tamsayılara dönüştürülür. Bellek tüketimi yaklaşık olarak
\[M \approx N \times b\]ile ifade edilebilir. Burada $N$ parametre sayısı, $b$ ise parametre başına bit sayısıdır. Böylece 32 bitten 8 bite geçiş, teorik olarak ağırlık belleğini dörtte bire indirebilir. Ancak doğruluk kaybı test edilmeden bu dönüşüm yapılmamalıdır.
| Teknik | Kazanç | Dikkat edilmesi gereken |
|---|---|---|
| Quantization | Daha küçük ve hızlı model | Doğruluk düşüşü |
| Pruning | Gereksiz bağlantıları azaltma | Donanım desteği değişebilir |
| Distillation | Küçük öğrenci model | Eğitim süreci uzar |
| Batching | Sunucuda yüksek verim | Tek istek gecikmesi artabilir |
Başarılı dağıtım, modeli bir kez yayınlamak değildir. Veri dağılımı zamanla değişir; buna model drift denir. Bu yüzden sürümleme, geri alma (rollback), A/B testi ve anonimleştirilmiş performans metrikleri kritik önemdedir. Kısacası iyi bir yapay zekâ ürünü, sadece doğru tahmin yapan değil; hızlı, güvenli, izlenebilir ve gerektiğinde sessizce daha iyi bir sürüme geçebilen üründür.
Yorumlar