İçindekiler
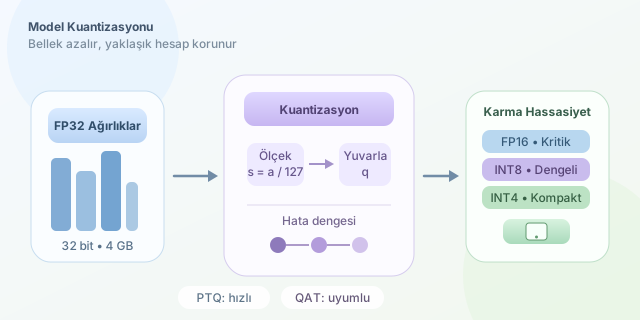
Bir yapay zekâ modelini telefonda çalıştırmak, taşınma günü dev bir koltuğu küçücük asansöre sokmaya benzer. Modelin milyarlarca parametresi belleği doldurur, hesaplamaları yavaşlatır ve pili neşeyle tüketir. Model kuantizasyonu, bu sayıları daha az bit kullanarak temsil eder; yani koltuğu parçalamadan, daha kompakt hâle getirir. Üstelik doğru uygulandığında modelin yeteneklerinin çoğu korunur. ``
Kuantizasyon tam olarak nedir?
Sinir ağları ağırlıkları çoğunlukla 32 bit kayan noktalı sayılarla, yani FP32 biçiminde saklar. Kuantizasyon bu değerleri FP16, INT8 veya INT4 gibi daha dar veri türlerine dönüştürür. Bir milyar parametre için teorik bellek ihtiyacı şöyle hesaplanır:
\[Bellek = Parametre\ Sayısı \times Parametre\ Başına\ Bit / 8\]Dolayısıyla bir milyar parametre FP32 biçiminde yaklaşık 4 GB, INT8 biçiminde 1 GB, INT4 biçiminde ise 0,5 GB yer kaplar. Gerçek kullanımda ölçekler, meta veriler ve çalışma tamponları nedeniyle sonuç biraz daha büyüktür.
| Biçim | Parametre başına bit | 1 milyar parametre | Genel özellik |
|---|---|---|---|
| FP32 | 32 | 4 GB | Yüksek hassasiyet, yüksek maliyet |
| FP16 | 16 | 2 GB | Eğitim ve GPU çıkarımı için dengeli |
| INT8 | 8 | 1 GB | Küçük kalite kaybıyla hızlı çıkarım |
| INT4 | 4 | 0,5 GB | Çok kompakt, hatalara daha duyarlı |
Sayıları küçültmenin matematiği
Simetrik kuantizasyonda gerçek değerler belirli bir ölçekle tam sayı aralığına eşlenir. INT8 için hedef aralık genellikle $[-127,127]$ seçilir. En büyük mutlak ağırlık $a$ ise ölçek:
\[s = a / 127\]şeklinde hesaplanır. Bir gerçek ağırlığın kuantize edilmiş karşılığı:
\[q = round(x / s)\]olur. Kullanım sırasında yaklaşık değer $x’ = q \times s$ ile geri üretilir. Aradaki $\vert x-x’\vert $ farkı kuantizasyon hatasıdır. Amaç belleği azaltırken bu hatanın model çıktısını bozmasını engellemektir.
Asimetrik kuantizasyon ayrıca bir sıfır noktası kullanır:
\[q = round(x / s) + z\]Bu yaklaşım dağılım sıfır çevresinde dengeli değilse aralığı daha verimli kullanabilir.
Küçük bir Python deneyi
Aşağıdaki kod, ağırlıkları INT8 aralığına sıkıştırıp tekrar yaklaşık kayan noktalı değerlere dönüştürür:
import numpy as np

weights = np.array([-1.2, -0.3, 0.0, 0.8, 1.7], dtype=np.float32)

max_abs = np.max(np.abs(weights))
scale = max_abs / 127

quantized = np.clip(
    np.round(weights / scale), -127, 127
).astype(np.int8)

dequantized = quantized.astype(np.float32) * scale
error = np.abs(weights - dequantized)

print("INT8 değerler:", quantized)
print("Yaklaşık ağırlıklar:", dequantized)
print("Ortalama hata:", error.mean())
Burada scale, gerçek sayı uzayı ile tam sayı uzayı arasındaki köprüdür. clip işlemi taşmayı önler; dequantized dizisi ise modelin hesaplama sırasında kullanabileceği yaklaşık değerleri gösterir.
PTQ mu, QAT mi?
| Yöntem | Ne zaman uygulanır? | Avantaj | Dezavantaj |
|---|---|---|---|
| PTQ | Eğitimden sonra | Hızlı ve ucuzdur | Düşük bitlerde kalite kaybı artabilir |
| QAT | Eğitim sırasında | Kuantizasyon hatasına uyum sağlar | Ek eğitim ve kaynak gerektirir |
Post-Training Quantization (PTQ), hazır modeli örnek verilerle kalibre eder. Quantization-Aware Training (QAT) ise ileri geçişte kuantizasyonu taklit ederek modelin yuvarlama hatalarına alışmasını sağlar. Büyük dil modellerinde ayrıca ağırlıkları grup grup ölçeklendiren yöntemler kullanılır. Böylece uç değerler tüm katmanın hassasiyetini bozmaz.
Her şeyi INT4 yapmak iyi fikir mi?
Her zaman değil. Bazı katmanlar, özellikle uç değerlere sahip ağırlıklar veya dikkat mekanizmasının hassas bölümleri, düşük bitlerden daha fazla etkilenir. Bu yüzden karma hassasiyet yaklaşımıyla kritik katmanlar FP16, diğerleri INT8 ya da INT4 tutulabilir. Başarı yalnızca dosya boyutuyla değil; doğruluk, gecikme, enerji tüketimi ve gerçek donanım desteğiyle birlikte ölçülmelidir.
Kuantizasyon sihirli bir sıkıştırma düğmesi değil, kontrollü bir yaklaşık hesaplama sanatıdır. Doğru ölçek, uygun bit genişliği ve gerçek verilerle yapılan testler sayesinde bir zamanlar sunucu isteyen model, telefonunuzda çevrimdışı ve hızlı biçimde çalışabilir.
Yorumlar