İçindekiler
Tek bir yapay zekânın oyun oynamayı öğrenmesi etkileyicidir; ancak aynı ortama birden fazla öğrenen ajan koyduğumuzda işler hızla bilim kurgu filmine dönüşür. Ajanlar yardımlaşabilir, kaynaklar için kapışabilir, birbirlerini kandırabilir veya ortak bir dil geliştirebilir. Multi-Agent Reinforcement Learning (MARL), yani çok ajanlı pekiştirmeli öğrenme, tam olarak bu hareketli dünyayı inceler.
``
Önce temel mantık: Ajan ne öğreniyor?
Klasik pekiştirmeli öğrenmede bir ajan, bulunduğu durum $s_t$ için bir eylem $a_t$ seçer. Ortam bunun karşılığında $r_t$ ödülünü ve yeni durum $s_{t+1}$ değerini üretir. Ajanın amacı, gelecekteki ödüllerin indirgenmiş toplamını büyütmektir:
\[G_t = \sum_{k=0}^{\infty} \gamma^k r_{t+k}\]Buradaki $\gamma$, ajanın ne kadar ileri görüşlü olduğunu belirleyen indirim katsayısıdır. Değer 0’a yaklaştığında ajan “ödül şimdi gelsin” der; 1’e yaklaştığında ise uzun vadeli stratejilere önem verir.
MARL ortamında tek bir ajan yerine $N$ ajan bulunur. Ortamın sonraki durumu, tüm ajanların ortak eylemine bağlıdır:
\[s_{t+1} \sim P(s_{t+1} \mid s_t, a_t^1, a_t^2, \ldots, a_t^N)\]Dolayısıyla bir ajanın karşılaştığı dünya sürekli değişir; çünkü diğer ajanlar da öğrenmektedir. Bu durum durağan olmama problemi olarak bilinir.
İşbirliği mi, rekabet mi?
| Ortam türü | Ödül yapısı | Tipik davranış | Örnek |
|---|---|---|---|
| İşbirlikçi | Ortak ödül | Görev paylaşımı | Robot filosu |
| Rekabetçi | Zıt ödüller | Rakibi engelleme | Satranç, futbol |
| Karma | Kısmen ortak | Geçici ittifaklar | Otonom trafik |
İşbirlikçi senaryoda depo robotları, çarpışmadan paket taşımayı öğrenebilir. Rekabetçi senaryoda bir ajan kazanırken diğeri kaybeder. Karma ortamlarda ise ajanlar bazen yardımlaşır, bazen “o şarj istasyonu benimdi!” diyerek mücadele eder.
Ajanlar gerçekten konuşabilir mi?
Evet, fakat konuşma her zaman doğal dil anlamına gelmez. Bir ajan diğerine konum, hedef veya niyet belirten sayısal mesajlar gönderebilir. Daha ilginci, mesajların anlamı önceden tanımlanmayabilir. Eğitim sırasında ajanlar, görevi kolaylaştıran kendi iletişim protokollerini keşfedebilir.
Örneğin 0.73 mesajı zamanla “sağ koridor boş” anlamına gelebilir. İnsan açısından anlamsız görünen bu sinyal, ajanlar için oldukça net olabilir. Buna ortaya çıkan iletişim denir.
Basit bir ortak ödül örneği
Aşağıdaki Python fonksiyonu, iki ajanın aynı hedefe yaklaşmasını ödüllendirirken çarpışmalarını cezalandırır:
def ortak_odul(ajanlar, hedef):
    odul = 0.0

    for ajan in ajanlar:
        mesafe = abs(ajan.x - hedef.x) + abs(ajan.y - hedef.y)
        odul -= 0.1 * mesafe  # Hedeften uzak kalmayı cezalandırır.

    ayni_konum = ajanlar[0].konum == ajanlar[1].konum
    if ayni_konum:
        odul -= 10  # Çarpışmayı pahalı hâle getirir.

    if all(ajan.hedefte for ajan in ajanlar):
        odul += 50  # Takım başarısını ödüllendirir.

    return odul
Bu tasarım basit görünse de kritik bir soruyu doğurur: Takım başarılı olduğunda hangi ajan ne kadar katkı sağladı? Kredi atama problemi, ortak ödülün bireysel davranışlarla ilişkilendirilmesini zorlaştırır.
Merkezi eğitim, dağıtık uygulama
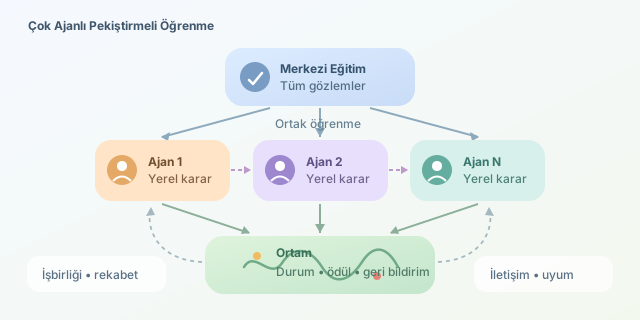
Yaygın çözümlerden biri Centralized Training, Decentralized Execution (CTDE) yaklaşımıdır. Eğitim sırasında merkezi sistem tüm ajanların durumlarını görebilir. Gerçek kullanımda ise her ajan yalnızca kendi gözlemiyle karar verir.
| Aşama | Kullanılabilen bilgi | Avantaj |
|---|---|---|
| Eğitim | Tüm ajanların gözlemleri | Daha kararlı öğrenme |
| Uygulama | Yerel gözlem ve mesajlar | Ölçeklenebilir otonomi |
MARL; trafik ışıklarının koordinasyonundan drone sürülerine, enerji şebekelerinden strateji oyunlarına kadar geniş bir alanda kullanılır. En büyük zorluk yalnızca iyi karar veren ajanlar üretmek değil, başkalarının değişen davranışlarına uyum sağlayan ekip arkadaşları ve rakipler geliştirmektir. Kısacası geleceğin yapay zekâları sadece düşünecek değil; pazarlık edecek, takım kuracak ve muhtemelen dijital toplantılardan bizim kadar yorulacak.
Yorumlar