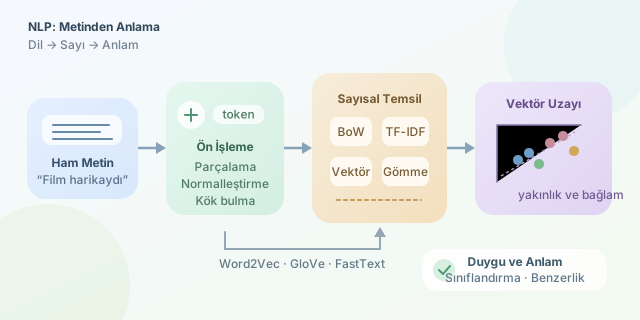
Bir bilgisayara “Bu film harikaydı” dediğinizde onun heyecanlanmasını beklemeyiz; fakat cümlenin olumlu bir duygu taşıdığını hesaplayabilmesini isteriz. Doğal Dil İşleme (Natural Language Processing, NLP), insan dilinin kurallı ama bir o kadar da muğlak dünyasını algoritmaların çalışabileceği sayısal temsillere dönüştüren alandır. Arama motorlarından sohbet botlarına, otomatik çeviriden spam filtrelerine kadar pek çok sistemin mutfağında NLP vardır. ``
NLP’nin temel problemi şudur: Bilgisayarlar kelimeleri doğrudan “anlam” olarak değil, sayılar olarak işler. Bu nedenle önce metni parçalar, temizler ve ölçülebilir özelliklere dönüştürürüz. Bu süreçte tokenization cümleyi kelimelere veya alt kelimelere ayırır; normalleştirme ise büyük-küçük harf farkı, noktalama işaretleri ya da yazım çeşitleri gibi gürültüleri azaltır. Türkçe eklemeli bir dil olduğu için “kitap”, “kitabım” ve “kitaplarımızdan” örneklerinde kök bulma veya biçimbilimsel çözümleme ayrıca önem kazanır.
Metni sayısallaştırmanın ilk adımları
En temel yaklaşım olan Bag of Words (BoW), bir metinde hangi kelimenin kaç defa geçtiğini sayar. Kelime sırası kaybolur; “köpek kediyi kovaladı” ile “kedi köpeği kovaladı” benzer vektörlere yaklaşabilir. Buna rağmen hızlı sınıflandırma görevleri için güçlü bir başlangıç noktasıdır. TF-IDF ise sık geçen ama ayırt edici olmayan sözcüklerin etkisini azaltır:
\[\mathrm{TF\text{-}IDF}(t,d)=\mathrm{TF}(t,d)\times\log\frac{N}{\mathrm{DF}(t)}\]Burada $\mathrm{TF}(t,d)$ terimin belgede görülme sıklığı, $N$ toplam belge sayısı, $\mathrm{DF}(t)$ ise terimi içeren belge sayısıdır. Örneğin “ve” çok sık görülür fakat bir haberin konusunu belirlemekte “deprem” kadar yararlı değildir.
| Yaklaşım | Güçlü yanı | Temel sınırlaması |
|---|---|---|
| BoW | Basit, yorumlanabilir ve hızlıdır | Kelime sırasını ve bağlamı saklamaz |
| TF-IDF | Ayırt edici kelimeleri öne çıkarır | Anlamsal benzerliği doğrudan öğrenmez |
| Kelime gömmeleri | Anlam ve ilişki örüntülerini yakalar | Büyük veri ve dikkatli eğitim gerektirir |
Vektör uzayında anlam
Modern NLP’de kelimeler, yüksek boyutlu uzayda yoğun vektörler olarak temsil edilir. Ana fikir büyüleyici derecede sezgiseldir: Benzer bağlamlarda görülen kelimelerin vektörleri de birbirine yakın olmalıdır. Bu düşünce, “Bir kelimenin anlamını birlikte bulunduğu kelimeler belirler” dağılımsal hipotezine dayanır.
Word2Vec, bu fikri iki mimariyle öğrenir. CBOW, çevredeki kelimelerden merkez kelimeyi tahmin eder; Skip-gram ise merkez kelimeden komşularını tahmin etmeye çalışır. Eğitim sonunda “kral”, “kraliçe”, “erkek” ve “kadın” gibi kavramlar arasında doğrusal ilişkiler oluşabilir:
\[\vec{\text{kral}}-\vec{\text{erkek}}+\vec{\text{kadın}}\approx\vec{\text{kraliçe}}\]GloVe (Global Vectors) ise yalnızca yerel pencereye değil, tüm derlemdeki ortak görülme istatistiklerine de bakar. Kısaca Word2Vec tahmin problemi kurarken, GloVe ortak görülme matrisindeki örüntüleri sıkıştırır.
| Model | Öğrenme bakışı | Ne zaman tercih edilir? |
|---|---|---|
| Word2Vec | Kelime-komşu tahmini | Büyük metinlerde hızlı gömme eğitimi için |
| GloVe | Küresel ortak görülme sayımları | Derlem istatistiklerini etkin kullanmak için |
| FastText | Alt kelime parçaları | Türkçe gibi eklemeli diller ve nadir kelimeler için |
Vektörlerin yakınlığını ölçmek için çoğunlukla kosinüs benzerliği kullanılır. Vektörlerin uzunluğundan çok yönünü karşılaştırdığı için pratikte kullanışlıdır:
\[\cos(\theta)=\frac{\vec{u}\cdot\vec{v}}{\ \vert \vec{u}\ \vert \ \vert \vec{v}\ \vert }\]Aşağıdaki küçük örnek, önceden eğitilmiş bir modelle benzer kelimeleri sorgulama fikrini gösterir:
from gensim.models import KeyedVectors

# Dosya, Türkçe Word2Vec vektörlerini içerir.
model = KeyedVectors.load_word2vec_format("tr_vectors.vec")
for kelime, skor in model.most_similar("yazılım", topn=5):
    print(f"{kelime}: {skor:.3f}")
Bu kod sınıflandırma yapmaz; “yazılım” kelimesinin vektör uzayındaki komşularını bulur. Ancak klasik gömmelerin bir zayıflığı vardır: “yüz” kelimesi insan yüzü ile sayı olan yüz için tek vektör alır. Bağlama duyarlı Transformer modelleri bu sorunu azaltır. Yine de NLP yolculuğunda BoW, TF-IDF ve kelime vektörleri; metni matematiğe çevirmenin vazgeçilmez temel taşlarıdır.
Yorumlar