İçindekiler
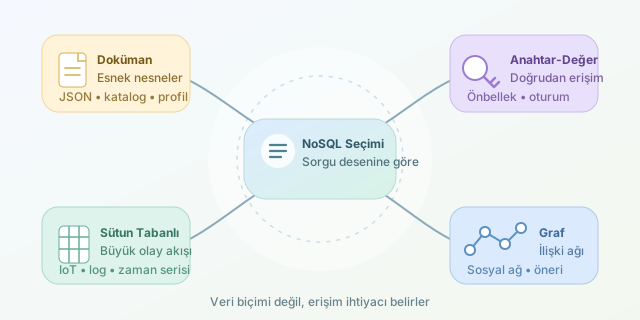
NoSQL, tek bir veritabanı teknolojisini değil; ilişkisel tablolara sığmayan veri modelleri için geliştirilmiş geniş bir yaklaşım ailesini ifade eder. Esnek şema, yatay ölçekleme ve yüksek erişilebilirlik ihtiyacı arttıkça doküman, anahtar-değer, sütun tabanlı ve graf veritabanları farklı problemlerde öne çıkar. Doğru seçimi yapmak için önce verinin nasıl sorgulanacağını anlamak gerekir: Veriniz nesne mi, olay akışı mı, devasa kayıt koleksiyonu mu, yoksa ilişkiler ağı mı? ``
NoSQL sistemlerinde temel fikir, veriyi uygulamanın erişim biçimine yakın modellemektir. İlişkisel sistemlerde normalleştirme sıkça tercih edilirken, NoSQL dünyasında okuma maliyetini azaltmak adına denormalizasyon yaygındır. Ancak bu, her veriyi kopyalamak anlamına gelmez; sorgu desenlerine göre bilinçli tekrar üretmektir.
Dört model, dört farklı bakış açısı
| Tür | Temel veri birimi | Güçlü olduğu sorgular | Popüler örnekler |
|---|---|---|---|
| Doküman | JSON/BSON benzeri belge | Nesne ve alan bazlı filtreleme | MongoDB, CouchDB |
| Anahtar-değer | anahtar → değer |
Çok hızlı doğrudan erişim | Redis, DynamoDB |
| Sütun tabanlı | Satır anahtarı ve sütun aileleri | Büyük ölçekli yazma/okuma | Cassandra, HBase |
| Graf | Düğüm ve ilişki | Çok adımlı bağlantı analizi | Neo4j, Neptune |
Doküman veritabanları: Uygulama nesnelerine yakın dünya
Doküman veritabanında her kayıt, iç içe alanlar barındırabilen bağımsız bir belgedir. Bir e-ticaret siparişi; müşteri özeti, teslimat adresi ve ürün kalemlerini tek dokümanda tutabilir. Bu yapı, API çıktılarıyla doğal biçimde eşleşir ve şema değişimlerini daha az sancılı hâle getirir.
// MongoDB: belirli bir kullanıcının teslim edilmiş siparişlerini getirir
db.orders.find({
  customerId: "u-42",
  status: "delivered"
})
Bu yaklaşım, içerik yönetim sistemleri, ürün katalogları, kullanıcı profilleri ve hızla evrilen SaaS uygulamaları için idealdir. Buna karşılık, belgeler arası yoğun join ihtiyacı varsa veri tekrarları ve tutarlılık kuralları dikkatle yönetilmelidir.
Anahtar-değer: Milisaniye yarışlarının şampiyonu
Anahtar-değer depoları en sade modeli kullanır: Bir anahtarı verirsiniz, karşılığında değeri alırsınız. Arama motoru gibi karmaşık filtreler beklememek gerekir; ödülü ise inanılmaz hızlı erişimdir. Önbellek, oturum yönetimi, sayaçlar, kısa ömürlü token’lar ve kuyruk benzeri işler klasik senaryolardır.
Bir önbellek isabet oranı şu şekilde ifade edilebilir:
\[Hit\ Rate = \frac{Cache\ Hits}{Cache\ Hits + Cache\ Misses}\]Bu oran yükseldikçe ana veritabanına giden yük düşer. Redis ile oturum saklamak buna iyi bir örnektir:
# Oturumu 30 dakika yaşayacak şekilde saklar
redis.setex(f"session:{user_id}", 1800, session_json)
Anahtar tasarımı kritiktir. session:42 gibi anlamlı ve çakışmasız anahtarlar, veri yaşam döngüsünü yönetmeyi kolaylaştırır.
Sütun tabanlı: Büyük hacimde düzenli performans
Cassandra ve HBase gibi geniş sütunlu sistemler, milyarlarca kaydın dağıtık makinelerde tutulduğu senaryolarda parlar. Özellikle zaman serileri, IoT telemetrisi, loglar ve mesajlaşma olayları için güçlüdür. Buradaki “sütun tabanlı” ifade analitik sütun depolarıyla tamamen aynı kavram değildir; veriler çoğunlukla sütun aileleri altında dağıtılır.
| İhtiyaç | Uygun tasarım yaklaşımı |
|---|---|
| Cihazın son ölçümlerini getirmek | device_id ile bölümleme, zamanla sıralama |
| Çok yüksek yazma hızı | Sorguya göre önceden tasarlanmış tablo |
| Rastgele çok boyutlu raporlama | Ayrı analitik sisteme aktarım |
Örneğin bölüm anahtarı kötü seçilirse tek bir cihaz ya da gün aşırı yoğunluk yaratabilir. Amaç yükü düğümlere dengeli yaymaktır: yaklaşık olarak her düğümün yükü $L/N$ seviyesinde kalmalıdır.
Graf veritabanları: İlişkiler verinin kendisiyse
Sosyal ağlarda “arkadaşımın arkadaşları”, dolandırıcılık tespitinde para transfer zincirleri veya öneri motorlarında benzerlik ağları graf modelinin doğal alanıdır. Düğümler varlıkları, kenarlar ise ilişkileri temsil eder. İlişkisel veritabanında çok sayıda join gerektiren gezinmeler, graf motorunda doğrudan kenar takibiyle yapılır.
// Neo4j: Ayşe'nin arkadaşlarının sevdiği, Ayşe'nin sevmediği ürünler
MATCH (ayse:User {name: "Ayşe"})-[:FRIEND]->(:User)-[:LIKES]->(p:Product)
WHERE NOT (ayse)-[:LIKES]->(p)
RETURN p.name, count(*) AS score
ORDER BY score DESC
Sonuç olarak seçim bir popülerlik yarışması değildir. Esnek nesneler için doküman, doğrudan erişim için anahtar-değer, devasa olay akışları için sütun tabanlı, bağlantıların anlam taşıdığı problemler için graf veritabanı seçilmelidir. En iyi mimarilerde ise bu modeller, tek bir araç her işi yapsın diye zorlanmak yerine birlikte kullanılabilir.
Yorumlar