İçindekiler
Modern bir sunucuda bütün RAM modülleri aynı anakarta takılı olsa da işlemci çekirdekleri açısından eşit uzaklıkta değildir. NUMA, yani Non-Uniform Memory Access, tam olarak bu gerçeği ifade eder: Bir çekirdeğin bazı bellek bölgelerine erişimi hızlı ve ucuzken diğerlerine erişimi daha yavaş olabilir. Kısacası RAM ortak görünür, fakat ona giden yolların uzunluğu aynı değildir.
``
Önce UMA dünyasını hatırlayalım
UMA (Uniform Memory Access) mimarisinde işlemci çekirdekleri belleğe yaklaşık aynı gecikmeyle erişir. Küçük ve tek soketli sistemlerde bu model, gerçeğe yeterince yakın bir soyutlamadır. Ancak çekirdek ve işlemci soketi sayısı arttıkça bütün trafiği tek bir bellek denetleyicisinden geçirmek darboğaz oluşturur.
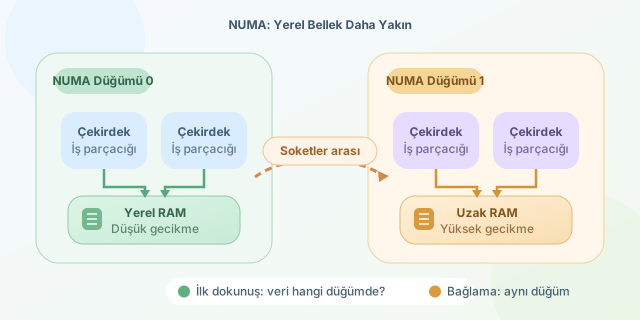
NUMA sistemlerinde her işlemci soketi veya çekirdek grubu, kendisine bağlı bir bellek denetleyicisine ve RAM kanallarına sahiptir. Bu işlemci-bellek kümesine NUMA düğümü denir. Bir çekirdeğin kendi düğümündeki belleğe erişmesi yerel erişim, başka bir düğümün belleğine erişmesi ise uzak erişim olarak adlandırılır.
| Özellik | Yerel bellek | Uzak bellek |
|---|---|---|
| Fiziksel bağlantı | Çekirdeğin bağlı olduğu düğümde | Başka bir NUMA düğümünde |
| Gecikme | Daha düşük | Daha yüksek |
| Bant genişliği | Genellikle daha yüksek | Ara bağlantıyla sınırlı |
| Trafik maliyeti | Düşük | Soketler arası trafik oluşturur |
| Tercih edilen kullanım | Sık erişilen veriler | Yerel kapasite yetersizse |
Bellek erişim süresini basitleştirerek şöyle modelleyebiliriz:
\[T_{ortalama} = p \cdot T_{yerel} + (1-p) \cdot T_{uzak}\]Burada $p$, erişimlerin yerel bellekte gerçekleşme oranıdır. Örneğin yerel erişim 90 ns, uzak erişim 150 ns ve yerellik oranı $p=0.8$ ise:
\[T_{ortalama}=0.8\cdot90+0.2\cdot150=102\text{ ns}\]Tek bir erişimdeki fark küçük görünebilir. Fakat veri tabanı, sanal makine veya bilimsel hesaplama gibi uygulamalar saniyede milyonlarca bellek erişimi yaptığında bu fark performansı belirgin biçimde etkiler.
İşletim sistemi veriyi nereye koyar?
Linux çoğunlukla first-touch politikasını kullanır. Bir bellek sayfası fiziksel olarak, onu ilk kez kullanan iş parçacığının bulunduğu NUMA düğümüne yerleştirilir. Belleği ana iş parçacığı başlatır, işi başka çekirdekler yürütürse veriler yanlış düğümde kalabilir. Böylece çekirdekler sürekli uzak belleğe gidip gelir; adeta mutfaktaki bardağı almak için komşu binaya yürürler.
Sistemin NUMA yapısı numactl ile incelenebilir:
numactl --hardware
numactl --show
İlk komut düğümleri, düğümlerdeki işlemcileri, bellek miktarlarını ve uzaklık matrisini gösterir. İkinci komut ise çalışan kabuğun geçerli NUMA politikasını açıklar.
Bir programı belirli işlemciler ve bellek üzerinde çalıştırmak mümkündür:
numactl --cpunodebind=0 --membind=0 ./uygulama
Bu komut uygulama sürecini düğüm 0’ın işlemcilerine bağlar ve belleği aynı düğümden ayırır. Böylece yerel erişim teşvik edilir. Ancak düğüm 0’da yeterli RAM yoksa katı --membind politikası tahsis hatasına yol açabilir.
Alternatif olarak bellek sayfaları düğümlere dağıtılabilir:
numactl --interleave=all ./uygulama
Bu yöntem tek bir düğümün bellek bant genişliğinin dolmasını önleyebilir. Her erişimi yerel yapmaz; fakat büyük ve paralel iş yüklerinde trafiği daha dengeli dağıtabilir.
NUMA ne zaman önem kazanır?
| İş yükü | NUMA etkisi |
|---|---|
| Küçük masaüstü uygulaması | Genellikle düşük |
| Çok iş parçacıklı veri tabanı | Yüksek |
| Büyük JVM veya .NET süreci | Orta veya yüksek |
| Sanal makine sunucusu | Yüksek |
| Bellek bant genişliği yoğun hesaplama | Çok yüksek |
Özetle RAM, yazılım açısından tek ve düz bir adres alanı gibi görünse de donanım açısından her çekirdeğe aynı uzaklıkta değildir. İyi NUMA performansı; iş parçacıklarını, onların kullandığı verileri ve bellek tahsis politikasını aynı düğümde buluşturmaya dayanır. Optimizasyona başlamadan önce ölçüm yapmak, uzak bellek erişimlerini gözlemlemek ve uygulamanın çalışma desenini anlamak gerekir. NUMA bir hata değil, büyük sistemlerin ölçeklenmesini sağlayan güçlü ama mesafeli bir tasarımdır.
Yorumlar