Bir işlemcinin saniyede milyarlarca komut çalıştırabilmesi etkileyicidir; fakat ihtiyaç duyduğu veriyi beklerken hiçbir şey yapamaması pek havalı değildir. Modern bilgisayarlarda L1, L2 ve L3 önbelleklerin bulunmasının temel nedeni bu beklemeyi azaltmaktır. Veriler işlemci çekirdeğinden uzaklaştıkça erişim süresi artar; kapasite büyürken hız katman katman düşer. `` Bu yapının arkasındaki ana fikir yerellik ilkesidir. Programlar çoğunlukla yakın zamanda kullandıkları verilere tekrar erişir. Buna zamansal yerellik denir. Diziler gibi bellekte yan yana duran verilere sırayla erişmeleri ise mekânsal yerellik oluşturur. İşlemci bu davranışları kullanarak RAM’den tek bir bayt yerine genellikle 64 baytlık bir cache line getirir.
Katmanlar ne işe yarar?
| Katman | Yaklaşık kapasite | Tipik gecikme | Temel özellik |
|---|---|---|---|
| L1 cache | 32–128 KB | 1–5 çevrim | Çekirdeğe en yakın ve en hızlı katman |
| L2 cache | 256 KB–2 MB | 4–15 çevrim | Daha büyük, ancak biraz daha yavaş |
| L3 cache | Birkaç–onlarca MB | 20–60 çevrim | Genellikle çekirdekler arasında paylaşılır |
| RAM | Birkaç–yüzlerce GB | 100–300 çevrim | Büyük kapasite, yüksek gecikme |
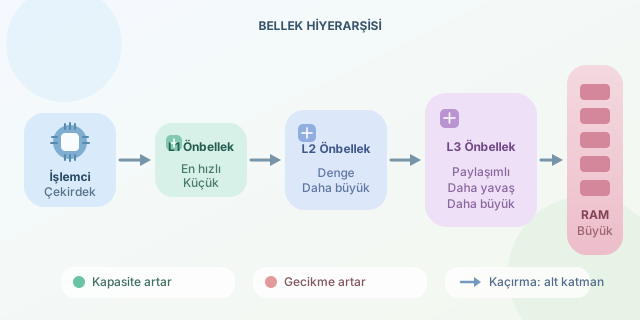
Değerler mimariye göre değişir; tablo kesin bir donanım sözleşmesi değil, büyüklük sıralamasını gösteren bir yol haritasıdır. L1 işlemcinin masasıysa RAM, binanın arşiv odasıdır. Masadaki belgeye uzanmak kolaydır; arşive gitmek için koridorda küçük bir yolculuk gerekir.
Büyük bellek neden daha yavaş?
Bir bellek büyüdükçe adresi çözmek, doğru hücreyi bulmak ve veriyi fiziksel bağlantılar üzerinden taşımak zorlaşır. Daha fazla hücre; daha uzun kablolar, daha karmaşık devreler ve daha yüksek enerji tüketimi anlamına gelir. L1 genellikle çok hızlı fakat alan bakımından pahalı olan SRAM ile üretilir. RAM ise daha yoğun ve ucuz olan DRAM kullanır. DRAM hücreleri düzenli olarak yenilenmelidir ve veri erişimi SRAM kadar doğrudan değildir.
Ortalama bellek erişim süresi basitçe şöyle modellenebilir:
\[AMAT = T_{L1} + M_{L1}(T_{L2} + M_{L2}(T_{L3} + M_{L3}T_{RAM}))\]Burada $T$ erişim süresini, $M$ ise ilgili katmandaki kaçırma oranını gösterir. L1 kaçırma oranındaki küçük bir artış bile milyonlarca erişimde ciddi performans kaybı doğurabilir.
Cache hit ve cache miss
İstenen veri ilgili katmanda bulunursa cache hit gerçekleşir. Bulunamazsa cache miss oluşur ve bir alt katmana gidilir. İşlemci bazen bu sırada bağımsız komutları çalıştırabilir; fakat gerekli veri olmadan ilerleyemiyorsa boru hattı bekler. Buna kabaca stall denir.
Aşağıdaki C kodu, aynı elemanları farklı erişim düzenleriyle gezer:
#define N 1024
int matrix[N][N];
long long sum = 0;

// Satır sıralı erişim: bellekte ardışık ilerler.
for (int i = 0; i < N; i++) {
    for (int j = 0; j < N; j++) {
        sum += matrix[i][j];
    }
}
C dizileri satır sıralı saklandığı için bu kod cache line içindeki verileri verimli kullanır. Döngülerin yerini değiştirmek ise büyük matrislerde daha fazla cache miss üretebilir:
// Sütun sıralı erişim: uzak adresler arasında sıçrar.
for (int j = 0; j < N; j++) {
    for (int i = 0; i < N; i++) {
        sum += matrix[i][j];
    }
}
| Erişim biçimi | Yerellik | Beklenen sonuç |
|---|---|---|
| Ardışık elemanlar | Yüksek mekânsal yerellik | Daha az cache miss |
| Dağınık adresler | Düşük mekânsal yerellik | Daha fazla bekleme |
| Tekrarlanan veri | Yüksek zamansal yerellik | Cache hit olasılığı yüksek |
Sonuç olarak hız düşüşü keyfî değildir: kapasite, maliyet, fiziksel mesafe ve enerji arasında yapılan bir mühendislik uzlaşmasıdır. Hızlı katmanlar sık kullanılan küçük veri kümesini tutarken RAM büyük çalışma alanını sağlar. Performanslı kod yazmanın sırrı da yalnızca daha az işlem yapmak değil, veriyi işlemcinin kolayca bulabileceği biçimde düzenlemektir.
Yorumlar