İçindekiler
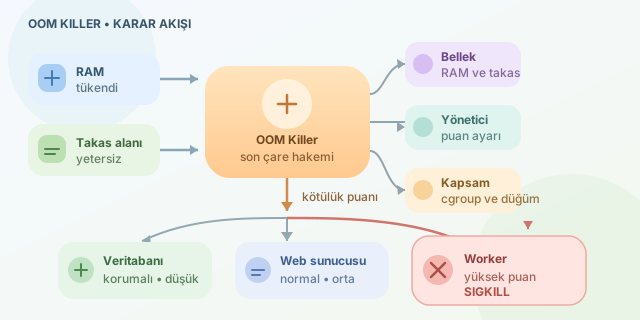
Bir Linux sunucusunda RAM ve kullanılabilir takas alanı tükendiğinde sistem tatsız bir seçimle karşılaşır: Ya tüm makine kilitlenecek ya da bazı süreçler feda edilecektir. Kernel’ın OOM (Out of Memory) Killer bileşeni ikinci yolu seçer. Ancak süreçleri rastgele avlamaz; bellek tüketimi, yönetici tercihleri ve sürecin sistem açısından önemi gibi etkenlerden bir “kötülük” puanı üretir.
``
OOM ne zaman devreye girer?
Linux önce boş sayfaları, dosya önbelleklerini ve gerekirse swap alanını kullanır. Bellek ayırma isteği bu yöntemlerle karşılanamazsa OOM koşulu oluşabilir. Bununla birlikte her başarısız tahsis doğrudan küresel bir katliam başlatmaz. Sorun yalnızca belirli bir cgroup’un limitinde yaşanıyorsa cgroup OOM, belirli NUMA düğümleriyle sınırlıysa ilgili bellek politikası kapsamında OOM gerçekleşebilir.
Amaç, en az sistem hasarıyla yeterli belleği geri kazandırmaktır. Basitleştirilmiş düşünce şu şekilde ifade edilebilir:
\[\text{badness} \approx \frac{\text{sürecin kullandığı bellek}}{\text{erişebildiği toplam bellek}} \times 1000 + \text{yönetici ayarı}\]Bu, kernel kaynak kodunun birebir formülü değildir; karar mantığını anlamaya yarayan bir modeldir. Modern Linux sürümlerinde süreç veya thread grubu tarafından kullanılan RAM ve swap miktarı önemli bir başlangıç noktasıdır. Puan, OOM olayının kapsamındaki kullanılabilir bellek üzerinden değerlendirilir.
Puanları nerede görürüz?
Kernel her süreç için /proc altında iki önemli arayüz sunar:
| Dosya | Anlamı | Tipik aralık |
|---|---|---|
/proc/PID/oom_score |
Kernel’ın kullanıcıya gösterdiği güncel OOM puanı | 0–1000 |
/proc/PID/oom_score_adj |
Yöneticinin puana uyguladığı tercih | -1000–1000 |
/proc/PID/status |
RSS, thread ve süreç bilgileri | Değişken |
oom_score ne kadar yüksekse süreç o kadar iştah açıcı bir kurbandır. oom_score_adj ise terazinin kefesine yöneticinin parmağını koyar. Pozitif değer sürecin öldürülme olasılığını artırır; negatif değer koruma sağlar. -1000, süreci OOM seçiminden muaf tutmak için kullanılan özel değerdir.
Aşağıdaki komutlar çalışan kabuğun ayarlarını inceler:
PID=$$
cat /proc/$PID/oom_score
cat /proc/$PID/oom_score_adj

# Süreci daha kolay feda edilebilir yapar.
echo 500 | sudo tee /proc/$PID/oom_score_adj
Son komut yalnızca puan ayarını değiştirir; süreci hemen öldürmez. Ayrıca başka bir kullanıcının sürecini değiştirmek veya negatif değer vermek için uygun yetkiler gerekir.
En çok RAM kullanan kesin ölür mü?
Hayır. Bellek tüketimi güçlü bir etkendir fakat tek etken değildir. Aynı miktarda bellek kullanan iki süreç, farklı oom_score_adj değerleri yüzünden tamamen farklı muamele görebilir. Kernel thread’leri ve OOM için uygun olmayan görevler de seçim dışında kalabilir. Geçmiş kernel sürümlerindeki nice değeri, çalışma süresi veya ayrıcalık gibi ölçütlere dayanan eski açıklamalar ise modern çekirdekler için yanıltıcı olabilir.
| Süreç | Bellek | oom_score_adj |
Beklenen risk |
|---|---|---|---|
| Veritabanı | 4 GB | -800 | Düşük |
| Worker | 2 GB | 500 | Yüksek |
| Web sunucusu | 1 GB | 0 | Orta |
OOM Killer kurbanı seçtikten sonra genellikle sürece SIGKILL gönderir. Süreç temizlik kodu çalıştıramaz; kernel onun bellek alanlarının serbest kalmasını bekler. Olayın izi çoğunlukla kernel günlüğündedir:
journalctl -k -g 'Out of memory\|Killed process'
dmesg -T | grep -Ei 'out of memory|killed process'
Pratik savunma stratejisi
Kritik servisleri körlemesine -1000 ile korumak caziptir, fakat herkes dokunulmaz olursa kernel uygun kurban bulamaz. Daha sağlıklı yaklaşım; servisleri cgroup veya systemd bellek limitleriyle ayırmak, geçici worker süreçlerine pozitif ayar vermek ve kritik veritabanlarına ölçülü koruma sağlamaktır. systemd tarafında OOMScoreAdjust=, MemoryHigh= ve MemoryMax= seçenekleri bu politikanın kurulmasına yardımcı olur.
Kısacası OOM Killer kötü niyetli bir cellat değil, belleksiz kalmış sistemin son çare hakemidir. Puanlama mekanizmasını anlamak, kurban listesini tesadüfe bırakmak yerine sistemin hangi yükü önce bırakacağını bilinçli biçimde tasarlamanızı sağlar.
Yorumlar