İçindekiler
Modern bilgisayarlarda CPU, GPU ve kimi zaman yapay zekâ hızlandırıcıları aynı problemi farklı güçlü yönleriyle çözebilir. OpenCL (Open Computing Language), bu donanım çeşitliliğini tek bir programlama modeli altında birleştiren açık bir standarttır. Amaç, yalnızca ekran kartını kullanmak değildir: Uygun işi uygun işlemciye vererek performans, enerji tüketimi ve taşınabilirlik arasında akıllı bir denge kurmaktır. ``
Heterojen hesaplama neden önemlidir?
CPU’lar az sayıda güçlü çekirdeğe, karmaşık dallanmalara ve düşük gecikmeye odaklanır. GPU’lar ise binlerce daha basit yürütme birimiyle aynı işlemi devasa veri kümeleri üzerinde tekrar etmeyi sever. Bu nedenle bir dosya ayrıştırıcı CPU’da mutlu olurken, milyonlarca pikselin filtrelenmesi GPU için biçilmiş kaftandır.
Bir işin ideal paralellik hızlanması kabaca Amdahl yasasıyla ifade edilir:
\[S(N) = \frac{1}{(1-P) + \frac{P}{N}}\]Burada $P$ paralelleştirilebilen oranı, $N$ ise etkin işlemci sayısını temsil eder. Örneğin işin %95’i paralel olsa bile seri kalan %5, teorik hızlanmayı sınırlar. OpenCL kodu yazarken asıl mesele, yalnızca çok sayıda iş parçacığı üretmek değil; seri darboğazları ve gereksiz bellek kopyalarını azaltmaktır.
| Özellik | CPU | GPU | OpenCL yaklaşımı |
|---|---|---|---|
| Güçlü olduğu iş | Dallanmalı, seri mantık | Düzenli veri paralelliği | İş yükünü ayırma |
| Çekirdek yapısı | Az, karmaşık | Çok, sade | Cihaz sorgulama |
| Bellek erişimi | Önbellek odaklı | Bant genişliği odaklı | Erişim düzeni tasarlama |
| Tipik kullanım | Kontrol akışı | Görüntü, matris, simülasyon | Taşınabilir hesaplama |
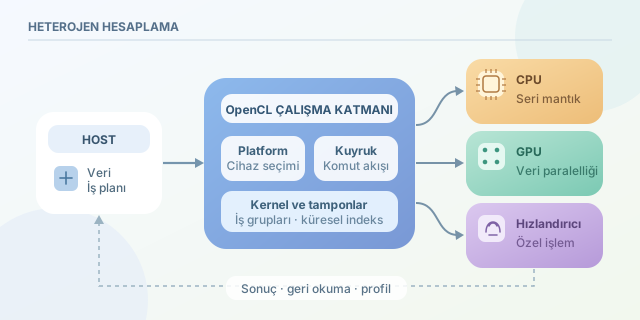
OpenCL’in temel modeli
OpenCL uygulaması iki bölümden oluşur. Host kodu genellikle C/C++, Python veya başka bir dilde çalışır; platformları bulur, cihaz seçer, bellek tamponları oluşturur ve kernel’i çalıştırır. Kernel ise cihaz üzerinde paralel çalışan küçük fonksiyondur.
Platform, OpenCL sürücüsü sunan üreticiyi; device ise CPU veya GPU gibi gerçek hesaplama birimini temsil eder. Bir kernel çağrısındaki her bağımsız çalışana work-item denir. Work-item’lar work-group’larda toplanır. get_global_id(0) fonksiyonu, her çalışanın küresel indeksini verir; böylece aynı kernel farklı veri elemanlarına saldırmadan çalışabilir.
Aşağıdaki örnek iki diziyi GPU ya da desteklenen başka bir cihaz üzerinde toplar:
__kernel void vector_add(
    __global const float *a,
    __global const float *b,
    __global float *result,
    const int n) {

    int i = get_global_id(0);
    if (i < n) {
        result[i] = a[i] + b[i];
    }
}
Bu kernel’de __global, host tarafından sağlanan ana cihaz belleğine erişimi belirtir. Sınır kontrolü önemlidir: Global iş boyutu çoğu zaman work-group boyutunun katına yuvarlanır. i < n koşulu, fazladan oluşturulan work-item’ların geçersiz bellek adresine yazmasını engeller.
Host tarafında işlem sırası özetle şöyledir:
// Platform ve GPU/CPU cihazını seç
// Context ve command queue oluştur
// a, b ve result için cl_mem buffer ayır
// Kernel kaynak kodunu derle, argümanları bağla
clEnqueueNDRangeKernel(queue, kernel, 1, nullptr,
                       &globalSize, &localSize, 0, nullptr, nullptr);
// Sonucu cihazdan host belleğine oku
globalSize, toplam work-item sayısıdır; localSize ise bir work-group içindeki çalışan sayısıdır. Her cihaz için tek bir sihirli değer yoktur. Profil çıkararak 64, 128 veya 256 gibi farklı yerel boyutları denemek gerekir.
Performans tuzakları ve iyi alışkanlıklar
En sık hata, küçük veri kümeleri için GPU’ya sürekli veri taşımaktır. Aktarım maliyeti $T_{copy}$, hesaplama kazancını aşarsa hızlanma yerine yavaşlama görülür:
\[T_{toplam} = T_{host} + T_{copy} + T_{kernel}\]Bu yüzden veriyi mümkün olduğunca cihazda tutun, işlemleri tek kernel zincirinde birleştirin ve profil araçlarıyla ölçün. Ayrıca komşu work-item’ların komşu bellek adreslerine erişmesi, özellikle GPU’da bellek bant genişliğini çok daha verimli kullanır.
OpenCL’in en büyük hediyesi taşınabilirliktir; fakat “her yerde aynı hız” garantisi vermez. Cihaz özelliklerini sorgulamak, farklı kernel varyasyonları hazırlamak ve CPU için anlamlı bir geri dönüş yolu sunmak, gerçekten sağlam heterojen uygulamaların temelidir.
Yorumlar