İçindekiler
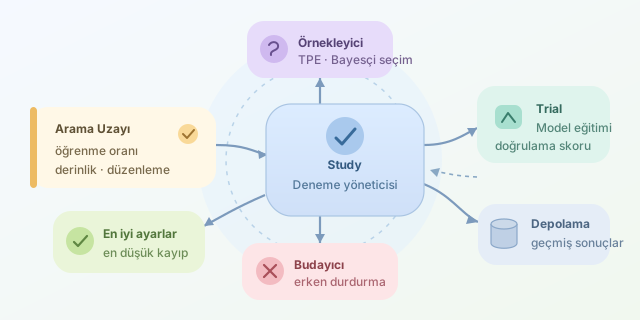
Bir makine öğrenmesi modelinin başarısı yalnızca veriye ve algoritmaya bağlı değildir; öğrenme oranı, ağaç derinliği veya düzenlileştirme katsayısı gibi hyperparameter’lar da sonucu ciddi biçimde değiştirir. Bu ayarları elle denemek, karanlık bir odada doğru anahtarı aramaya benzer. Optuna ise önceki denemelerden öğrenir, umut vermeyen deneyleri erkenden durdurur ve hesaplama bütçesini daha mantıklı adaylara yönlendirir. ``
Hyperparameter optimizasyonu neyi çözer?
Model eğitimi, seçilen hyperparameter vektörü $x$ için bir doğrulama kaybı üretir. Optimizasyonun amacı kabaca şudur:
\[x^* = \operatorname{argmin}_{x \in X} f(x)\]Burada $X$ arama uzayı, $f(x)$ ise eğitim ve doğrulama sürecinin sonunda ölçülen kayıptır. Sorun şu ki $f$ genellikle türevlenebilir değildir, her değerlendirme pahalıdır ve eğitimdeki rastlantısallık nedeniyle gürültülü sonuçlar verebilir. Dolayısıyla klasik gradyan inişi yerine, olabildiğince az deneyle iyi bölgeleri keşfeden yöntemlere ihtiyaç duyarız.
Grid, rastgele ve Bayesçi arama
| Yöntem | Aday seçimi | Güçlü yanı | Zayıf yanı |
|---|---|---|---|
| Grid Search | Sabit bir ızgara | Basit ve tekrarlanabilir | Boyut arttıkça maliyet patlar |
| Random Search | Dağılımlardan rastgele | Önemli parametreleri daha hızlı keşfedebilir | Geçmiş sonuçları kullanmaz |
| Bayesçi Optimizasyon | Önceki denemelere göre | Deneme bütçesini akıllıca harcar | Ek modelleme ve ayar gerektirir |
Grid Search’te her parametre için $k$ değer ve toplam $d$ parametre varsa yaklaşık $k^d$ kombinasyon oluşur. Beş parametrenin her biri için on seçenek belirlemek, $10^5$ eğitim anlamına gelir. Kahve makinesi bile bu planı görünce istifa edebilir.
Random Search bu maliyeti azaltır; ancak iyi ve kötü denemeler arasında hafıza kurmaz. Bayesçi yaklaşım ise gözlenen $(x, f(x))$ çiftlerinden yararlanarak sıradaki adayın nereden seçileceğine karar verir. Amaç yalnızca mevcut en iyi bölgeyi sömürmek değil, belirsiz alanları keşfetmektir. Bu dengeye exploration–exploitation dengesi denir.
Optuna’nın mimarisi
Optuna’da optimizasyon sürecinin merkezi Study nesnesidir. Her model eğitimi bir Trial, parametreleri öneren bileşen Sampler, başarısız olması muhtemel eğitimleri durduran bileşen ise Pruner olarak adlandırılır. Sonuçlar bellek, SQLite veya ilişkisel bir veritabanında saklanabilir.
Optuna’nın varsayılan yöntemlerinden TPE, yani Tree-structured Parzen Estimator, başarılı ve başarısız denemeler için iki olasılık yoğunluğu kurar:
\[l(x) = p(x \mid y < y^*), \qquad g(x) = p(x \mid y \geq y^*)\]Yeni adaylar, kabaca $l(x) / g(x)$ oranının yüksek olduğu bölgelerden seçilir. Başka bir deyişle Optuna, iyi sonuçlarda sık görülen fakat kötü sonuçlarda seyrek kalan parametrelere öncelik verir. Koşullu arama uzaylarını desteklediği için seçilen modele göre farklı parametreler de tanımlanabilir.
Uygulamalı bir örnek
Aşağıdaki kod, Random Forest modelinin temel ayarlarını optimize eder:
import optuna
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

X, y = load_breast_cancer(return_X_y=True)

def objective(trial):
    params = {
        "n_estimators": trial.suggest_int("n_estimators", 50, 400),
        "max_depth": trial.suggest_int("max_depth", 2, 20),
        "min_samples_split": trial.suggest_int("min_samples_split", 2, 16),
        "max_features": trial.suggest_float("max_features", 0.2, 1.0)
    }

    model = RandomForestClassifier(**params, random_state=42)
    score = cross_val_score(model, X, y, cv=5, scoring="accuracy").mean()
    return score

study = optuna.create_study(direction="maximize")
study.optimize(objective, n_trials=50)

print(study.best_value)
print(study.best_params)
objective fonksiyonu bir denemenin nasıl değerlendirileceğini tanımlar. suggest_int ve suggest_float çağrıları arama uzayını oluştururken study.optimize, sampler tarafından seçilen adayları sırayla çalıştırır. Sinir ağları gibi aşamalı eğitimlerde ara skorlar trial.report() ile bildirilip trial.should_prune() ile kötü denemeler erkenden kesilebilir.
Sonuç olarak Optuna sihirli biçimde mükemmel modeli garanti etmez; fakat deneme geçmişini, olasılıksal örneklemeyi, budamayı ve kalıcı depolamayı aynı mimaride birleştirir. Böylece hyperparameter araması, elle sayı çevirdiğimiz bir kumar makinesinden ölçülebilir ve tekrarlanabilir bir optimizasyon sürecine dönüşür.
Yorumlar