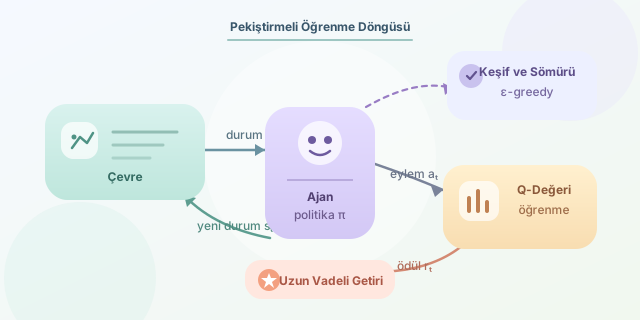
Pekiştirmeli öğrenme (Reinforcement Learning, RL), bir ajanın hazır doğru cevaplarla eğitilmek yerine çevresiyle etkileşime girerek öğrenmesidir. Ajan bir durum görür, eylem seçer ve çevreden ödül ya da ceza sinyali alır. Amaç anlık olarak en parlak ödülü kapmak değil, uzun vadede mümkün olan en yüksek toplam getiriyi elde etmektir. Bu yaklaşım, satranç oynayan yapay zekâlardan depo robotlarına kadar oldukça geniş bir kullanım alanına sahiptir.
``
RL’nin temel modeli Markov Karar Süreci (MDP) ile anlatılır. MDP; durumlar kümesi $S$, eylemler kümesi $A$, geçiş olasılığı $P$, ödül fonksiyonu $R$ ve indirim katsayısı $\gamma$ bileşenlerinden oluşur. Ajanın politikası $\pi(a \vert s)$, belirli bir $s$ durumunda $a$ eylemini seçme davranışını temsil eder. Belirsizlik önemlidir: Aynı eylem, farklı zamanlarda çevrenin durumuna göre farklı sonuçlar doğurabilir.
Ajanın takip ettiği temel döngü şöyledir: çevre bir durum $s_t$ sunar; ajan $a_t$ eylemini uygular; ardından $r_t$ ödülünü ve yeni $s_{t+1}$ durumunu gözlemler. Öğrenme hedefi, gelecekteki indirgenmiş ödüllerin toplamını büyütmektir:
\[G_t = \sum_{k=0}^{\infty} \gamma^k r_{t+k+1}\]Burada $0 \leq \gamma < 1$ olan indirim katsayısı, uzak geleceğin ne kadar önemsendiğini belirler. $\gamma$ büyükse ajan daha sabırlıdır; küçükse kısa vadeli ödüllere daha fazla odaklanır. Örneğin bir robot, hemen enerji harcamamak için yerinde kalabilir; fakat hedefe ulaşmanın büyük ödülünü öğrenirse kısa süreli maliyeti göze alabilir.
| Kavram | Anlamı | Oyun örneği |
|---|---|---|
| Durum ($s$) | Çevrenin ajana görünen hâli | Karakterin konumu ve canı |
| Eylem ($a$) | Ajanın seçimi | Sağa gitmek veya zıplamak |
| Ödül ($r$) | Davranışın geri bildirimi | Bölümü geçince +100 puan |
| Politika ($\pi$) | Karar verme stratejisi | Engelde zıplama olasılığı |
| Değer ($V$ veya $Q$) | Gelecekteki getiri tahmini | Bu konumun ne kadar avantajlı olduğu |
RL’yi denetimli öğrenmeden ayıran kritik nokta geri bildirimin biçimidir. Denetimli öğrenmede model, her örnek için doğru etiketi görür. RL’de ise ajan çoğu zaman hangi hamlenin iyi olduğunu ancak sonuçları yaşadıktan sonra anlar. Ayrıca bir ödül, onu doğuran eylemden çok sonra gelebilir. Bu durum ödül atama problemi olarak bilinir.
| Yaklaşım | Eğitim verisi | Öğrenme sinyali | Temel hedef |
|---|---|---|---|
| Denetimli öğrenme | Etiketli örnekler | Tahmin hatası | Doğru etiketi tahmin etmek |
| Denetimsiz öğrenme | Etiketsiz örnekler | Yapı/benzerlik | Gizli örüntü bulmak |
| Pekiştirmeli öğrenme | Etkileşim deneyimleri | Gecikmeli ödül | Uzun vadeli getiriyi artırmak |
Popüler yöntemlerden Q-öğrenme, her durum-eylem çifti için $Q(s,a)$ değerini tahmin eder. Güncelleme kuralı, mevcut tahmini yeni deneyimle yavaşça düzeltir:
# Q-değerini gözlenen deneyime göre güncelle
best_next_q = max(q_table[next_state])
target = reward + gamma * best_next_q
q_table[state][action] += alpha * (target - q_table[state][action])
Bu kodda alpha öğrenme hızıdır; çok büyük olursa ajan her sonuca aşırı tepki verir, çok küçük olursa öğrenme ağırlaşır. best_next_q, ajanın sonraki durumda en iyi davranacağını varsayan tahmindir.
Bir diğer temel gerilim keşif ve sömürü dengesidir. Ajan bildiği en iyi eylemi sürekli seçerse yeni fırsatları kaçırabilir; her seferinde rastgele denerse de ustalaşamaz. $\epsilon$-greedy stratejisi bu soruna pratik bir çözüm getirir: Olasılık $\epsilon$ ile rastgele hareket edilir, aksi durumda en yüksek Q-değerli eylem seçilir.
Gerçek dünyada ödül tasarımı dikkat ister. Robotu yalnızca hız için ödüllendirmek, onun güvenliği tamamen unutmasına yol açabilir. Bu nedenle ödül fonksiyonu hedefi, güvenlik sınırlarını ve istenmeyen kestirmeleri birlikte yansıtmalıdır. İyi kurulmuş bir çevre ve dengeli ödül, deneme-yanılmayı pahalı bir kaostan akıllı bir öğrenme macerasına dönüştürür.
Yorumlar