İçindekiler
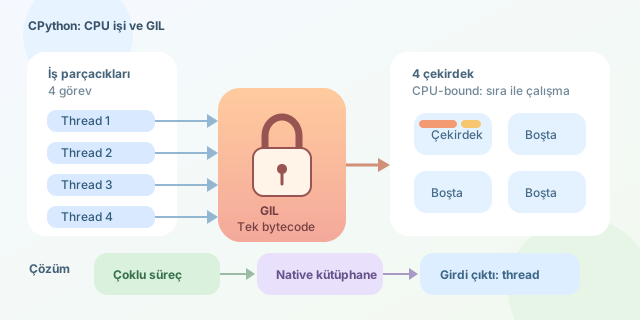
Python’da dört çekirdekli bir işlemciye dört thread verince programın yaklaşık dört kat hızlanmasını beklemek oldukça doğaldır. Ancak yoğun matematiksel hesap yapan kodunuz hızlanmak yerine bazen daha da yavaşlayabilir. Suçlu işlemciniz değil; klasik CPython yorumlayıcısında Python bytecode’unun aynı anda yalnızca bir thread tarafından çalıştırılmasına izin veren Global Interpreter Lock, yani GIL’dir.
``
GIL tam olarak nedir?
GIL, CPython süreçleri içinde bulunan karşılıklı dışlama kilididir. Bir thread Python bytecode’u çalıştırmadan önce bu kilidi edinmek zorundadır. İşletim sistemi thread’leri farklı çekirdeklere dağıtsa bile GIL yüzünden iki thread aynı anda saf Python komutlarını yürütemez.
CPython; nesnelerin ne zaman silineceğini belirlemek için ağırlıklı olarak referans sayımı kullanır. Örneğin bir nesnenin referans sayısını artırmak kabaca paylaşılan bir değerin güncellenmesi demektir. GIL, bu ve benzeri bellek işlemlerini daha basit ve güvenli hâle getirir. Dolayısıyla GIL yalnızca keyfî bir performans freni değil, tarihsel olarak CPython’un bellek modelini ve C eklentilerini kolaylaştıran bir tasarım tercihidir.
İdeal paralel hızlanma yaklaşık olarak
\[S(n)=\frac{T_1}{T_n}\approx n\]şeklinde düşünülebilir. Burada $n$ çekirdek sayısıdır. Fakat GIL altında saf Python CPU işi büyük ölçüde seri kaldığı için $T_n$ beklenen oranda azalmaz. Üstelik thread geçişleri ve kilit rekabeti ek maliyet oluşturur.
CPU-bound ve I/O-bound farkı
| İş yükü | Örnek | Threading sonucu | Daha uygun yaklaşım |
|---|---|---|---|
| CPU-bound | Asal sayı arama, görüntü hesaplama | GIL nedeniyle sınırlı | Çoklu süreç, native kütüphane |
| I/O-bound | Ağ isteği, dosya okuma | Genellikle faydalı | Threading veya asyncio |
| Karma | Veri indirip işleme | Aşamaya göre değişir | Hibrit mimari |
Bir thread ağ yanıtı veya disk işlemi beklerken CPython genellikle GIL’i serbest bırakır. Bu sırada başka bir thread çalışabilir. Bu nedenle GIL, threading’i tamamen işe yaramaz yapmaz; özellikle I/O-bound programlarda gayet kullanışlıdır.
Küçük bir CPU-bound deney
Aşağıdaki örnek, hesaplama işini iki thread arasında paylaştırır:
import threading
import time


def calculate(limit):
    total = 0
    for number in range(limit):
        total += number * number
    return total


def run_threads():
    threads = [
        threading.Thread(target=calculate, args=(8_000_000,))
        for _ in range(2)
    ]

    start = time.perf_counter()
    for thread in threads:
        thread.start()
    for thread in threads:
        thread.join()

    print(f"Süre: {time.perf_counter() - start:.2f} saniye")


run_threads()
Her thread ayrı bir hesaplama yapar; fakat döngüler saf Python bytecode’u çalıştırdığı için GIL’i sırayla alırlar. Sonuç olarak gerçek CPU paralelliği oluşmaz. Ölçüm donanıma göre değişse de iki thread’in tek thread’den iki kat hızlı olması beklenmemelidir.
Çözüm: Süreçlerle gerçek paralellik
multiprocessing, her worker için ayrı bir Python süreci ve dolayısıyla ayrı bir GIL oluşturur:
from concurrent.futures import ProcessPoolExecutor


def calculate(limit):
    return sum(number * number for number in range(limit))


if __name__ == "__main__":
    jobs = [8_000_000] * 4
    with ProcessPoolExecutor() as executor:
        results = list(executor.map(calculate, jobs))
    print(results)
Bu yaklaşım birden fazla çekirdeği gerçekten kullanabilir. Buna karşılık süreç başlatma, verileri serileştirme ve süreçler arasında taşıma maliyeti vardır. Çok küçük görevlerde bu maliyet kazanımdan büyük olabilir; işleri yeterince büyük parçalara bölmek önemlidir.
NumPy gibi bazı native kütüphaneler ağır hesaplamalar sırasında GIL’i bırakabilir. Böylece Python thread’leri dolaylı olarak paralel çalışabilir. Ayrıca modern Python sürümlerinde GIL’siz, free-threaded CPython derlemeleri geliştirilmektedir; ancak eklenti uyumluluğu ve tek thread performansı gibi ödünler hâlâ değerlendirilmelidir.
Kısacası thread sayısını artırmak otomatik olarak CPU gücünü artırmaz. Saf Python hesaplarında süreçleri, GIL’i bırakan native kütüphaneleri veya uygun derleyici çözümlerini tercih edin; bekleme ağırlıklı görevlerdeyse thread’leri gönül rahatlığıyla sahaya sürün.
Yorumlar