İçindekiler
Bir dizinin ortancasını bulmak için akla gelen ilk yöntem diziyi sıralamaktır. Ancak yalnızca belirli bir sıradaki elemanla ilgileniyorsak bütün diziyi sıralamak, tek bir kitabı bulmak için kütüphanenin tamamını yeniden dizmeye benzer. Quickselect algoritması, Quick Sort’un bölümleme fikrini kullanarak diziyi tamamen sıralamadan ortalama $O(n)$ zamanda k. en küçük elemanı bulur. ``
Sıra istatistiği nedir?
Bir dizinin küçükten büyüğe sıralanmış hâlindeki belirli konumlara sıra istatistikleri denir. En küçük eleman birinci, en büyük eleman n. sıra istatistiğidir. Ortanca da merkezi sıra istatistiğidir.
$n$ tekse ortancanın sıfır tabanlı indeksi şöyledir:
\[k = \lfloor n / 2 \rfloor\]$n$ çiftse istatistiksel ortanca, ortadaki iki elemanın aritmetik ortalamasıdır:
\[\text{medyan} = \frac{x_{n/2-1} + x_{n/2}}{2}\]Burada önemli bir ayrıntı bulunur: Günlük dilde “k. en küçük” ifadesinde saymaya 1’den başlanır; Python dizilerinde ise indeksler 0’dan başlar. Dolayısıyla kullanıcı 3. en küçük elemanı istediğinde algoritmaya $k=2$ verilmelidir.
| İstenen değer | Sıralanmış dizideki konum | Sıfır tabanlı indeks |
|---|---|---|
| En küçük | 1 | 0 |
| 3. en küçük | 3 | 2 |
| En büyük | n | n-1 |
| Tek uzunlukta ortanca | $(n+1)/2$ | $\lfloor n/2 \rfloor$ |
Quickselect nasıl çalışır?
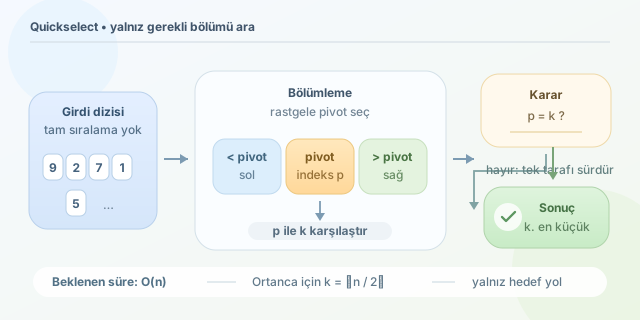
Algoritma bir pivot seçer ve diziyi pivot değerinden küçük, eşit ve büyük elemanlar olarak düşünür. Bölümleme tamamlandığında pivot nihai sıralı konumuna yerleşmiş olur. Pivotun indeksi aranan $k$ indeksine eşitse işlem biter. Pivot fazla soldaysa yalnızca sağ bölümde, fazla sağdaysa yalnızca sol bölümde arama sürdürülür.
Quick Sort iki tarafı da işlerken Quickselect sadece gerekli tarafı işler. Hız kazancı tam olarak buradan gelir.
| Özellik | Tam sıralama | Quickselect |
|---|---|---|
| Ortalama süre | $O(n \log n)$ | $O(n)$ |
| En kötü süre | Genellikle $O(n \log n)$ | $O(n^2)$ |
| Tüm sıralı dizi | Evet | Hayır |
| Tek sıra istatistiği | Gereğinden pahalı olabilir | Çok uygundur |
Python uygulaması
Aşağıdaki uygulama, kötü pivot seçimlerinin olasılığını azaltmak için rastgele bir elemanı sona taşıyor. Ardından Lomuto bölümleme yöntemiyle pivotun doğru indeksini buluyor.
import random

def partition(values, left, right):
    pivot_index = random.randint(left, right)
    values[pivot_index], values[right] = values[right], values[pivot_index]
    pivot = values[right]

    store = left
    for index in range(left, right):
        if values[index] < pivot:
            values[store], values[index] = values[index], values[store]
            store += 1

    values[store], values[right] = values[right], values[store]
    return store


def quickselect(values, k):
    if not 0 <= k < len(values):
        raise IndexError("k geçerli bir indeks olmalıdır")

    left, right = 0, len(values) - 1
    while left <= right:
        pivot_index = partition(values, left, right)

        if pivot_index == k:
            return values[pivot_index]
        if pivot_index < k:
            left = pivot_index + 1
        else:
            right = pivot_index - 1
Örneğin quickselect([9, 2, 7, 1, 5], 2) çağrısı 5 döndürür. Fonksiyon diziyi yerinde değiştirdiği için özgün sıralama korunacaksa quickselect(values.copy(), k) kullanılmalıdır.
Karmaşıklığın arkasındaki fikir
Dengeli pivotlar seçildiğinde incelenen eleman sayısı yaklaşık olarak şu seriyi oluşturur:
\[T(n) = n + \frac{n}{2} + \frac{n}{4} + \cdots < 2n\]Bu nedenle beklenen zaman karmaşıklığı $O(n)$ olur. Buna karşılık pivot sürekli en küçük veya en büyük eleman seçilirse $n+(n-1)+\cdots+1$ işlem oluşur ve sonuç $O(n^2)$ seviyesine çıkar. Rastgele pivot pratikte bu talihsiz senaryoyu oldukça düşük olasılıklı hâle getirir.
Quickselect; büyük veri kümelerinde yüzdelik dilim, ortanca, liderlik sırası ve eşik değeri hesaplamak için güçlü bir araçtır. Tüm sıralamaya ihtiyacınız yoksa algoritmik valizinize koymaya kesinlikle değer.
Yorumlar