İçindekiler
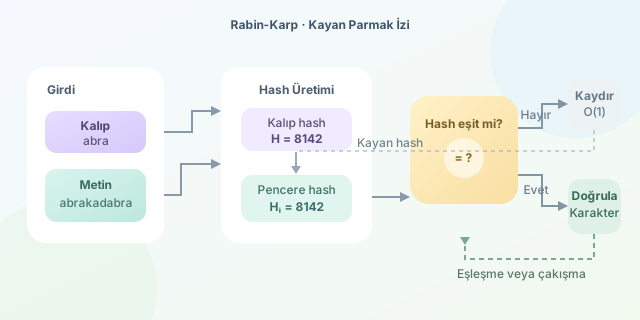
Uzun bir metnin içinde belirli bir kelimeyi aramak, samanlıkta iğne bulmaya benzeyebilir. Her konumu karakter karakter karşılaştırmak mümkün olsa da Rabin-Karp algoritması daha yaratıcı davranır: Kalıbı ve metin parçalarını sayısal birer parmak izine dönüştürür. Parmak izleri farklıysa ayrıntılara bakmadan yoluna devam eder; aynıysa gerçek karakterleri kontrol eder.
``
Temel fikir: Metinleri sayıya çevirmek
Elimizde uzunluğu $n$ olan bir metin ve uzunluğu $m$ olan bir kalıp bulunsun. Saf yaklaşım, metindeki her olası başlangıç noktasında en fazla $m$ karakter karşılaştırır. Bunun en kötü durumdaki maliyeti yaklaşık $O((n-m+1)m)$ olur.
Rabin-Karp ise her uzunluk-$m$ metin penceresi için bir hash değeri hesaplar. Kalıbın hash değeri pencereninkiyle uyuşmuyorsa o konum anında elenir. Hash değerleri eşitse olası bir eşleşme vardır; ancak çakışma ihtimali nedeniyle karakterler ayrıca karşılaştırılır.
| Özellik | Saf arama | Rabin-Karp |
|---|---|---|
| Karşılaştırma biçimi | Karakter karakter | Önce hash, sonra gerekirse karakter |
| Ortalama süre | $O(nm)$ yaklaşabilir | $O(n+m)$ |
| En kötü süre | $O(nm)$ | $O(nm)$ |
| Ek avantaj | Basit uygulama | Birden fazla kalıbı aramaya uygun |
| Risk | Gereksiz karşılaştırmalar | Hash çakışmaları |
Polynomial rolling hash
Yaygın yaklaşımda karakterler, bir tabanın kuvvetleri kullanılarak sayısallaştırılır. Bir $s$ dizisinin hash değeri şöyle düşünülebilir:
\[H(s)=(s_0d^{m-1}+s_1d^{m-2}+\cdots+s_{m-1}) \bmod q\]Burada $d$ alfabenin büyüklüğünü temsil eden taban, $q$ ise değerleri sınırlayan ve genellikle asal seçilen modüldür. Büyük bir asal sayı kullanmak çakışma ihtimalini azaltır.
Algoritmanın asıl numarası rolling hash, yani kayan hash tekniğidir. Pencere bir karakter sağa kaydığında hash baştan hesaplanmaz. Soldan çıkan karakterin katkısı çıkarılır, kalan değer tabanla çarpılır ve sağdan giren karakter eklenir:
\[H_{i+1}=((H_i-t_i h)d+t_{i+m}) \bmod q\]Burada $h=d^{m-1} \bmod q$ değeridir. Böylece her yeni pencerenin parmak izi ortalama $O(1)$ zamanda üretilir.
Python ile uygulama
Aşağıdaki fonksiyon eşleşmelerin başladığı indisleri döndürür:
def rabin_karp(text, pattern, base=256, mod=1_000_003):
    n, m = len(text), len(pattern)
    if m == 0 or m > n:
        return []

    high = pow(base, m - 1, mod)
    pattern_hash = 0
    window_hash = 0

    for i in range(m):
        pattern_hash = (pattern_hash * base + ord(pattern[i])) % mod
        window_hash = (window_hash * base + ord(text[i])) % mod

    matches = []
    for start in range(n - m + 1):
        if pattern_hash == window_hash:
            if text[start:start + m] == pattern:
                matches.append(start)

        if start < n - m:
            outgoing = ord(text[start]) * high
            window_hash = (window_hash - outgoing) % mod
            window_hash = (window_hash * base + ord(text[start + m])) % mod

    return matches

print(rabin_karp('abrakadabra', 'abra'))  # [0, 7]
ord karakterleri tam sayıya dönüştürür. high, pencereden çıkacak karakterin en yüksek basamaktaki etkisini hesaplar. Hash eşitliği yalnızca aday konumu belirler; dilim karşılaştırması gerçek eşleşmeyi doğrular.
Neden olasılıksal deniyor?
İki farklı metin aynı hash değerine sahip olabilir. Buna hash çakışması denir. Modül $q$ iyi seçilmişse kaba bir sezgiyle çakışma olasılığı yaklaşık $1/q$ mertebesindedir. Yine de algoritma doğrulamayı atlamadığı için sonuçları hatalı olmaz; çakışmalar yalnızca çalışma süresini kötüleştirebilir.
Çakışma riskini daha da azaltmak için iki farklı modülle çift hash kullanılabilir. Rabin-Karp özellikle intihal tespiti, DNA dizisi arama, spam filtreleme ve çok sayıda kalıbı aynı metinde bulma senaryolarında güçlüdür. Kısacası algoritma önce parmak izine bakar, şüpheli bulursa kimlik kontrolü yapar!
Yorumlar