İçindekiler
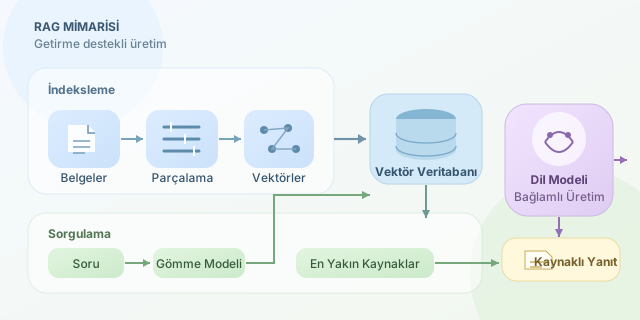
Büyük dil modelleri etkileyici yanıtlar üretir; ancak eğitim verileri güncel olmayabilir, kurumsal belgeleri bilmeyebilir ve bazen son derece özgüvenli biçimde yanlış bilgi verebilir. RAG (Retrieval Augmented Generation), modeli yeniden eğitmeden ona ilgili kaynakları sağlayarak bu sorunları azaltan bir mimaridir. Kısacası RAG, sınava yalnızca hafızasıyla giren bir öğrenciye açık kitap hakkı vermeye benzer.
``
RAG tam olarak nedir?
RAG, Türkçede getirme destekli üretim olarak adlandırılabilir. Sistem önce kullanıcının sorusuyla ilişkili belgeleri bulur, ardından bu belgeleri dil modelinin bağlamına ekler. Model de yanıtını yalnızca genel bilgisinden değil, getirilen kaynaklardan yararlanarak oluşturur.
Klasik bir dil modeli kabaca şu olasılığı hesaplar:
\[P(y\mid x)\]Burada $x$ kullanıcının sorusu, $y$ ise üretilecek yanıttır. RAG kullanıldığında denkleme getirilen belgeler $D$ de katılır:
\[P(y\mid x, D)\]Amaç, doğru belge kümesini bularak yanıtın doğruluğunu ve izlenebilirliğini artırmaktır. Elbette belge vermek modeli sihirli biçimde hatasız yapmaz; kötü kaynak içeri girerse kötü yanıt dışarı çıkabilir.
Mimarinin temel aşamaları
RAG sistemi genellikle iki ana süreçten oluşur: indeksleme ve sorgulama.
- PDF, web sayfası veya şirket dokümanı gibi kaynaklar toplanır.
- Uzun metinler,
chunkadı verilen küçük parçalara ayrılır. - Her parça bir embedding modeliyle sayısal vektöre dönüştürülür.
- Vektörler bir vektör veritabanına kaydedilir.
- Kullanıcı sorusu da aynı yöntemle vektörleştirilir.
- Soruya en yakın parçalar bulunup modele gönderilir.
- Model, kaynaklara dayanan nihai yanıtı üretir.
İki vektörün benzerliği çoğunlukla kosinüs benzerliğiyle ölçülür:
\[\operatorname{sim}(a,b)=\frac{a\cdot b}{\\vert a\\vert \\vert b\\vert }\]Sonuç 1’e yaklaştıkça metinlerin anlamsal olarak daha benzer olduğu kabul edilir.
| Yaklaşım | Avantaj | Dezavantaj |
|---|---|---|
| Yalnızca LLM | Basit ve hızlı kurulum | Güncellik ve halüsinasyon sorunu |
| Fine-tuning | Üslup ve görev davranışı değiştirilebilir | Bilgiyi güncellemek pahalıdır |
| RAG | Güncel, kaynaklı ve denetlenebilir bilgi | Arama kalitesine bağımlıdır |
Basitleştirilmiş Python örneği
Aşağıdaki örnek, belge vektörleriyle soru vektörü arasındaki benzerliği hesaplayarak en uygun iki kaynağı seçer. Gerçek projelerde embedding üretimi için bir model, saklama içinse Qdrant, Weaviate, Pinecone veya pgvector kullanılabilir.
import numpy as np

belgeler = [
    {"metin": "RAG, harici kaynakları modele bağlar.",
     "vektor": np.array([0.9, 0.2, 0.1])},
    {"metin": "Fine-tuning model davranışını özelleştirir.",
     "vektor": np.array([0.2, 0.8, 0.3])},
    {"metin": "Vektör veritabanları benzerlik araması yapar.",
     "vektor": np.array([0.8, 0.3, 0.2])}
]

soru_vektoru = np.array([0.85, 0.25, 0.15])

def kosinus(a, b):
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))

sirali = sorted(
    belgeler,
    key=lambda belge: kosinus(soru_vektoru, belge["vektor"]),
    reverse=True
)

kaynaklar = [belge["metin"] for belge in sirali[:2]]
prompt = f"Kaynaklara dayanarak yanıtla:\n{kaynaklar}"
print(prompt)
Bu kod henüz bir LLM çağırmaz; RAG zincirinin retrieval bölümünü görünür hâle getirir. Seçilen metinler daha sonra sistem talimatı ve kullanıcı sorusuyla birlikte modele gönderilir.
İyi bir RAG için kritik kararlar
Parça boyutu çok küçükse anlam kopar; çok büyükse gereksiz içerik bağlam penceresini doldurur. Top-k değeri düşükse önemli kaynak kaçabilir, yüksekse gürültü artar. Metadata filtreleme, anahtar kelime ve vektör aramasını birleştiren hibrit arama, yeniden sıralama ve kaynak gösterimi kaliteyi belirgin biçimde yükseltir.
Ayrıca başarı yalnızca yanıtın güzel görünmesiyle ölçülmemelidir. Getirilen parçaların soruyla ilgisi, yanıtın kaynaklara sadakati, gecikme ve maliyet ayrı ayrı izlenmelidir. İyi tasarlanmış bir RAG, modele dev bir hafıza eklemekten çok, doğru anda doğru kitabın doğru sayfasını açan akıllı bir kütüphaneci kazandırır.
Yorumlar