İçindekiler
Bir uygulama büyüdükçe veritabanındaki iş yükü de büyür. Ürün listeleme, profil görüntüleme ve raporlama gibi okuma işlemleri çoğalırken sipariş oluşturma gibi yazma işlemleri genellikle daha düşük oranda kalır. Tek veritabanını daha güçlü bir sunucuya taşımak bir süre işe yarasa da sonsuza kadar RAM ekleyemeyiz. Read replica mimarisi, okuma trafiğini birden fazla veritabanı kopyasına dağıtarak bu darboğazı aşmayı hedefler.
``
Read replica nedir?
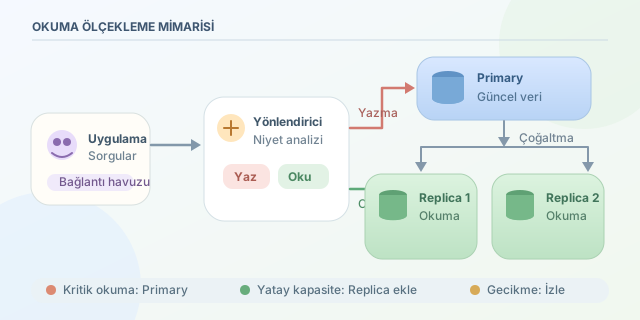
Mimarinin merkezinde yazma işlemlerini kabul eden primary veritabanı bulunur. Primary üzerinde gerçekleşen değişiklikler çoğaltma mekanizmasıyla replica adı verilen sunuculara aktarılır. Uygulama INSERT, UPDATE ve DELETE sorgularını primary’ye; uygun SELECT sorgularını ise replica’lara gönderir.
Üç replica bulunduğunu ve her birinin saniyede yaklaşık $R$ okuma işleyebildiğini varsayalım. İdeal koşullardaki teorik kapasite şöyledir:
\[R_{toplam} \approx n \times R\]Burada $n$ replica sayısıdır. Gerçekte ağ gecikmesi, sorgu türleri ve bağlantı havuzu nedeniyle verim doğrusal artmayabilir. Yani üç replica her zaman tam üç kat performans sağlamaz; fakat doğru iş yükünde ciddi rahatlama getirir.
| Özellik | Primary | Read replica |
|---|---|---|
| Yazma kabul eder | Evet | Genellikle hayır |
| Güncel verinin kaynağıdır | Evet | Primary’yi takip eder |
| Okuma trafiği taşır | Evet | Evet |
| Yatay ölçeklenebilir | Sınırlı | Yeni replica eklenebilir |
| Tutarlılık | En güncel veri | Gecikmeli olabilir |
Çoğaltma ve replica lag
Çoğaltma senkron veya asenkron yapılabilir. Senkron modelde primary, işlem tamamlanmadan önce replica onayı bekleyebilir. Veri kaybı riski azalır ancak yazma gecikmesi yükselir. Asenkron modelde primary beklemez; performans iyidir fakat replica birkaç milisaniye veya saniye geriden gelebilir.
Bu fark replica lag olarak adlandırılır:
\[L = T_{replica} - T_{primary}\]Bir kullanıcı profilini güncelledikten hemen sonra replica’dan okursa eski profilini görebilir. Bu durum eventual consistency, yani nihai tutarlılık yaklaşımının doğal sonucudur. “Yazdığını hemen oku” gereken akışlar primary’ye yönlendirilmelidir.
Uygulama seviyesinde yönlendirme
Aşağıdaki Python örneği sorgu niyetine göre bağlantı seçen basit bir yaklaşım gösterir:
import random

primary = DatabaseConnection("primary-db")
replicas = [
    DatabaseConnection("replica-1"),
    DatabaseConnection("replica-2")
]

def execute(query, params=None, consistent=False):
    is_read = query.lstrip().upper().startswith("SELECT")

    if is_read and not consistent:
        connection = random.choice(replicas)
    else:
        connection = primary

    return connection.execute(query, params)
consistent=True seçeneği kritik okumaları primary’ye yollar. Gerçek projelerde yalnızca sorgunun SELECT ile başlamasına güvenmek yerine ORM yönlendiricileri, ayrı repository sınıfları veya veritabanı proxy’leri kullanılmalıdır. Transaction içindeki tüm sorguların aynı bağlantıda kalması da önemlidir.
Yük dengeleme stratejileri
| Strateji | Avantaj | Dezavantaj |
|---|---|---|
| Round-robin | Basit ve dengeli | Sunucu gücünü dikkate almaz |
| Ağırlıklı dağıtım | Güçlü replica daha çok iş alır | Ayar gerektirir |
| En az bağlantı | Anlık yüke uyum sağlar | Ek ölçüm maliyeti vardır |
| Gecikmeye göre seçim | Hızlı replica’yı öne çıkarır | İzleme sistemi gerektirir |
Replica sayısını artırmak kötü sorguları sihirli biçimde düzeltmez. Eksik indeksler, gereksiz SELECT * kullanımı ve N+1 sorguları her kopyada kaynak tüketmeye devam eder. Önce sorgular optimize edilmeli, ardından çoğaltma yapılmalıdır.
Operasyonel dikkat noktaları
Replica lag, bağlantı sayısı, CPU, disk I/O ve hata oranı sürekli izlenmelidir. Bir replica gecikme eşiğini aşarsa yük dengeleyiciden geçici olarak çıkarılabilir. Ayrıca replica, otomatik olarak yedekleme anlamına gelmez: yanlışlıkla silinen veri çoğaltma yoluyla diğer sunuculardan da silinebilir. Ayrı ve geri yüklemesi test edilmiş yedekler şarttır.
Kısacası read replica, okuma ağırlıklı sistemlerde yatay ölçeklemenin güçlü bir aracıdır. Başarılı bir tasarım; doğru sorgu yönlendirmesini, tutarlılık beklentilerini, gecikme takibini ve arıza senaryolarını birlikte ele alır. Yoksa veritabanı korosu büyür, fakat herkes şarkıyı farklı zamanda söylemeye başlar!
Yorumlar