İçindekiler
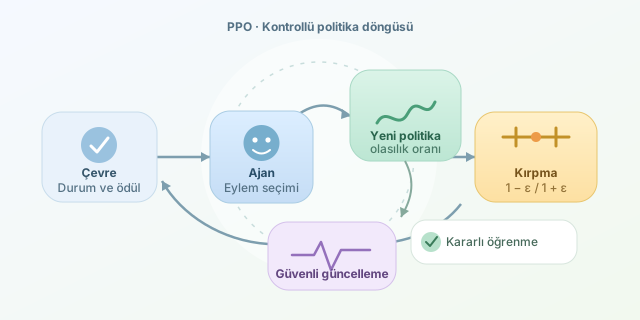
Bir robotun yürümeyi öğrendiğini düşünün. İlk denemelerinde düşmesi normaldir; ancak sonunda iki adım atmayı başardığında bütün hareket politikasını bir anda değiştirmesi pek akıllıca olmaz. Belki üçüncü adımı atayım derken yeniden takla atacaktır! Proximal Policy Optimization, yani PPO, bir ajanın politikasını geliştirirken bu tür aşırı güncellemeleri sınırlayan popüler bir reinforcement learning algoritmasıdır.
``
Önce politika ne demek?
Reinforcement learning sürecinde ajan, çevrenin $s_t$ durumunu gözlemler, $a_t$ eylemini seçer ve $r_t$ ödülünü alır. Politika olarak adlandırılan $π_θ(a\vert s)$ fonksiyonu, belirli bir durumda eylemlerin seçilme olasılıklarını üretir. Buradaki $θ$, sinir ağının öğrenilebilir parametreleridir.
Amaç, gelecekte toplanacak indirgenmiş ödülü büyütmektir:
\[G_t = r_t + γr_{t+1} + γ^2r_{t+2} + \dots\]$γ$ indirim katsayısıdır. Değer 1’e yaklaştıkça ajan uzun vadeli ödüllere daha fazla önem verir.
Politika gradyanı yöntemleri, iyi sonuçlanan eylemlerin olasılığını artırır. Fakat büyük bir gradyan adımı, işe yarayan eski davranışları bir anda bozabilir. PPO’nun temel fikri şudur: Öğren, fakat yeni politikan eskisinden aşırı uzaklaşmasın.
PPO’nun kırpma mekanizması
PPO, güncel politika ile veriyi üretmiş eski politika arasındaki olasılık oranını hesaplar:
\[r_t(θ) = π_θ(a_t\vert s_t) / π_{θ_{old}}(a_t\vert s_t)\]Bu oran 1 civarındaysa iki politika benzer davranıyor demektir. Örneğin 1.8 değeri, seçilen eylemin yeni politika tarafından eskisine göre çok daha olası hâle getirildiğini gösterir. PPO, oranı $1-ε$ ile $1+ε$ aralığında kırpar:
\[L^{CLIP}(θ)=E_t[min(r_t(θ)A_t, clip(r_t(θ),1-ε,1+ε)A_t)]\]$A_t$, eylemin beklenenden ne kadar iyi veya kötü olduğunu belirten avantaj tahminidir. $ε$ çoğunlukla 0.1 ya da 0.2 seçilir. min işlemi sayesinde model, politikayı fazla değiştirerek yapay biçimde büyük kazanç elde edemez.
| Yaklaşım | Güncelleme davranışı | Olası sonuç |
|---|---|---|
| Standart policy gradient | Adım boyutu doğrudan gradyana bağlıdır | Kararsız ve yıkıcı güncellemeler |
| TRPO | Güvenli bölgeyi matematiksel kısıtla korur | Güçlü fakat karmaşık hesaplama |
| PPO | Olasılık oranını kırpar | Basit, hızlı ve genellikle kararlı |
Avantaj nasıl hesaplanır?
PPO çoğunlukla Generalized Advantage Estimation kullanır. Önce temporal difference hatası bulunur:
\[δ_t = r_t + γV(s_{t+1}) - V(s_t)\]Ardından hatalar $λ$ parametresiyle birleştirilir. Küçük $λ$ daha düşük varyans, büyük $λ$ ise daha düşük yanlılık sağlar.
| $λ$ değeri | Avantaj | Dezavantaj |
|---|---|---|
| 0’a yakın | Daha istikrarlı tahmin | Daha yüksek yanlılık |
| 1’e yakın | Gerçek getiriye daha yakın | Daha yüksek varyans |
PyTorch ile kırpılmış kayıp
Aşağıdaki kod, PPO politika kaybının özünü gösterir:
import torch

def ppo_policy_loss(new_log_prob, old_log_prob, advantage, epsilon=0.2):
    # Logaritmik olasılık farkını normal olasılık oranına çevirir.
    ratio = torch.exp(new_log_prob - old_log_prob)

    normal_objective = ratio * advantage
    clipped_ratio = torch.clamp(ratio, 1 - epsilon, 1 + epsilon)
    safe_objective = clipped_ratio * advantage

    # Optimizatör kaybı küçülttüğü için sonucu negatif döndürüyoruz.
    return -torch.min(normal_objective, safe_objective).mean()
Gerçek uygulamada bu kayba değer fonksiyonu hatası ve keşfi destekleyen entropi bonusu da eklenir. Ajan çevreden bir deneyim grubu toplar, avantajları hesaplar ve aynı veri üzerinde birkaç mini-batch güncellemesi yapar.
Neden bu kadar popüler?
PPO; robotik kontrol, oyun ajanları ve büyük dil modellerinin insan geri bildirimiyle hizalanması gibi alanlarda kullanılır. Başarısının sırrı, kusursuz bir garanti sunması değil; performans, sadelik ve kararlılık arasında pratik bir denge kurmasıdır. Kısacası PPO ajana, “Daha iyi olabilirsin ama bildiklerini bir gecede çöpe atma” der. Öğrenmenin bazen en hızlı yolu, kontrollü ve güvenli adımlar atmaktır.
Yorumlar