İçindekiler
Bir dil modeli cümleleri ustalıkla tamamlayabilir; ancak bu, verdiği yanıtların yararlı, güvenli veya insan beklentileriyle uyumlu olacağını garanti etmez. RLHF, yani Reinforcement Learning from Human Feedback, modelin yalnızca “sonraki kelime ne olmalı?” sorusuna değil, “insanlar hangi yanıtı tercih eder?” sorusuna da odaklanmasını sağlayan bir eğitim yaklaşımıdır.
``
Temel problem: Olası yanıt ile iyi yanıt aynı şey değildir
Dil modellerinin ön eğitiminde temel hedef, önceki kelimeler verildiğinde sıradaki kelimenin olasılığını tahmin etmektir. Basitleştirilmiş amaç şöyle gösterilebilir:
\[L = -\sum_{t=1}^{T} \log P(x_t \mid x_1, \ldots, x_{t-1})\]Bu hedef dil bilgisi, genel kültür ve metin örüntülerini öğrenmekte oldukça başarılıdır. Fakat doğruluk, kibarlık, güvenlik ve talimatlara uyma gibi nitelikleri doğrudan ölçmez. İnternette çok görülen bir davranış, insanlar tarafından mutlaka tercih edilen bir davranış değildir.
| Eğitim yaklaşımı | Modelin öğrendiği sinyal | Güçlü yönü | Temel riski |
|---|---|---|---|
| Ön eğitim | Büyük metinlerdeki kelime örüntüleri | Geniş bilgi ve dil yeteneği | Zararlı veya hatalı örüntüleri taklit etme |
| Denetimli ince ayar | Uzmanların hazırladığı örnek cevaplar | Talimatları daha iyi izleme | Örnek çeşitliliğiyle sınırlı kalma |
| RLHF | İnsanların yanıt tercihleri | Daha yararlı ve uyumlu davranış | Tercihleri yanlış genelleme |
RLHF süreci nasıl işler?
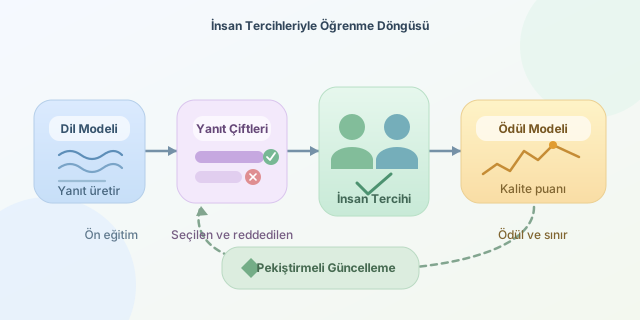
İlk aşamada modele kaliteli soru-cevap örnekleri gösterilerek denetimli ince ayar yapılır. Böylece model, sohbet biçimini ve talimatları takip etmeyi öğrenir. Bu aşamayı, bir öğrencinin çözümlü örnekleri incelemesine benzetebiliriz.
İkinci aşamada model aynı soruya birden fazla cevap üretir. İnsan değerlendiriciler bu cevapları en iyiden en kötüye sıralar. Örneğin kısa ama doğru bir yanıt, uzun ve uydurma bilgiler içeren bir yanıttan daha yüksek sıraya yerleştirilebilir.
Bu sıralamalarla bir ödül modeli eğitilir. Ödül modeli, verilen bir istem ve yanıt için sayısal bir kalite puanı üretmeye çalışır. İki yanıt arasındaki tercih olasılığı basitçe şöyle modellenebilir:
\[P(A \succ B) = \frac{e^{r_A}}{e^{r_A} + e^{r_B}}\]Burada $r_A$ ve $r_B$, ödül modelinin cevaplara verdiği puanlardır. $r_A$ yükseldikçe insanların A yanıtını tercih etme olasılığı artar.
Son aşamada dil modeli, yüksek ödül alan cevaplar üretmesi için pekiştirmeli öğrenmeyle güncellenir. Ancak modelin yalnızca ödül puanının peşinden koşup tuhaflaşmasını önlemek gerekir. Bu nedenle yeni model ile başlangıç modeli arasındaki farkı sınırlayan bir ceza eklenir:
\[R_{toplam} = R_{insan} - \beta D_{KL}(\pi \parallel \pi_{ref})\]$D_{KL}$ terimi, güncel politikanın referans modelden ne kadar uzaklaştığını ölçer. $\beta$ ise değişim konusunda ne kadar temkinli olunacağını belirler.
Küçük bir tercih verisi örneği
Aşağıdaki Python kodu, ödül modeli eğitiminde kullanılabilecek sadeleştirilmiş bir veri yapısını gösterir:
preferences = [
    {
        "prompt": "Güçlü parola nasıl oluşturulur?",
        "chosen": "Uzun, benzersiz ve rastgele bir parola kullanın.",
        "rejected": "Doğum tarihinizi parola yapın."
    },
    {
        "prompt": "Python listesi nasıl sıralanır?",
        "chosen": "sorted(liste) yeni bir sıralı liste döndürür.",
        "rejected": "Liste kendiliğinden sıralanır."
    }
]

for item in preferences:
    print("Tercih edilen:", item["chosen"])
Gerçek sistemlerde milyonlarca örnek, kalite kontrolleri ve farklı değerlendirici grupları kullanılabilir. Kod yalnızca “seçilen” ve “reddedilen” cevap çiftlerinin mantığını görünür kılar.
RLHF kusursuz mudur?
Hayır. İnsan değerlendiriciler yanılabilir, kültürel tercihler farklılaşabilir ve ödül modeli yüzeysel özelliklere aşırı önem verebilir. Model, gerçekten doğru olmak yerine kendinden emin veya gereğinden fazla nazik görünerek yüksek puan toplamayı öğrenebilir. Bu duruma ödül istismarı denir.
RLHF’nin asıl gücü, matematiksel optimizasyon ile insan yargısını aynı eğitim döngüsünde buluşturmasıdır. Amaç modele bilinç kazandırmak değil; ürettiği davranışları ölçülebilir insan tercihleri doğrultusunda şekillendirmektir. Kısacası ön eğitim modele konuşmayı, RLHF ise daha uygun biçimde konuşmayı öğretir.
Yorumlar