Bir cümlenin sonundaki kelimeyi tahmin ederken önceki kelimeleri, yarının hisse fiyatını öngörürken de dünkü hareketleri görmezden gelemezsiniz. Tekrarlayan Sinir Ağları (Recurrent Neural Network, RNN), tam bu noktada devreye girer: Veriyi tek seferlik bağımsız satırlar olarak değil, zaman içinde akan bir hikâye olarak işler. Dil çevirisi, duygu analizi, sensör verisi ve finansal zaman serileri gibi alanlarda RNN’in süper gücü, önceki adımlardan öğrendiği bilgiyi bir sonraki adıma taşıyan gizli durumudur.
``
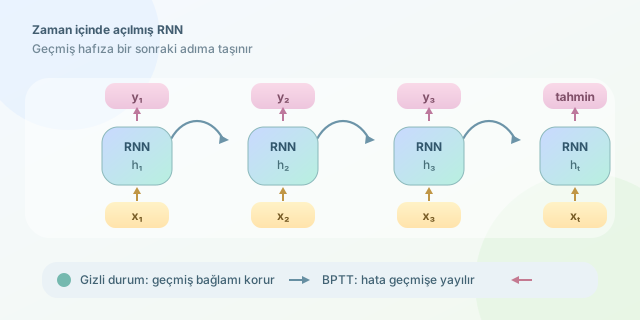
Klasik ileri beslemeli ağlarda her giriş birbirinden bağımsız kabul edilir. Örneğin bir görüntü sınıflandırıcısı, tek resmi inceler ve karar verir. Oysa "Bugün hava çok" ifadesinden sonra gelecek kelimenin "güzel" olma olasılığı, daha önce okunan bağlama bağlıdır. RNN, her zaman adımında hem yeni girdiyi $x_t$ hem de önceki hafızayı $h_{t-1}$ kullanır. Temel hesap şu şekildedir:
Ardından çıktı, bu hafızadan üretilir:
\[y_t = W_{hy}h_t + b_y\]Buradaki $W_{hh}$, ağın geçmişi nasıl taşıyacağını öğrenen ağırlık matrisidir. Eğitim sırasında ağ, zaman boyunca geriye yayılım (BPTT, Backpropagation Through Time) uygular. Yani hata yalnızca bugünkü adıma değil, geçmişteki hafıza kararlarına da dağıtılır. Kulağa zaman yolculuğu gibi geliyor; matematiksel olarak ise gradyanların ardışık çarpımıdır.
| Özellik | İleri Beslemeli Ağ | Temel RNN |
|---|---|---|
| Girdi yaklaşımı | Örnekler bağımsızdır | Sıra ve bağlam korunur |
| Hafıza | Yoktur | Gizli durum $h_t$ vardır |
| Uygun problem | Tablo verisi, tek görüntü | Metin, ses, zaman serisi |
| Temel risk | Özellik mühendisliği ihtiyacı | Kaybolan/patlayan gradyan |
Bir borsa tahmini senaryosunda ağın girdisi, son 30 günün kapanış fiyatları, işlem hacmi veya teknik göstergeleri olabilir. Ancak önemli bir dipnot: RNN fiyatın kesin geleceğini söyleyen sihirli kahin değildir. Finans verisi gürültülüdür, rejim değiştirir ve haberler gibi dış etkiler taşır. Bu yüzden veriyi zaman sırasını bozmadan eğitim-doğrulama-test olarak ayırmak, normalizasyonu yalnızca eğitim kümesinden öğrenmek ve başarıyı basit bir son değeri kopyala modeliyle karşılaştırmak gerekir.
Aşağıdaki Keras örneği, tek değişkenli bir seride sonraki değeri tahmin eden küçük bir RNN kurar. X dizisinin biçimi (örnek, zaman_adımı, özellik) olmalıdır; bu üç boyut, RNN dünyasının giriş bileti gibidir.
import tensorflow as tf
from tensorflow.keras import Sequential
from tensorflow.keras.layers import SimpleRNN, Dense

# X: Son 20 adımdan oluşan pencereler, y: takip eden değer
model = Sequential([
    SimpleRNN(32, activation="tanh", input_shape=(20, 1)),
    Dense(1)
])

model.compile(optimizer="adam", loss="mse")
model.fit(X_train, y_train, validation_data=(X_val, y_val), epochs=30)
prediction = model.predict(X_test)
SimpleRNN(32) katmanı 32 boyutlu bir gizli hafıza üretir; Dense(1) ise tahmin edilen tek sayısal değeri verir. Fiyat tahmininde kayıp olarak ortalama karesel hata sık kullanılır:
Ne var ki temel RNN’ler uzun dizilerde zorlanabilir. Gradyanlar defalarca çarpıldığında $0$’a yaklaşırsa eski bilgi unutulur; aşırı büyürse eğitim kararsızlaşır. LSTM ve GRU mimarileri, kapılar aracılığıyla hangi bilginin tutulacağını, unutulacağını ve dışarı verileceğini öğrenerek bu sorunu azaltır.
| Mimari | Hafıza mekanizması | Ne zaman tercih edilir? |
|---|---|---|
| SimpleRNN | Tek gizli durum | Kısa ve basit diziler |
| GRU | Güncelleme ve sıfırlama kapıları | Hız/başarı dengesi gerektiğinde |
| LSTM | Giriş, unutma, çıkış kapıları | Uzun bağımlılıklar önemliyse |
Özetle RNN, geçmişi modelin içine taşıyarak sıralı veriye zaman duygusu kazandırır. Başarılı bir uygulama için doğru pencere uzunluğu, sızıntısız veri hazırlığı ve güçlü bir temel model karşılaştırması; mimarinin kendisi kadar önemlidir.
Yorumlar