İçindekiler
Bir yapay zekâ modeline milyonlarca kedi fotoğrafı gösterip her birine “Bu bir kedidir” etiketi eklemek oldukça yorucudur. Peki model, etiketleri insanlardan beklemek yerine verinin içindeki ipuçlarından kendisi üretebilseydi? Self-Supervised Learning (öz-denetimli öğrenme), tam olarak bunu yapar: Ham veriyi hem soru hem de cevap anahtarı olarak kullanır.
``
Temel fikir: Veri kendi öğretmenidir
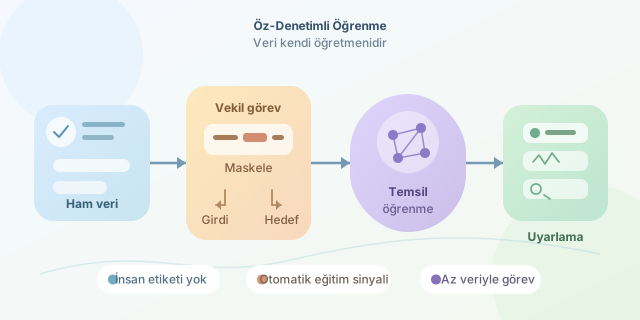
Self-supervised learning, etiketsiz veriden otomatik olarak bir vekil görev (pretext task) oluşturur. Model bu görevi çözerken verinin anlamlı temsillerini öğrenir. Daha sonra öğrenilen temsil; sınıflandırma, nesne tanıma veya duygu analizi gibi gerçek bir hedef göreve uyarlanır.
Bir cümlede bazı kelimeleri gizlediğimizi düşünelim:
“Programcı sabah ilk iş olarak ___ içti.”
Modelden eksik kelimeyi tahmin etmesini isteriz. Buradaki etiket, cümlenin orijinalindeki “kahve” kelimesidir. İnsan ayrıca etiket üretmemiştir; veri, eğitim sinyalini kendi içinden sağlamıştır.
Genel amaç fonksiyonu şöyle gösterilebilir:
\[\theta^* = \arg\min_{\theta} \sum_{i=1}^{N} \mathcal{L}(f_\theta(\tilde{x}_i), y_i(x_i))\]Burada $x_i$ orijinal veri, $\tilde{x}_i$ bozulmuş veya dönüştürülmüş girdi, $y_i(x_i)$ ise veriden otomatik çıkarılan hedeftir. Modelin amacı, $\mathcal{L}$ kaybını azaltarak saklanan bilgiyi tahmin etmektir.
Diğer öğrenme türlerinden farkı
| Yaklaşım | Etiket kaynağı | Örnek görev | İnsan emeği |
|---|---|---|---|
| Denetimli öğrenme | İnsan tarafından hazırlanır | Fotoğraf sınıflandırma | Yüksek |
| Denetimsiz öğrenme | Etiket kullanılmaz | Kümeleme | Düşük |
| Self-supervised öğrenme | Veriden otomatik üretilir | Maskelenen parçayı tahmin etme | Çok düşük |
| Pekiştirmeli öğrenme | Ödül sinyali | Oyun oynama | Ortama bağlı |
Self-supervised yaklaşımı yalnızca “etiketsiz öğrenme” olarak görmek eksik olur. Kritik nokta, model için açık bir tahmin hedefinin otomatik biçimde oluşturulmasıdır.
Başlıca eğitim stratejileri
Maskeli modelleme, girdinin bir bölümünü gizler ve modelden bu bölümü tahmin etmesini ister. BERT kelimelerde, Masked Autoencoder modelleri ise görüntü parçalarında bu yaklaşımı kullanır.
Kontrastif öğrenme, benzer örneklerin temsillerini birbirine yaklaştırırken farklı örnekleri uzaklaştırır. Aynı fotoğrafın kırpılmış iki sürümü pozitif çift kabul edilebilir. Benzerlik çoğunlukla kosinüs ölçümüyle hesaplanır:
\[\operatorname{sim}(u,v)=\frac{u \cdot v}{\lVert u \rVert\lVert v \rVert}\]Otokodlayıcı yöntemler ise girdiyi sıkıştırılmış bir temsile dönüştürüp yeniden oluşturmaya çalışır. Böylece model, gereksiz ayrıntılar yerine temel yapıyı yakalamayı öğrenir.
Küçük bir maskeli öğrenme örneği
Aşağıdaki kod, bir cümlede rastgele seçilen kelimeyi maskeleyerek otomatik eğitim örneği üretir:
import random

def maskele(cumle):
    kelimeler = cumle.split()
    indeks = random.randrange(len(kelimeler))
    hedef = kelimeler[indeks]
    kelimeler[indeks] = "[MASK]"
    return " ".join(kelimeler), hedef

girdi, etiket = maskele("yapay zeka verinin yapısını öğrenir")
print("Girdi:", girdi)
print("Otomatik etiket:", etiket)
Fonksiyon, insan müdahalesi olmadan hem bozulmuş girdiyi hem de doğru cevabı oluşturur. Gerçek sistemlerde aynı mantık milyarlarca metin parçasına, görüntü yamasına veya ses kesitine uygulanır.
Neden bu kadar önemli?
İnternet devasa miktarda etiketsiz metin, görüntü ve ses içerir. Etiketleme pahalı ve yavaştır; ayrıca uzmanlık gerektiren tıp gibi alanlarda daha da zordur. Self-supervised ön eğitim sayesinde model önce genel örüntüleri öğrenir, ardından az miktarda etiketli veriyle belirli bir göreve ince ayar yapılır.
Elbette yöntem kusursuz değildir. Büyük veri kümeleri önyargı, hatalı bilgi ve mahremiyet sorunları taşıyabilir. Eğitim maliyeti de oldukça yüksek olabilir. Yine de self-supervised learning, yapay zekâya her cevabı tek tek söylemek yerine ona verinin içindeki bulmacaları çözmeyi öğretir. Kısacası öğretmen ortadan kaybolmaz; öğretmenin rolünü bizzat veri üstlenir.
Yorumlar