İçindekiler
Devasa bir matristeki elemanların büyük bölümü sıfırsa, bu sıfırları bellekte saklamak biraz boş koltuklarla dolu bir otobüsü şehir turuna çıkarmaya benzer. Seyrek matris gösterimleri yalnızca anlamlı değerleri ve konumlarını saklayarak hem bellek tüketimini hem de matris-vektör çarpımının işlem maliyetini azaltır.
``
Matris neden “seyrek” olur?
Graf bağlantı matrisleri, öneri sistemleri, sonlu eleman analizleri ve doğal dil işleme modelleri çoğunlukla seyrek veri üretir. Örneğin bir sosyal ağda milyonlarca kullanıcı bulunabilir; ancak her kullanıcı yalnızca birkaç yüz kişiyle bağlantılıdır.
Bir $A \in \mathbb{R}^{m \times n}$ matrisi ile $x \in \mathbb{R}^{n}$ vektörünün çarpımı şöyledir:
\[y_i = \sum_{j=1}^{n} A_{ij}x_j\]Yoğun gösterimde her satırdaki bütün sütunlar dolaşılır. Böylece zaman karmaşıklığı $O(mn)$ olur. Oysa yalnızca sıfır olmayan elemanları işlersek maliyet yaklaşık olarak
\[O(\operatorname{nnz}(A))\]seviyesine iner. Buradaki $\operatorname{nnz}(A)$, matrisin sıfır olmayan eleman sayısıdır.
Popüler gösterim biçimleri
| Biçim | Saklanan bilgiler | Güçlü tarafı | Zayıf tarafı |
|---|---|---|---|
| COO | Satır, sütun ve değer üçlüleri | Oluşturması ve güncellemesi kolaydır | Tekrarlı indisler ve ek bellek maliyeti olabilir |
| CSR | Değerler, sütun indisleri, satır başlangıçları | Satır tabanlı çarpım çok hızlıdır | Sütun işlemleri ve ekleme pahalıdır |
| CSC | Değerler, satır indisleri, sütun başlangıçları | Sütun tabanlı işlemler verimlidir | Satır erişimi daha maliyetlidir |
| DOK | Koordinatları anahtar olarak kullanan sözlük | Dinamik eleman eklemek rahattır | Sayısal hesaplamalarda yavaştır |
Matris-vektör çarpımı, yani SpMV, çoğunlukla satırlar üzerinden ilerlediği için CSR biçimi yaygın bir tercihtir.
CSR mantığını parçalarına ayıralım
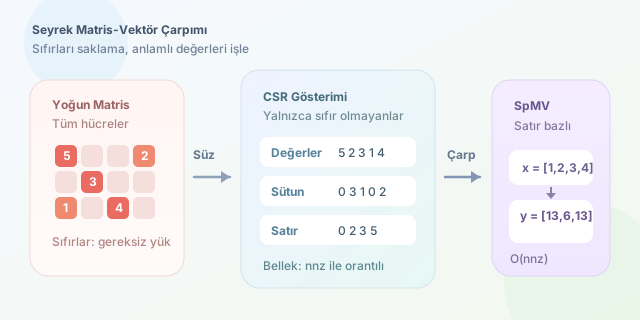
Aşağıdaki matrisi düşünelim:
\[A = \begin{bmatrix} 5 & 0 & 0 & 2 \\ 0 & 3 & 0 & 0 \\ 1 & 0 & 4 & 0 \end{bmatrix}\]CSR gösteriminde üç dizi kullanılır:
values = [5, 2, 3, 1, 4]col_indices = [0, 3, 1, 0, 2]row_ptr = [0, 2, 3, 5]
row_ptr, her satırın values dizisinde nerede başlayıp bittiğini belirtir. Böylece algoritma sıfırların bulunduğu hücrelere hiç uğramaz.
def csr_matvec(values, col_indices, row_ptr, vector):
    rows = len(row_ptr) - 1
    result = [0.0] * rows

    for row in range(rows):
        start = row_ptr[row]
        end = row_ptr[row + 1]

        for k in range(start, end):
            column = col_indices[k]
            result[row] += values[k] * vector[column]

    return result

values = [5, 2, 3, 1, 4]
columns = [0, 3, 1, 0, 2]
row_ptr = [0, 2, 3, 5]
x = [1, 2, 3, 4]

print(csr_matvec(values, columns, row_ptr, x))
# [13.0, 6.0, 13.0]
Kod, her satır için yalnızca ilgili değer aralığını gezer. Örneğin ilk sonuç $5 \cdot 1 + 2 \cdot 4 = 13$ şeklinde hesaplanır.
Bellek kazancı gerçekten büyük mü?
Bir $10{,}000 \times 10{,}000$ matris, 64 bit kayan noktalı sayılarla yoğun biçimde yaklaşık 800 MB yer kaplar. Matrisin yalnızca yüzde biri doluysa bir milyon anlamlı değer vardır. CSR biçiminde değerler ile 32 bit indisler kabaca 12 MB, satır işaretçileri ise yaklaşık 40 KB gerektirir. Ek yapılar hesaba katılsa bile fark dramatiktir.
| Durum | Yoğun matris | Seyrek CSR |
|---|---|---|
| Bellek kullanımı | Tüm hücrelerle orantılı | Sıfır olmayanlarla orantılı |
| Eleman ekleme | Kolay | Genellikle pahalı |
| SpMV performansı | Çok sayıda gereksiz çarpım | Yalnızca anlamlı çarpımlar |
| Önbellek davranışı | Düzenli erişim | İndisler nedeniyle düzensiz olabilir |
Seyrek yapı her zaman otomatik zafer değildir. Matris yeterince doluysa indislerin bellek maliyeti avantajı azaltabilir. Ayrıca SpMV çoğu sistemde işlemciden çok bellek bant genişliğiyle sınırlıdır. Bu nedenle doğru format; matrisin doluluk oranına, erişim yönüne ve güncellenme sıklığına göre seçilmelidir. Kısacası hızın sırrı, sıfırlarla daha hızlı çarpışmak değil, onları tamamen görmezden gelmektir.
Yorumlar