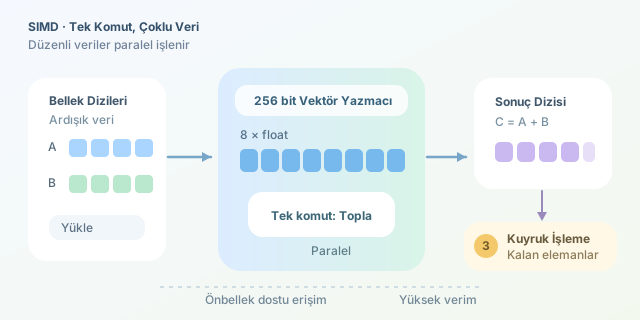
Bir dizideki milyonlarca sayıya aynı işlemi uyguladığınızı düşünün. Geleneksel yaklaşım, elemanları sırayla işlemekken SIMD komutları işlemciye “Bu işlemi tek sayı yerine bir grup sayı üzerinde gerçekleştir” der. Böylece hesaplamalar, süpermarket kasasında tek tek ürün geçirmek yerine bir sepeti aynı anda taramak gibi hızlanabilir. ``
SIMD tam olarak nedir?
SIMD, Single Instruction, Multiple Data ifadesinin kısaltmasıdır: tek komut, çoklu veri. Modern işlemcilerde SSE, AVX, AVX2 ve AVX-512 gibi komut kümeleri SIMD yaklaşımını destekler. ARM dünyasında ise benzer görevleri NEON ve SVE üstlenir.
Normal bir skaler toplama komutu iki sayıyı işler:
\[c_i = a_i + b_i\]SIMD kullanıldığında aynı komut, genişliği $W$ olan bir vektörün elemanlarını paralel işler:
\[\vec{c} = \vec{a} + \vec{b}\]Teorik olarak $N$ eleman için gereken işlem sayısı yaklaşık olarak
\[T_{SIMD} \approx \left\lceil \frac{N}{W} \right\rceil\]olur. Örneğin 256 bitlik bir AVX yazmacı, her biri 32 bit olan sekiz float değerini aynı anda taşıyabilir. Bu, ideal koşullarda döngü başına sekiz eleman demektir. Ancak sekiz kat hız garanti değildir; bellek bant genişliği, önbellek kullanımı ve işlemci mimarisi sonucu etkiler.
| Özellik | Skaler işlem | SIMD işlemi |
|---|---|---|
| Komut başına veri | Genellikle 1 eleman | Birden çok eleman |
| Yazma kolaylığı | Daha kolay | Biraz daha karmaşık |
| Potansiyel hız | Sınırlı | Yüksek |
| Uygun işler | Dallanmalı algoritmalar | Tekrarlanan düzenli hesaplamalar |
| Tipik kullanım | Genel uygulama mantığı | Görüntü, ses, bilimsel hesaplama |
AVX ile küçük bir örnek
Aşağıdaki C fonksiyonu, iki float dizisini AVX kullanarak toplar:
#include <immintrin.h>
#include <stddef.h>

void add_arrays(const float *a, const float *b,
                float *result, size_t n) {
    size_t i = 0;

    for (; i + 8 <= n; i += 8) {
        __m256 va = _mm256_loadu_ps(a + i);
        __m256 vb = _mm256_loadu_ps(b + i);
        __m256 sum = _mm256_add_ps(va, vb);
        _mm256_storeu_ps(result + i, sum);
    }

    for (; i < n; ++i) {
        result[i] = a[i] + b[i];
    }
}
__m256, sekiz adet float taşıyan 256 bitlik bir vektör tipidir. _mm256_loadu_ps verileri bellekte hizalı olma zorunluluğu olmadan yükler. _mm256_add_ps sekiz toplamayı paralel gerçekleştirir; _mm256_storeu_ps ise sonuçları belleğe yazar.
İkinci döngü, eleman sayısı sekizin katı değilse geriye kalan değerleri işler. Bu bölüme tail processing, yani kuyruk işleme denir. Örneğin dizide 19 eleman varsa iki SIMD turunda 16 eleman, skaler döngüde kalan üç eleman hesaplanır.
SIMD her zaman kazandırır mı?
SIMD özellikle aynı işlemin büyük ve ardışık veri bloklarına uygulandığı durumlarda parlar. Görüntü filtreleri, matris işlemleri, ses işleme, fizik simülasyonları ve makine öğrenmesi bunun klasik örnekleridir. Buna karşılık her elemanda farklı bir koşula giren, yoğun dallanma içeren algoritmalar kolayca vektörleştirilemez.
Performansı etkileyen başlıca noktalar şunlardır:
- Verilerin bellekte ardışık tutulması
- Önbellek dostu erişim yapılması
- Gereksiz dallanmalardan kaçınılması
- İşlemcinin desteklediği komut kümesinin kontrol edilmesi
- Derleyicinin optimizasyon seçeneklerinin etkinleştirilmesi
GCC ve Clang gibi derleyiciler -O3 -march=native seçenekleriyle bazı döngüleri otomatik olarak vektörleştirebilir. Buna auto-vectorization denir. Intrinsic fonksiyonlar daha fazla kontrol sağlar, fakat kodu belirli mimarilere bağımlı hâle getirebilir.
SIMD’nin temel fikri şaşırtıcı derecede basittir: veri düzenliyse, aynı işi tekrar tekrar tek başına yapma. Verileri gruplandır, geniş yazmaçlara yükle ve işlemcinin paralel hesaplama kaslarını kullan. En iyi sonuç içinse tahmin etmek yerine ölçmek, profil çıkarmak ve skaler sürümle karşılaştırmak gerekir.
Yorumlar