İçindekiler
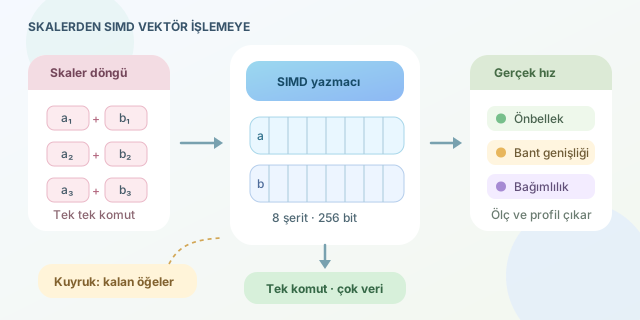
Bir işlemciye aynı toplama komutunu binlerce sayı için tekrarlatmak, kasadaki görevliye ürünleri tek tek uzatmaya benzer. SIMD ise ürünleri banda dizip birkaçını birlikte işleme fikridir. Görüntü işleme, oyun motorları, bilimsel hesaplama ve yapay zekâ gibi alanlarda doğru kullanıldığında ciddi hız kazandırır; ancak “tek komut” ifadesi, bütün işin sihirli biçimde tek saat çevriminde biteceği anlamına gelmez. ``
SIMD tam olarak nedir?
SIMD, Single Instruction, Multiple Data ifadesinin kısaltmasıdır: tek bir komut, birden fazla veri öğesine aynı işlemi uygular. Normal, yani skaler bir toplama şu şekilde düşünülebilir:
\[c_i = a_i + b_i\]SIMD yaklaşımında ise işlemci, öğeleri bir vektör yazmacına paketler:
\[\vec{c} = \vec{a} + \vec{b}\]Bir yazmacın genişliği $W$, her öğenin genişliği de $E$ bit ise aynı anda işlenebilecek teorik öğe sayısı şöyledir:
\[L = \frac{W}{E}\]Örneğin 256 bitlik AVX2 yazmacında 32 bitlik float değerlerden $256/32=8$ tane bulunur. 512 bitlik AVX-512 ise teorik olarak 16 adet float üzerinde birlikte çalışabilir.
| Komut ailesi | Tipik genişlik | Aynı anda float |
Genel durum |
|---|---|---|---|
| SSE | 128 bit | 4 | Eski ama yaygın |
| AVX/AVX2 | 256 bit | 8 | Modern masaüstünde sık görülür |
| AVX-512 | 512 bit | 16 | Sunucu ve bazı işlemcilerde bulunur |
| NEON | 128 bit | 4 | ARM cihazlarda yaygın |
Skaler döngüden vektörlü döngüye
Aşağıdaki C++ örneği iki diziyi AVX2 ile toplar. _mm256_loadu_ps bellekteki sekiz float değerini yükler, _mm256_add_ps bunları toplar ve _mm256_storeu_ps sonucu geri yazar:
#include <immintrin.h>
#include <cstddef>

void add_arrays(const float* a, const float* b,
                float* result, std::size_t count) {
    std::size_t i = 0;

    for (; i + 8 <= count; i += 8) {
        __m256 va = _mm256_loadu_ps(a + i);
        __m256 vb = _mm256_loadu_ps(b + i);
        __m256 sum = _mm256_add_ps(va, vb);
        _mm256_storeu_ps(result + i, sum);
    }

    // Sekizin katı olmayan son elemanları işler.
    for (; i < count; ++i) {
        result[i] = a[i] + b[i];
    }
}
Buradaki ikinci döngü “kuyruk” bölümüdür. Örneğin dizide 19 eleman varsa iki vektör turu 16 elemanı, skaler bölüm ise kalan üç elemanı işler. AVX-512 maskeleme komutları bu tür artıkları ayrıca yönetebilir.
Neden her zaman sekiz kat hızlanmaz?
Teorik hızlanma, ideal koşullarda yaklaşık olarak şerit sayısına yaklaşır:
\[S_{ideal} \approx L\]Gerçekte bellek bant genişliği, önbellek kaçırmaları, komut gecikmeleri ve veri bağımlılıkları devreye girer. Sekiz sayıyı toplamak kolaydır; fakat işlemci bu sayıları RAM’den bekliyorsa aritmetik birimler boşta kalabilir. Ayrıca yoğun AVX-512 kullanımı bazı işlemcilerde saat frekansını düşürebilir.
| Uygun senaryo | Zorlayıcı senaryo |
|---|---|
| Büyük ve ardışık diziler | Dağınık bellek erişimi |
| Her öğeye aynı işlem | Çok sayıda koşullu dal |
| Görüntü ve ses verisi | Birbirine bağımlı hesaplamalar |
| Matris işlemleri | Çok küçük veri kümeleri |
Intrinsic yazmak şart mı?
Hayır. Modern derleyiciler sade döngüleri otomatik vektörleştirebilir. GCC ve Clang için -O3 -march=native, MSVC için /O2 seçenekleri iyi bir başlangıçtır. Yine de aliasing şüphesi, karmaşık koşullar veya belirsiz döngü sınırları derleyiciyi temkinli davranmaya zorlayabilir. Vektörleştirme raporları ve assembly çıktısı, gerçekten SIMD üretilip üretilmediğini gösterir.
SIMD’nin özeti şudur: veriyi düzenli yerleştir, aynı işlemi kalabalık gruplara uygula ve sonucu ölç. Kronometre olmadan yapılan optimizasyon, spor ayakkabı giyince otomatik olarak maratoncu olduğunu sanmaya benzer. Önce profil çıkar, sonra vektörleştir; işlemcin gerçekten teşekkür ediyorsa devam et!
Yorumlar