İçindekiler
Sıralı verilerde arama yapmak istediğinizde bağlı listeler basit ama yavaştır; dengeli ikili arama ağaçları ise hızlı ama uygulaması görece karmaşıktır. Skip List, bu iki dünyanın arasına eğlenceli bir olasılık fikri yerleştirir: Bazı düğümlere rastgele seçilen ek “hız şeritleri” verir. Böylece listeyi tamamen yeniden dengelemeden, ortalama durumda oldukça hızlı arama, ekleme ve silme işlemleri sunar. ``
Temel fikir: Katmanlı bağlı liste
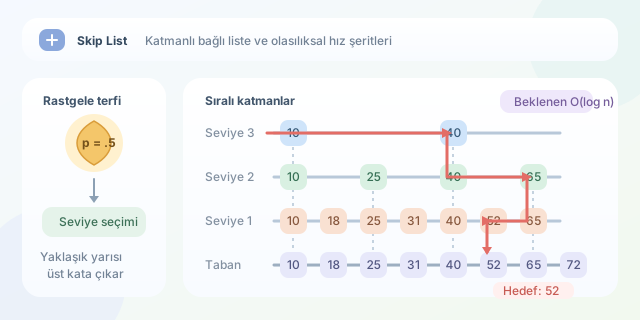
En alt katmanda sıradan, sıralı bir bağlı liste bulunur. Üst katmanlar ise alt listedeki düğümlerin yalnızca bir kısmını içerir. Arama en üst seviyeden başlar; hedef değeri aşmadan sağa ilerler, sonraki düğüm fazla büyükse bir alt seviyeye iner. Bu yaklaşım, otoyoldan ana yola, ardından ara sokağa geçmek gibidir.
Bir düğümün üst seviyeye çıkıp çıkmayacağı genellikle yazı-tura benzeri bir seçimle belirlenir. Terfi olasılığı $p = 0.5$ ise düğümlerin yaklaşık yarısı ikinci katmanda, dörtte biri üçüncü katmanda görünür. $n$ düğümlü bir yapı için beklenen katman sayısı yaklaşık olarak şudur:
\[L \approx \log_{1/p}(n)\]Bu rastlantısallık ilk bakışta ürkütücü gelebilir. Ancak çok sayıda düğümde dağılım dengeli bir ağacın davranışına yaklaşır. Skip List’in güzelliği tam da burada: Karmaşık rotasyonlar yerine olasılık kullanır.
| Yapı | Arama | Ekleme | Silme | Uygulama zorluğu |
|---|---|---|---|---|
| Sıralı bağlı liste | $O(n)$ | $O(n)$ | $O(n)$ | Düşük |
| AVL / Kırmızı-Siyah ağaç | $O(\log n)$ | $O(\log n)$ | $O(\log n)$ | Yüksek |
| Skip List (beklenen) | $O(\log n)$ | $O(\log n)$ | $O(\log n)$ | Orta |
| Hash tablosu | $O(1)$ ortalama | $O(1)$ ortalama | $O(1)$ ortalama | Orta |
Hash tablosu doğrudan anahtar erişiminde çok güçlüdür; fakat sıralı gezinme, aralık sorgusu veya “en yakın büyük değer” gibi işlemlerde Skip List daha doğal bir çözümdür.
Arama ve ekleme nasıl çalışır?
Arama sırasında her seviyede mümkün olduğunca sağa gidilir. Ardından bir alt seviyeye inilerek daha hassas ilerlenir. Ekleme işleminde önce her katmandaki önceki düğümler kaydedilir. Yeni düğümün seviyesi rastgele belirlendikten sonra bu bağlantılar güncellenir.
Aşağıdaki Python örneği, bir düğüme rastgele seviye atayan temel mekanizmayı gösterir:
import random

MAX_LEVEL = 16
P = 0.5

def random_level():
    level = 0
    while random.random() < P and level < MAX_LEVEL:
        level += 1
    return level

for _ in range(5):
    print("Yeni düğüm seviyesi:", random_level())
Buradaki random_level fonksiyonu, bir düğümün kaç hızlı şeritte yer alacağını seçer. P değeri büyüdükçe üst katmanlar daha kalabalık olur: Arama bazı senaryolarda rahatlar, fakat bellek tüketimi artar. Beklenen ileri işaretçi sayısı kabaca $\frac{1}{1-p}$ ile ilişkilidir.
| Terfi olasılığı | Üst katman yoğunluğu | Bellek kullanımı | Genel karakter |
|---|---|---|---|
| $0.25$ | Seyrek | Daha düşük | Daha az hızlı şerit |
| $0.50$ | Dengeli | Orta | Yaygın varsayılan |
| $0.75$ | Yoğun | Daha yüksek | Daha fazla işaretçi |
Ne zaman tercih edilmeli?
Skip List; sıralı anahtarlar, aralık sorguları, eşzamanlı erişim ve basit kod gerektiren sistemlerde iyi bir adaydır. Nitekim Redis’in sıralı kümeleri gibi gerçek sistemlerde benzer yaklaşımın kullanılması tesadüf değildir. Buna karşılık en kötü durum garantisinin mutlak biçimde $O(\log n)$ olması gereken kritik senaryolarda dengeli ağaçlar daha güvenli tercihtir.
Özetle Skip List, “dengelemek yerine akıllıca rastgeleleştirelim” der. Teorik olarak zarif, pratikte uygulanabilir ve veri yapıları dünyasında olasılığın ne kadar işe yarayabildiğini gösteren güçlü bir örnektir.
Yorumlar