İçindekiler
Uzun bir metinde belirli bir kalıbı aramak, samanlıkta iğne bulmaya benzeyebilir. Son ek dizileri, samanları alfabetik biçimde düzenleyerek bu işi şaşırtıcı derecede hızlandırır. Özellikle genom analizi, arama motorları, veri sıkıştırma ve tekrar tespiti gibi alanlarda kullanılan bu yapı, metnin kendisini değiştirmez; yalnızca nereden başlayan son eklerin hangi sırada bulunduğunu saklar.
``
Son ek nedir?
Bir metnin belirli bir konumundan sonuna kadar uzanan parçaya son ek denir. Örneğin banana metninin son ekleri şöyledir:
| Başlangıç indisi | Son ek |
|---|---|
| 0 | banana |
| 1 | anana |
| 2 | nana |
| 3 | ana |
| 4 | na |
| 5 | a |
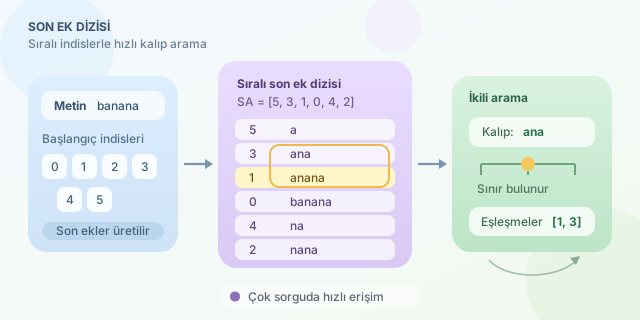
Bu son ekleri sözlük sırasına koyduğumuzda a, ana, anana, banana, na, nana sıralamasını elde ederiz. Son ek dizisi, parçaların kendileri yerine başlangıç indislerini tutar:
Buradaki temel fikir basittir: Aradığımız kalıpla başlayan bütün son ekler, sıralı listede yan yana bulunur. Böylece metni soldan sağa taramak yerine son ekler üzerinde ikili arama yapabiliriz.
Neden daha hızlıdır?
Uzunluğu $n$ olan bir metinde, uzunluğu $m$ olan bir kalıbı klasik yöntemle aramak en kötü durumda $O(nm)$ zaman alabilir. Son ek dizisi hazırsa ikili arama yaklaşık $O(\log n)$ karşılaştırma yapar. Her karşılaştırmada en fazla $m$ karakter incelendiği için sorgu maliyeti:
\[O(m \log n)\]olur. Yapının hazırlanması ayrıca maliyetlidir; fakat aynı metin üzerinde binlerce sorgu yapılacaksa bu yatırım kısa sürede karşılığını verir.
| Yöntem | Ön işleme | Tek sorgu | Ek bellek | Uygun kullanım |
|---|---|---|---|---|
| Doğrusal arama | $O(1)$ | $O(nm)$ | $O(1)$ | Az sayıda sorgu |
| Son ek dizisi | Genellikle $O(n \log n)$ | $O(m \log n)$ | $O(n)$ | Çok sayıda sorgu |
| Son ek ağacı | $O(n)$ | $O(m)$ | Yüksek | En hızlı sorgular |
Son ek dizisi, son ek ağacına göre daha kompakt olması ve önbellek dostu ardışık bir dizi kullanması nedeniyle pratikte oldukça çekicidir.
Python ile basit kurulum
Aşağıdaki eğitim amaçlı uygulama, bütün başlangıç indislerini karşılık gelen son eklere göre sıralar:
def suffix_array(text):
    # Her indis, text[i:] son ekinin anahtarıyla sıralanır.
    return sorted(range(len(text)), key=lambda i: text[i:])

text = "banana"
sa = suffix_array(text)
print(sa)  # [5, 3, 1, 0, 4, 2]
Kod oldukça okunaklıdır; ancak text[i:] işlemi yeni dizgiler oluşturduğu için büyük verilerde pahalıdır. Üretim seviyesindeki algoritmalar, son ekleri doğrudan kopyalamak yerine sıralama derecelerini kullanır. Prefix doubling yaklaşımı önce bir karakterlik, ardından 2, 4, 8 karakterlik önekleri karşılaştırır ve yaklaşık $O(n \log n)$ sürede çalışır.
Kalıp arama
Python’ın bisect modülü doğrudan özel karşılaştırıcı kabul etmediğinden, mantığı açıkça gösteren bir ikili arama yazabiliriz:
def find_pattern(text, sa, pattern):
    left, right = 0, len(sa)

    while left < right:
        mid = (left + right) // 2
        piece = text[sa[mid]:sa[mid] + len(pattern)]

        if piece < pattern:
            left = mid + 1
        else:
            right = mid

    start = left
    matches = []
    while start < len(sa) and text.startswith(pattern, sa[start]):
        matches.append(sa[start])
        start += 1
    return sorted(matches)

print(find_pattern("banana", [5, 3, 1, 0, 4, 2], "ana"))
# [1, 3]
İkili arama ilk eşleşmenin sınırını bulur; ardından yan yana duran eşleşmeler toplanır. Sonuç sayısı $k$ ise toplam maliyet yaklaşık $O(m \log n + km)$ olur.
LCP ile bir adım ileri
Son ek dizisinin sık kullanılan yardımcısı LCP dizisidir. LCP, komşu iki sıralı son ekin en uzun ortak önek uzunluğunu saklar. Örneğin ana ile anana arasındaki ortak önek uzunluğu 3’tür. En büyük LCP değeri, metindeki en uzun tekrarlanan parçayı gösterebilir.
Kısacası son ek dizisi, “bütün parçaları sakla” yaklaşımı değil, “başlangıçları akıllıca sırala” yaklaşımıdır. Metin sabit, sorgu sayısı fazlaysa bu mütevazı indis listesi gerçek bir arama roketine dönüşür.
Yorumlar