İçindekiler
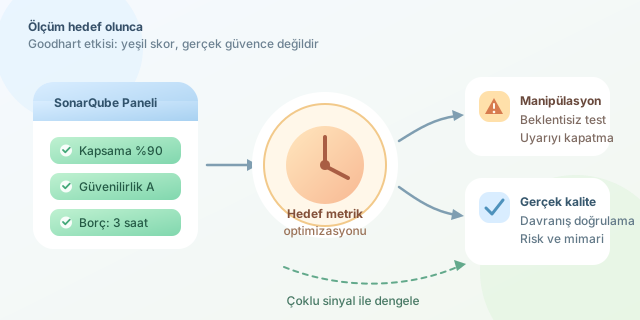
SonarQube panelinde bütün göstergelerin yeşile dönmesi insana küçük bir zafer hissi verir. Coverage yüzde 90, teknik borç birkaç saat, güvenilirlik notu A… Peki ürün gerçekten daha güvenilir midir? Ne yazık ki metrikler kaliteyi görünür kılabildiği kadar onu taklit etmeyi de teşvik edebilir. Ölçüm, amaç hâline geldiğinde ekipler iyi yazılım üretmek yerine iyi görünen panolar üretmeye başlayabilir.
``
Goodhart Yasası nedir?
Ekonomist Charles Goodhart ile özdeşleşen yasa kabaca şöyle der: Bir ölçü hedef hâline geldiğinde iyi bir ölçü olmaktan çıkar. Yazılım dünyasında bunu şu basit modelle düşünebiliriz:
\[M = f(Q) + \varepsilon\]Burada $Q$ gerçek kaliteyi, $M$ ölçülen metriği, $\varepsilon$ ise ölçüm hatasını veya metriğin göremediği unsurları temsil eder. Normalde $M$, kalite hakkında yaklaşık bir sinyal verir. Ancak ekip yalnızca $M$ değerini yükseltmekle ödüllendirilirse fonksiyonun kendisini değil, açıklarını optimize etmeye başlar.
Örneğin kod kapsama oranı genellikle şöyle hesaplanır:
\[Coverage = \frac{Çalıştırılan\ kod\ birimleri}{Toplam\ kod\ birimleri} \times 100\]Bu formül bir satırın test sırasında çalışıp çalışmadığını söyler; doğru davranışın gerçekten doğrulanıp doğrulanmadığını söylemez.
Yüzde 100 kapsama, sıfır güvence
Aşağıdaki test teknik olarak kodu çalıştırır ve coverage değerini artırabilir:
function indirimliFiyat(fiyat, oran) {
  if (oran < 0 || oran > 1) throw new Error("Geçersiz oran");
  return fiyat * (1 - oran);
}

test("indirim fonksiyonunu çalıştırır", () => {
  indirimliFiyat(100, 0.2);
});
Testte hiçbir beklenti bulunmuyor. Fonksiyon yanlışlıkla 42 döndürse bile test geçer. Anlamlı sürüm ise davranışı açıkça doğrular:
test("yüzde 20 indirimi hesaplar", () => {
  expect(indirimliFiyat(100, 0.2)).toBe(80);
});

test("geçersiz oranı reddeder", () => {
  expect(() => indirimliFiyat(100, 1.5)).toThrow("Geçersiz oran");
});
İkinci yaklaşım yalnızca satırları ziyaret etmez; iş kuralını ve hata sınırını belgeler. Coverage aynı kalabilir, fakat sağlanan güvence dramatik biçimde artar.
| Metrik | Ne anlatabilir? | Ne anlatamaz? | Nasıl manipüle edilir? |
|---|---|---|---|
| Kod kapsama | Hangi kodların çalıştırıldığı | Assertion kalitesi ve senaryo doğruluğu | Beklentisiz testler yazmak |
| Teknik borç | Belirli kurallara göre tahmini düzeltme süresi | Mimari karmaşa ve ekip bilgisi kaybı | Uyarıları kapatmak veya NOSONAR kullanmak |
| Tekrar oranı | Benzer kod miktarı | Tekrarın bağlamsal olarak zararlı olup olmadığı | Gereksiz soyutlamalar üretmek |
| Karmaşıklık | Kontrol akışının dallanması | Alan modelinin anlaşılabilirliği | Mantığı küçük ama anlamsız fonksiyonlara bölmek |
Teknik borç puanı neden mutlak gerçek değildir?
SonarQube teknik borcu, etkin kuralların ihlallerine atanmış tahmini düzeltme sürelerinden üretir. Dolayısıyla sonuç; kalite profilinə, eşiklere, dile ve analiz kapsamına bağlıdır. Araç, yanlış servis sınırını, kötü seçilmiş veri modelini veya kritik bilginin yalnızca bir geliştiricinin zihninde bulunmasını bütünüyle ölçemez.
Dahası, “borcu cuma gününe kadar yüzde 30 azaltın” hedefi verilirse ekip kolay uyarıları temizleyip yüksek etkili mimari sorunları erteleyebilir. Puan iyileşir, risk yerinde kalır.
Metrikleri pusula olarak kullanmak
Sağlıklı yaklaşım tek bir sayıya değil, birbirini denetleyen sinyallere bakmaktır. Coverage yanında mutation testing kullanılabilir: Araç üretim kodunu kasıtlı olarak değiştirir ve testlerin bu hataları yakalayıp yakalamadığını ölçer. Ayrıca hata kaçış oranı, kod inceleme bulguları, üretim olayları ve değişiklik yapma süresi birlikte değerlendirilmelidir.
Hedef “coverage yüzde 90 olsun” yerine “kritik ödeme kuralları anlamlı testlerle korunsun” şeklinde tanımlanmalıdır. SonarQube bir hâkim değil, duman dedektörüdür: Alarmı susturmak yangını söndürmez. Yeşil panel kutlanabilir; ancak asıl soru her zaman şudur: Bu metrik hangi gerçek riski temsil ediyor ve ekip onu gerçekten azalttı mı?
Yorumlar