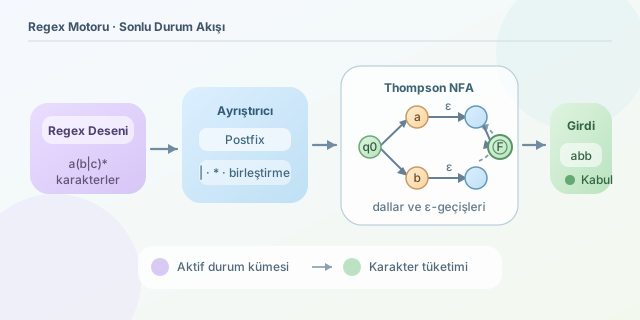
Düzenli ifadeler ilk bakışta sihirli karakter dizileri gibi görünür: a*b, [0-9]+ ya da ^mail@alan\.com$. Ancak perde arkasında oldukça matematiksel ve anlaşılır bir fikir vardır: sonlu durum makineleri. Küçük bir regex motoru yazmak, hem regex desenlerinin nasıl yorumlandığını hem de derleyicilerin temel prensiplerini öğrenmenin eğlenceli bir yoludur. Bu yazıda hedefimiz, tam özellikli bir PCRE canavarı üretmek değil; karakterler, birleştirme, \vert alternatifi ve * tekrarı için çalışan bir çekirdek tasarlamaktır.
``
Bir sonlu durum makinesi (Finite Automaton), sınırlı sayıda durumdan oluşur. Makine bir giriş metnini karakter karakter gezer; her karakter, onu mevcut durumdan başka bir duruma taşır. Metin bittiğinde makine kabul durumundaysa eşleşme başarılıdır. En temel formülasyon şöyledir:
\[M = (Q, \Sigma, \delta, q_0, F)\]Burada $Q$ durum kümesi, $\Sigma$ alfabe, $\delta$ geçiş fonksiyonu, $q_0$ başlangıç durumu ve $F$ kabul durumlarıdır. Örneğin ab deseni için makine önce a, sonra b görmeyi bekler. Bu yaklaşımda regex bir metin değil, durumlar arasında yol tarifidir.
\vert Kavram \vert Regex dünyasındaki karşılığı \vert Örnek \vert
\vert —\vert —\vert —\vert
\vert Durum \vert Desenin bir noktası \vert a okunduktan sonraki konum \vert
\vert Geçiş \vert Bir karakter tüketme \vert q0 --a--> q1 \vert
\vert Kabul durumu \vert Eşleşmenin tamamlanması \vert ab sonunda q2 \vert
\vert ε-geçişi \vert Karakter tüketmeden ilerleme \vert a\vert b dallanması \vert
İki ana makine türü vardır. DFA (Deterministic Finite Automaton) her durum ve karakter için en fazla bir sonraki duruma sahiptir. Bu nedenle çalıştırması çok hızlıdır. NFA (Nondeterministic Finite Automaton) ise aynı karakterde birden çok seçeneğe ve ε-geçişlerine izin verir. Regex derlemede NFA üretmek kolay, DFA çalıştırmak ise çoğu zaman hızlıdır.
\vert Özellik \vert NFA \vert DFA \vert \vert —\vert —\vert —\vert \vert Bir durumdan olası geçiş \vert Birden fazla olabilir \vert Yalnızca bir tane \vert \vert ε-geçişi \vert Vardır \vert Yoktur \vert \vert Regex’ten üretim \vert Kolaydır \vert Dönüşüm gerekir \vert \vert Çalışma maliyeti \vert Aktif durum kümesi yönetir \vert Genellikle $O(n)$ |
Pratik bir başlangıç için Thompson yapısını kullanabiliriz. Her ifade parçası bir başlangıç ve bir bitiş durumu üretir. Birleştirme (ab) ilk parçanın sonunu ikinci parçanın başına bağlar. Alternatif (a|b) yeni bir başlangıçtan iki dala ayrılır. Yıldız (a*) ise hem boş eşleşmeye hem de tekrar döngüsüne izin verir.
Aşağıdaki minimal örnek, önceden kurulmuş bir NFA’yı çalıştırır. None, ε-geçişini temsil eder:
from collections import defaultdict

class NFA:
    def __init__(self, start, accept):
        self.start = start
        self.accept = accept
        self.edges = defaultdict(list)

    def add(self, source, symbol, target):
        self.edges[source].append((symbol, target))

    def epsilon_closure(self, states):
        stack, closed = list(states), set(states)
        while stack:
            state = stack.pop()
            for symbol, target in self.edges[state]:
                if symbol is None and target not in closed:
                    closed.add(target)
                    stack.append(target)
        return closed

    def matches(self, text):
        current = self.epsilon_closure({self.start})
        for char in text:
            next_states = set()
            for state in current:
                for symbol, target in self.edges[state]:
                    if symbol == char or symbol == '.':
                        next_states.add(target)
            current = self.epsilon_closure(next_states)
        return self.accept in current
Bu motoru geliştirmek için ilk iş, regex metnini ayrıştırmaktır. a(b|c)* gibi bir ifadede parantezlerin önceliği vardır; ardından *, sonra açıkça yazılmayan birleştirme, en son da | gelir. Shunting-yard algoritmasıyla ifadeyi postfix biçimine dönüştürmek, NFA parçalarını bir yığın üzerinden birleştirmeyi kolaylaştırır.
Önemli sınır şudur: geri başvurular ((a)\1) ve bazı gelişmiş lookaround yapıları klasik sonlu otomatların gücünü aşar. Buna karşılık arama, doğrulama, tokenizer ve log filtreleme gibi pek çok iş için FSM tabanlı motorlar hem güvenilir hem de tahmin edilebilir performans sunar. Regex sihrini bozduğunuzda geriye korkutucu semboller değil, düzenli graf yapıları kalır.
Yorumlar