İçindekiler
Bir dizi üzerinde tekrar tekrar “şu aralıktaki en küçük eleman nedir?” diye sorulacağını, fakat dizinin hiçbir zaman değişmeyeceğini düşün. Her sorguda aralığı baştan sona dolaşmak gereksiz bir maraton olur. Sparse Table, biraz ön hazırlık yaparak minimum, maksimum ve EBOB gibi değişmeyen aralık sorgularını $O(1)$ sürede cevaplayan zarif bir veri yapısıdır.
``
Temel fikir: Aralıkları ikinin kuvvetlerine bölmek
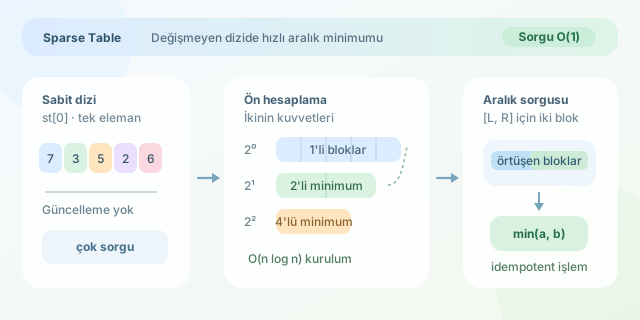
Sparse Table, uzunluğu ikinin kuvveti olan bütün anlamlı aralıkların sonucunu önceden hesaplar. Burada
\[st[k][i] = [i, i + 2^k - 1]\]aralığının sonucunu temsil eder. Örneğin $st[0][i]$ tek elemanlı, $st[1][i]$ iki elemanlı, $st[2][i]$ ise dört elemanlı aralığı saklar.
Minimum sorgusu için geçiş formülü şöyledir:
\[st[k][i] = \min(st[k-1][i], st[k-1][i + 2^{k-1}])\]Yani $2^k$ uzunluğundaki bir aralık, yan yana duran iki adet $2^{k-1}$ uzunluklu parçadan oluşur. Böylece tabloyu küçük aralıklardan büyüklere doğru kurabiliriz.
| Yöntem | Ön işleme | Sorgu | Güncelleme | Uygun durum |
|---|---|---|---|---|
| Doğrusal tarama | $O(1)$ | $O(n)$ | $O(1)$ | Çok az sorgu |
| Segment Tree | $O(n)$ | $O(\log n)$ | $O(\log n)$ | Dizi değişiyorsa |
| Sparse Table | $O(n\log n)$ | $O(1)$ | Desteklemez | Dizi sabitse |
Sorgu neden sabit zamanda?
$[L,R]$ aralığının uzunluğu $len=R-L+1$ olsun. Bu uzunluğa sığan en büyük ikinin kuvvetini seçeriz:
\[k = \lfloor \log_2(len) \rfloor\]Ardından aralığın başından ve sonundan $2^k$ uzunluklu iki blok alırız:
\[\min(st[k][L], st[k][R-2^k+1])\]Bu bloklar üst üste binebilir. Minimum işleminde bu sorun değildir; aynı elemanı iki kez değerlendirmek sonucu değiştirmez. Buna idempotentlik denir: $\min(x,x)=x$. Maksimum ve EBOB da bu özelliğe sahiptir. Toplama ise sahip değildir; örtüşen elemanlar iki kez sayılacağı için klasik Sparse Table ile $O(1)$ toplam sorgusu yapılamaz.
C++ uygulaması
Aşağıdaki sınıf, minimum aralık sorgularını sıfır tabanlı indekslerle cevaplar:
#include <algorithm>
#include <vector>
using namespace std;

class SparseTable {
    vector<vector<int>> st;
    vector<int> logs;

public:
    SparseTable(const vector<int>& a) {
        int n = a.size();
        logs.resize(n + 1);

        for (int i = 2; i <= n; ++i)
            logs[i] = logs[i / 2] + 1;

        int levels = logs[n] + 1;
        st.assign(levels, vector<int>(n));
        st[0] = a;

        for (int k = 1; k < levels; ++k) {
            int length = 1 << k;
            int half = length >> 1;

            for (int i = 0; i + length <= n; ++i) {
                st[k][i] = min(st[k - 1][i],
                               st[k - 1][i + half]);
            }
        }
    }

    int query(int left, int right) const {
        int length = right - left + 1;
        int k = logs[length];
        return min(st[k][left],
                   st[k][right - (1 << k) + 1]);
    }
};
logs dizisi, her sorguda logaritma hesaplamak yerine $\lfloor\log_2(x)\rfloor$ değerini hazır tutar. Kurucu metot tüm seviyeleri $O(n\log n)$ zamanda oluşturur. query ise yalnızca iki tablo hücresine erişip minimum aldığı için gerçekten $O(1)$ çalışır.
Ne zaman tercih edilmeli?
Sparse Table; yarışma programlamasındaki RMQ problemleri, sabit yükseklik dizileri, değişmeyen grafik verileri ve çok sayıda çevrimdışı sorgu için idealdir. Bellek tüketimi $O(n\log n)$ olduğundan devasa dizilerde dikkat gerekir. Ayrıca tek bir eleman bile güncellenecekse tabloyu yeniden kurmak gerekir; bu durumda Segment Tree daha mantıklıdır.
Kısacası dizi sabit, sorgu sayısı yüksek ve işlem idempotent ise Sparse Table tam bir “önceden çalış, sonra keyfine bak” algoritmasıdır.
Yorumlar