İçindekiler
Tek bir makine öğrenmesi modeli her zaman yıldız oyuncu olmayabilir; bazen farklı yeteneklere sahip modelleri aynı takımda oynatmak daha iyi sonuç verir. Süper öğrenme ya da yaygın adıyla stacking, birden fazla temel modelin tahminlerini yeni bir modelin girdisi haline getirir. Amaç, modellerin güçlü yanlarını birleştirirken birbirlerinin hatalarını dengelemektir. Örneğin doğrusal bir model genel eğilimi yakalarken, ağaç tabanlı bir model karmaşık ve doğrusal olmayan ilişkileri keşfedebilir. ``
Stacking mantığı nedir?
Stacking mimarisinde ilk katmanda yer alan modellere base learner denir. Bu modeller aynı eğitim verisinden tahmin üretir. İkinci katmandaki meta-model ise hangi temel modelin hangi koşulda daha güvenilir olduğunu öğrenir. Regresyon probleminde basitleştirilmiş fikir şöyle yazılabilir:
\[\hat{y} = g\left(f_1(X), f_2(X), \dots, f_m(X)\right)\]Burada $f_1, f_2, \dots, f_m$ temel modelleri, $g$ ise meta-modeli temsil eder. Meta-model çoğu zaman lojistik regresyon, ridge regresyon veya küçük bir gradient boosting modeli olur. Çok karmaşık bir meta-model seçmek, başarı yerine ezberleme getirebilir.
| Yaklaşım | Modeller nasıl birleşir? | Avantajı | Riski |
|---|---|---|---|
| Voting | Oy veya ortalama alınır | Basit ve hızlıdır | Her modele benzer ağırlık verir |
| Bagging | Aynı tip model, farklı örneklemler | Varyansı düşürür | Yanlılığı sınırlı azaltır |
| Boosting | Modeller hatalara odaklanarak sırayla kurulur | Güçlü tahmin performansı | Gürültüye duyarlı olabilir |
| Stacking | Tahminleri meta-model öğrenir | Tamamlayıcı modelleri kullanır | Veri sızıntısına açıktır |
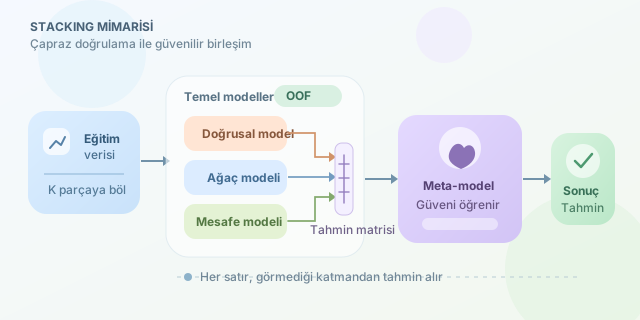
En kritik nokta: Out-of-Fold tahminler
Stacking uygulanırken en tehlikeli hata, meta-modeli temel modellerin eğitim verisi üzerindeki doğrudan tahminleriyle eğitmektir. Böyle bir durumda temel modeller zaten gördükleri satırları tahmin eder; meta-model de gerçekte olmayan kadar parlak sonuçlar görür. Bu olaya data leakage denir.
Çözüm, çapraz doğrulama ile üretilen out-of-fold (OOF) tahminlerdir. Veri $K$ parçaya ayrılır. Her turda bir parça doğrulama için ayrılır, model kalan $K-1$ parçada eğitilir ve yalnızca ayrılan parçayı tahmin eder. Böylece her satır, onu eğitim sırasında görmemiş bir modelden tahmin alır. Meta-modelin eğitim matrisi güvenilir biçimde oluşur.
\[Z = [\hat{y}^{OOF}_1, \hat{y}^{OOF}_2, \ldots, \hat{y}^{OOF}_m]\]Buradaki $Z$, meta-modelin özellik matrisi; her sütun ise bir temel modelin OOF tahminidir.
Scikit-learn ile pratik kurulum
Aşağıdaki örnek, sınıflandırmada lojistik regresyon, rastgele orman ve histogram tabanlı gradient boosting modellerini bir araya getirir. Son karar verici olarak lojistik regresyon kullanılır; bu seçim meta katmanın daha yorumlanabilir kalmasına yardım eder.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.ensemble import StackingClassifier, RandomForestClassifier, HistGradientBoostingClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)

base_models = [
    ("lr", LogisticRegression(max_iter=3000)),
    ("rf", RandomForestClassifier(n_estimators=300, random_state=42)),
    ("hgb", HistGradientBoostingClassifier(random_state=42))
]

stack = StackingClassifier(
    estimators=base_models,
    final_estimator=LogisticRegression(max_iter=3000),
    cv=5,
    stack_method="predict_proba"
)

stack.fit(X_train, y_train)
probabilities = stack.predict_proba(X_test)[:, 1]
print("ROC-AUC:", roc_auc_score(y_test, probabilities))
cv=5 parametresi OOF mantığını otomatik olarak uygular. predict_proba ise meta-modelin yalnızca sert sınıf etiketlerini değil, modellerin güven olasılıklarını da görmesini sağlar.
Ne zaman işe yarar?
Stacking, temel modellerin hataları birbirinden farklıysa özellikle değerlidir. Üç tane neredeyse aynı model kullanmak yerine; doğrusal model, ağaç modeli ve mesafe tabanlı model gibi farklı varsayımlara sahip seçenekleri deneyin. Başarıyı tek bir eğitim skoru ile değil, ayrı test kümesi veya nested cross-validation ile ölçün. Kısacası stacking sihirli değnek değildir; doğru doğrulama, model çeşitliliği ve sade bir meta-modelle kullanıldığında tahmin sisteminizin akıllı teknik direktörü olabilir.
Yorumlar