İçindekiler
Bir sunucunun CPU kullanımı, elektrik sayacının ölçümü, borsa fiyatı veya akıllı saatin kaydettiği nabız aynı temel özelliği taşır: Her değer belirli bir zaman anına aittir. Klasik veritabanları bu kayıtları elbette saklayabilir; ancak veri saniyede binlerce kez akmaya başladığında zaman, sıradan bir sütun olmaktan çıkar ve veri modelinin başrol oyuncusuna dönüşür.
``
Zaman serisi verisi nedir?
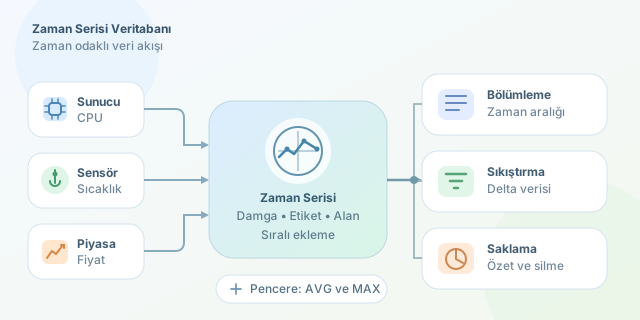
Bir zaman serisi kaydı genellikle üç parçadan oluşur:
- Zaman damgası: Ölçümün gerçekleştiği an
- Etiketler: Sunucu, cihaz, bölge veya sensör gibi kimlik bilgileri
- Alanlar: Sıcaklık, gecikme veya işlem sayısı gibi ölçülen değerler
Matematiksel olarak tek bir seri, $x(t)$ biçiminde düşünülebilir. Burada $t$ zaman, $x$ ise o andaki ölçümdür. Bir sensör her saniye veri gönderiyorsa yaklaşık kayıt sayısı şöyle hesaplanır:
\[N = f \times T\]Burada $f$ saniyedeki ölçüm sıklığı, $T$ ise toplam saniye sayısıdır. Saniyede 10.000 ölçüm alan bir sistem, günde $10.000 \times 86.400 = 864$ milyon kayıt üretir. İşte klasik CRUD yaklaşımının terlemeye başladığı nokta burasıdır.
Neden farklı davranır?
Zaman serilerinde veri çoğunlukla sona eklenir. Geçmişteki bir CPU ölçümünü sürekli güncellemek yerine yeni bir ölçüm yazılır. Okumalar ise genellikle belirli zaman aralıklarını, son değerleri veya özetleri hedefler.
| Özellik | Geleneksel veritabanı | Time-series database |
|---|---|---|
| Baskın işlem | Ekleme, güncelleme, silme | Sürekli ve sıralı ekleme |
| Temel filtre | Kimlik veya ilişki | Zaman aralığı ve etiket |
| Veri ömrü | Genellikle kalıcı | Saklama politikasına bağlı |
| Tipik sorgu | “Bu müşteri kim?” | “Son bir saatte ne oldu?” |
| Optimizasyon | İşlemsel tutarlılık | Yüksek yazma ve toplulaştırma |
Zamana göre sıralı gelen kayıtlar, disk üzerinde ardışık biçimde yazılabilir. Bu durum rastgele yazma maliyetini azaltır. Ayrıca birbirine yakın ölçümler çoğu zaman benzerdir. Örneğin sıcaklık değerleri 21.1, 21.2, 21.2, 21.3 şeklinde ilerliyorsa yalnızca farkları saklayan delta sıkıştırma ciddi alan kazandırır.
Bölümleme ve indeksleme
Milyarlarca satırı tek tabloda tutmak yerine veriler saat, gün veya hafta gibi zaman dilimlerine ayrılır. Bu tekniğe zaman tabanlı bölümleme denir. Kullanıcı son 24 saati istediğinde veritabanı eski bölümlere dokunmadan yalnızca ilgili parçaları tarar.
İndekslerde de zaman damgası kadar etiketler önemlidir. Örneğin region=istanbul ve device=server-42 kombinasyonu ayrı bir seriyi temsil edebilir. Ancak her isteğe benzersiz bir etiket eklemek yüksek kardinalite oluşturur. Milyonlarca farklı etiket kombinasyonu, indeks belleğini hızla tüketebilir.
Örnek bir sorgu
Aşağıdaki TimescaleDB uyumlu SQL sorgusu, son 24 saatteki CPU ölçümlerini beş dakikalık gruplara ayırır:
SELECT
    time_bucket('5 minutes', recorded_at) AS period,
    host,
    AVG(cpu_usage) AS average_cpu,
    MAX(cpu_usage) AS peak_cpu
FROM metrics
WHERE recorded_at >= NOW() - INTERVAL '24 hours'
GROUP BY period, host
ORDER BY period;
time_bucket kayıtları zaman pencerelerine yerleştirir; AVG genel eğilimi, MAX ise kısa süreli sıçramaları gösterir. Ham veriyi uygulamaya taşıyıp orada hesaplamak yerine işlemi veritabanına bırakmak ağ trafiğini ve bellek kullanımını azaltır.
Saklama ve örnek küçültme
Her saniyelik ölçümü sonsuza kadar saklamak pahalıdır. Bu nedenle TSDB sistemleri retention policy ile eski ham verileri otomatik silebilir. Buna karşılık saatlik veya günlük özetler korunabilir. Bu işleme downsampling denir.
Örneğin ilk 7 gün saniyelik, sonraki 90 gün dakikalık, daha eski dönemler ise saatlik ortalamalarla saklanabilir. Böylece yakın geçmiş ayrıntılı, uzak geçmiş ekonomik olur.
Sonuç olarak time-series database yalnızca “tarih sütunu bulunan veritabanı” değildir. Yazma düzeni, sıkıştırma, bölümleme, zaman pencereleri ve veri yaşam döngüsü birlikte tasarlanır. İzleme, IoT, finans veya analitik sisteminiz durmadan “ne zaman oldu?” diye soruyorsa, zaman serisi yaklaşımı büyük olasılıkla doğru araçtır.
Yorumlar