İçindekiler
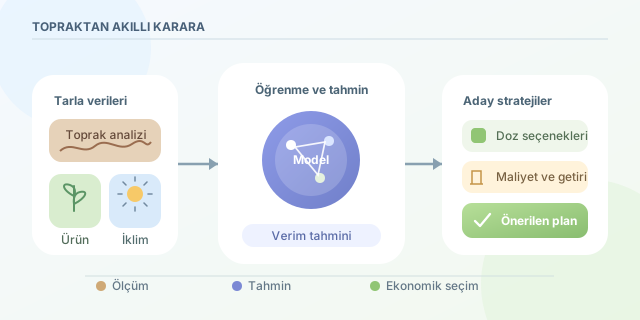
Toprak laboratuvarından gelen rapor, bazen tarlanın şifreli mesajı gibi görünür: pH, organik madde, azot, fosfor, potasyum… Peki bu sayılar hangi gübrenin, ne kadar ve ne zaman uygulanacağını söyleyebilir mi? Makine öğrenmesi, doğru deneylerle desteklendiğinde bu mesajı ekonomik bir gübreleme planına çevirebilir. Ancak amaç toprağa daha fazla gübre yüklemek değil, ihtiyaç kadarını doğru koşullarda kullanmaktır.
``
Önce toprağın çalışma mantığını anlayalım
Bitkinin beslenmesi yalnızca topraktaki toplam element miktarına bağlı değildir. Elementin alınabilirliği, kök gelişimi, nem ve sıcaklık da belirleyicidir. Örneğin fosfor bulunan bir toprakta uygunsuz pH, bitkinin bu fosfora erişmesini zorlaştırabilir. Yani depoda yiyecek olması, mutfağın kapısının açık olduğu anlamına gelmez!
| Özellik | Ne anlatır? | Gübreleme açısından önemi |
|---|---|---|
| pH | Asitlik ve alkalilik | Besinlerin alınabilirliğini etkiler |
| Organik madde | Biyolojik ve kimyasal tampon | Besin salımını ve su tutmayı etkiler |
| Alınabilir N, P, K | Yönteme bağlı besin göstergeleri | Eksiklik değerlendirmesine yardımcı olur |
| Elektriksel iletkenlik | Tuzluluk göstergesi | Aşırı uygulama riskini değerlendirmeyi sağlar |
Ölçüm birimleri kritik önemdedir. Laboratuvardaki $mg/kg$ değeri, doğrudan uygulanacak $kg/ha$ değildir; örnekleme derinliği, hacim ağırlığı ve kullanılan analiz yöntemi hesaba katılmalıdır. Ayrıca elementel fosfor ile $P_2O_5$, elementel potasyum ile $K_2O$ aynı miktarı ifade etmez.
Model aslında neyi öğreniyor?
Sağlam bir yaklaşım, farklı gübre dozlarının verimi nasıl değiştirdiğini öğrenmektir. Girdiler toprak özellikleri, ürün, iklim ve uygulanan dozlar; hedef ise hasatta ölçülen verim olur. Bunun için farklı dozları karşılaştıran, tercihen rastgele atanmış tarla denemeleri değerlidir.
Sadece geçmiş çiftçi kayıtlarından öğrenmek yanıltabilir: Daha sorunlu tarlalara daha çok gübre uygulanmışsa model, yüksek dozları düşük verimle ilişkilendirebilir. Korelasyon burada nedensellik değildir. Algoritma, yanlış deney tasarımını sihirli biçimde düzeltemez.
Ekonomik karar şu şekilde yazılabilir:
\[\mathbf{d}^{*}=\arg\max_{\mathbf{d}\in\mathcal{D}}\left[p\,\hat{Y}(\mathbf{x},\mathbf{d})-\sum_j c_jd_j\right]\]Burada $\mathbf{x}$ tarla koşulları, $\mathbf{d}$ besin dozları, $p$ ürünün kilogram fiyatı, $c_j$ ise ilgili besinin kilogram başına uygulama maliyetidir. $\mathcal{D}$, yerel agronomik ve çevresel sınırları karşılayan adayları içerir. Bu ifade, diğer maliyetler sabitken gübre maliyeti sonrası getiriyi karşılaştırır; işletmenin bütün kârını hesaplamaz.
Python ile aday stratejileri karşılaştıralım
Aşağıdaki örnek, tek ürün için deneme kayıtlarından bir Random Forest modeli eğitir. Aynı parselin eğitim ve test kümelerine karışmasını engeller, ardından önceden uygun bulunmuş dozları ekonomik açıdan sıralar.
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.impute import SimpleImputer
from sklearn.metrics import mean_absolute_error
from sklearn.model_selection import GroupShuffleSplit
from sklearn.pipeline import make_pipeline

df = pd.read_csv("denemeler.csv")
soil = ["ph", "organik_madde_pct", "alinabilir_n_mgkg",
        "alinabilir_p_mgkg", "alinabilir_k_mgkg", "ec_ds_m"]
doses = ["n_kg_ha", "p_kg_ha", "k_kg_ha"]
features = soil + doses
split = GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
train, test = next(split.split(df, groups=df["parsel_id"]))

model = make_pipeline(
    SimpleImputer(strategy="median"),
    RandomForestRegressor(n_estimators=300, min_samples_leaf=5,
                          random_state=42, n_jobs=-1)
)
model.fit(df.iloc[train][features], df.iloc[train]["verim_kg_ha"])
pred = model.predict(df.iloc[test][features])
print("MAE:", mean_absolute_error(df.iloc[test]["verim_kg_ha"], pred))

model.fit(df[features], df["verim_kg_ha"])
field = pd.read_csv("yeni_parsel.csv").iloc[0]
candidates = pd.read_csv("izinli_adaylar.csv")[doses].copy()
for column in soil:
    candidates[column] = field[column]
candidates["tahmini_verim"] = model.predict(candidates[features])
costs = np.array([20.0, 35.0, 25.0])  # Örnek TL/kg besin
candidates["net_getiri"] = (
    8.0 * candidates["tahmini_verim"] - candidates[doses].to_numpy() @ costs
)
print(candidates.sort_values("net_getiri", ascending=False).head(3))
CSV dosyalarında belirtilen sütunlar bulunmalıdır; dozlar elementel besin üzerinden tanımlanmıştır. Fiyatlar tamamen örnektir ve gerçek hesapta güncellenmelidir. Aday tablosu, sıfır uygulama seçeneğini ve uzman tarafından onaylanmış alternatifleri içermelidir. SimpleImputer, eksik değerleri yalnızca eğitim verisinden öğrenerek doldurur. MAE ise ortalama mutlak verim hatasını $kg/ha$ cinsinden gösterir.
Öneriyi tarlaya indirmeden önce
Bu küçük model sulama, hava koşulları ve uygulama zamanını kapsamaz; gerçek sistemde bunlar da değerlendirilmelidir. Dozun tamamını tek seferde vermekle bölerek uygulamak aynı sonuç değildir. Gelecek yıllara yönelik ayrı testler, basit modellerle karşılaştırma ve küçük saha denemeleri güvenilirliği artırır.
Son olarak, eğitim aralığının dışındaki dozlarda tahminlere güvenmeyin. Belirsizliği yüksek veya ekonomik getirileri birbirine yakın seçeneklerde daha temkinli planları değerlendirin. En iyi sistem, ziraat uzmanının yerini alan değil; ona ölçülebilir, açıklanabilir ve çevresel açıdan sorumlu seçenekler sunan sistemdir.
Yorumlar