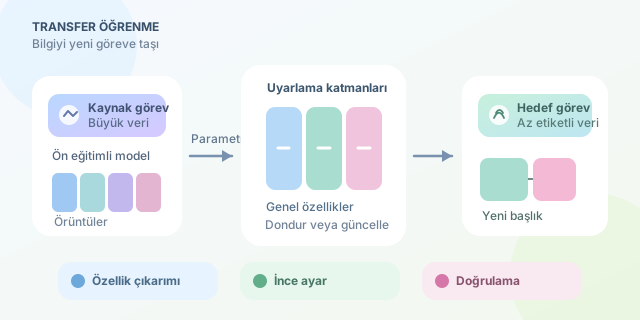
Transfer öğrenme, sıfırdan bir uzman yetiştirmek yerine deneyimli bir uzmanın bilgisini yeni bir göreve uyarlamaktır. ImageNet gibi devasa veri kümeleriyle eğitilmiş bir görüntü modeli; kenarları, dokuları, şekilleri ve nesne parçalarını zaten öğrenmiştir. Bu birikim, az etiketli kedi-köpek fotoğraflarından tıbbi görüntü sınıflandırmaya kadar birçok benzer problemde eğitim süresini, maliyeti ve veri ihtiyacını dramatik biçimde azaltır. ``
Klasik denetimli öğrenmede elimizde bir kaynak veri kümesi yokmuş gibi davranırız: Modelin parametreleri rastgele başlatılır ve hedef veriyle optimize edilir. Transfer öğrenmede ise kaynak görevden ($D_S, T_S$) edinilen parametreler, hedef göreve ($D_T, T_T$) taşınır. Amaç, hedef görevdeki genelleme hatasını düşürmektir:
\[\theta_T^* = \arg\min_{\theta} \mathcal{L}_T(f_{\theta}(x_T), y_T)\]Buradaki kritik fark, optimizasyonun rastgele bir $\theta$ yerine önceden eğitilmiş $\theta_S$ civarından başlamasıdır. Model, erken katmanlarda genellikle evrensel görsel ya da dilsel örüntüleri; son katmanlarda ise kaynak göreve özgü kararları saklar. Dolayısıyla yeni probleme geçerken hangi katmanların korunacağı stratejik bir karardır.
| Yaklaşım | Başlangıç noktası | Veri ihtiyacı | Eğitim maliyeti | Tipik risk |
|---|---|---|---|---|
| Sıfırdan eğitim | Rastgele ağırlıklar | Yüksek | Yüksek | Aşırı öğrenme, uzun eğitim |
| Özellik çıkarımı | Gövde dondurulmuş model | Düşük | Düşük | Hedefe yetersiz uyum |
| Fine-tuning | Ön eğitimli model + kısmi güncelleme | Orta | Orta | Bilginin unutulması |
Özellik çıkarımı en güvenli başlangıçtır. Ön eğitimli ağın gövdesi dondurulur, yalnızca yeni sınıflandırma başlığı eğitilir. Örneğin ResNet, ImageNet’te 1000 sınıf öğrenmiş olabilir; biz onun son katmanını iki sınıflı bir “kusurlu/kusursuz ürün” başlığıyla değiştiririz. Az veri varsa bu yöntem, milyonlarca parametreyi serbest bırakıp modele ezber yaptırmaktan daha mantıklıdır.
Veri miktarı arttığında veya hedef alan kaynak alandan belirgin biçimde farklılaştığında fine-tuning devreye girer. Bu aşamada son bloklar, bazen tüm ağ, küçük bir öğrenme oranıyla güncellenir. Küçük oran önemlidir; çünkü agresif güncellemeler modelin yararlı ön bilgisini silebilir. Bu olaya catastrophic forgetting denir. Pratik bir kural: Yeni başlık için daha yüksek, önceden eğitilmiş katmanlar için daha düşük öğrenme oranı kullanın.
Aşağıdaki PyTorch örneği, ResNet18’in son katmanını iki sınıfa uyarlayıp gövdeyi ilk aşamada dondurur:
import torch.nn as nn
from torchvision.models import resnet18, ResNet18_Weights

model = resnet18(weights=ResNet18_Weights.DEFAULT)

# Genel görsel özellikleri koru.
for param in model.parameters():
    param.requires_grad = False

# Kaynak görevin 1000 sınıflı başlığını hedef göreve değiştir.
in_features = model.fc.in_features
model.fc = nn.Sequential(
    nn.Dropout(0.2),
    nn.Linear(in_features, 2)
)

optimizer = torch.optim.AdamW(model.fc.parameters(), lr=1e-3)
criterion = nn.CrossEntropyLoss()
Bu kodda eğitilebilir parametreler yalnızca model.fc içindedir. Doğrulama başarımı plato yaptığında layer4 gibi son bir bloğu açıp daha düşük bir oranla (1e-5 gibi) fine-tuning yapılabilir. Ayrıca veri artırma teknikleri — kırpma, yatay çevirme, renk değişimi — küçük veri kümelerinde genellemeyi güçlendirir; ancak tıbbi görüntülerde anatomik anlamı bozabilecek dönüşümlerden kaçınmak gerekir.
Transfer her zaman sihir değildir. Kaynak ve hedef dağılımları çok farklıysa, örneğin günlük fotoğraflardan uydu radar verisine geçiliyorsa, negatif transfer görülebilir: Taşınan bilgi fayda yerine zarar verir. Karar verirken görev benzerliği, veri biçimi, etiket kalitesi ve lisans koşulları birlikte değerlendirilmelidir.
| Senaryo | Önerilen strateji | Neden |
|---|---|---|
| Az veri, benzer görüntüler | Dondurulmuş gövde + yeni başlık | Hızlı ve aşırı öğrenmeye dayanıklı |
| Orta veri, alan farkı var | Son blokları fine-tune et | Özellikleri hedefe yaklaştırır |
| Çok veri, radikal görev farkı | Baştan eğitim veya alan ön eğitimi | Kaynak bilgi yanıltıcı olabilir |
Özetle transfer öğrenme, hazır modeli körü körüne kullanmak değil, onun hangi bilgisinin taşınabilir olduğunu test etmektir. Doğru ön eğitimli modeli, ölçülü fine-tuning’i ve sağlam doğrulamayı birleştirdiğinizde küçük bir veri kümesi bile şaşırtıcı derecede güçlü bir ürüne dönüşebilir.
Yorumlar