İçindekiler
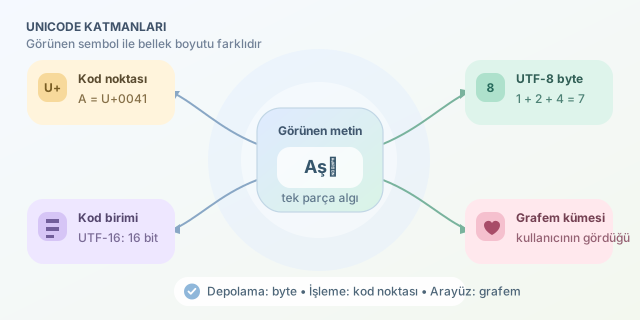
Ekranda tek parça görünen bir harfin bellekte de tek parça olduğunu düşünmek son derece doğal. Ne var ki bilgisayarlar için “karakter” şaşırtıcı derecede belirsiz bir kavramdır. Bir harf; kod noktası, kod birimi, byte veya kullanıcı tarafından algılanan sembol anlamına gelebilir. Emoji ailesini saymaya kalktığınızda işler tam bir Unicode korku filmine dönüşür.
``
Önce kavramları ayıralım
Unicode, karakterlere evrensel numaralar atayan bir standarttır. Örneğin A, U+0041; ş ise U+015F kod noktasına sahiptir. Ancak Unicode, bu numaranın bellekte nasıl saklanacağını tek başına söylemez. Saklama işi UTF-8, UTF-16 veya UTF-32 gibi kodlamalara aittir.
Temel kavramlar şöyle karşılaştırılabilir:
| Kavram | Anlamı | Örnek |
|---|---|---|
| Byte | Genellikle 8 bitlik veri birimi | 01000001 |
| Kod noktası | Unicode tarafından verilen numara | U+1F600 |
| Kod birimi | Kodlamanın temel depolama parçası | UTF-16 için 16 bit |
| Grafem kümesi | Kullanıcının tek karakter gördüğü yapı | 👨👩👧👦 |
Dolayısıyla “kaç karakter?” sorusundan önce hangi katmanı saydığımızı belirtmeliyiz.
UTF-8’de bir karakter kaç byte?
UTF-8 değişken uzunluklu bir kodlamadır. Bir Unicode kod noktası 1 ile 4 byte arasında yer kaplar:
| Kod noktası aralığı | UTF-8 boyutu | Örnek |
|---|---|---|
U+0000–U+007F |
1 byte | A, 7 |
U+0080–U+07FF |
2 byte | ş, é |
U+0800–U+FFFF |
3 byte | 中, € |
U+10000–U+10FFFF |
4 byte | 😀, 🚀 |
Örneğin Aş😀 metninin UTF-8 boyutu
olur. Buradaki üç Unicode kod noktası, toplam yedi byte tüketir. Bu nedenle genel olarak $karakter\ sayısı = byte\ sayısı$ eşitliği doğru değildir.
Python ile farkı doğrudan görebiliriz:
text = "Aş😀"

print(len(text))                 # 3 kod noktası
print(len(text.encode("utf-8"))) # 7 byte
print(list(text.encode("utf-8")))
encode, metni UTF-8 byte dizisine dönüştürür. Dosya boyutu, ağ paketi veya veritabanı sınırı hesaplanırken ikinci ölçüm önemlidir.
Tek görünen sembol, birçok kod noktası olabilir
é iki farklı biçimde üretilebilir. İlki tek kod noktası olan U+00E9; ikincisi ise e ile birleştirici aksan U+0301 dizisidir. İkisi ekranda aynı görünse de byte dizileri ve uzunlukları farklıdır.
import unicodedata

first = "é"
second = "e\u0301"

print(first == second)  # False
print(len(first), len(second))  # 1 2
print(unicodedata.normalize("NFC", second) == first)  # True
Normalizasyon, görsel olarak eşdeğer metinleri ortak bir forma getirir. Arama, kullanıcı adı karşılaştırma ve dosya adı işleme sırasında bu adım kritik olabilir.
Emoji dünyası daha da eğlencelidir. 👨👩👧👦 kullanıcıya tek aile sembolü gibi görünür; fakat birkaç insan emojisi ve Zero Width Joiner karakterlerinden oluşur. Yani grafem sayısı 1 iken kod noktası ve byte sayısı çok daha yüksektir.
JavaScript’in meşhur sürprizi
JavaScript dizeleri UTF-16 kod birimleriyle ölçer. Temel Çok Dilli Düzlem dışındaki kod noktaları iki kod birimi, yani surrogate pair kullanır:
const rocket = "🚀";

console.log(rocket.length);                  // 2 kod birimi
console.log([...rocket].length);             // 1 kod noktası
console.log(new TextEncoder().encode(rocket).length); // 4 byte
Kullanıcının gördüğü grafemleri saymak için modern JavaScript’te Intl.Segmenter kullanılabilir. Çünkü spread operatörü kod noktalarını ayırsa da birleşik emojileri tek sembol olarak garanti etmez.
Karanlık taraf neden önemli?
Yanlış uzunluk hesabı; yarım emoji kesilmesine, bozuk metne, veritabanı taşmalarına ve güvenlik açıklarına yol açabilir. Üstelik Latin a ile Kiril а gibi görsel benzerler, sahte alan adlarında kullanılabilir.
Pratik kural şudur: Depolama için byte, Unicode işlemleri için kod noktası, kullanıcı arayüzündeki uzunluk sınırları için grafem kümesi sayın. “Bir karakter kaç byte?” sorusunun dürüst cevabı ise şudur: Kodlamaya ve “karakter” derken neyi kastettiğinize bağlıdır.
Yorumlar