Bir sosyal ağdaki arkadaş gruplarını, şehirler arasındaki yol ağını veya bir labirentin hangi odalarının birbirine bağlı olduğunu düşünün. Her sorguda grafiği baştan sona gezmek mümkündür; fakat milyonlarca düğüm ve kenar varken bu yaklaşım pahalılaşır. Union-Find ya da diğer adıyla Disjoint Set Union (DSU), birbirinden ayrık kümeleri temsil eder, iki kümeyi birleştirir ve iki elemanın aynı kümede olup olmadığını son derece hızlı biçimde söyler. Kruskal minimum yayılım ağacı algoritmasının motoru da tam olarak budur. ``
Union-Find’in temelinde her kümenin bir temsilcisi bulunur. Başlangıçta her eleman tek başına bir kümedir; dolayısıyla her düğüm kendi temsilcisidir. find(x) işlemi, x elemanının ait olduğu kümenin kök temsilcisini döndürür. union(a, b) ise önce iki kökü bulur; kökler farklıysa birini diğerinin altına bağlayarak kümeleri birleştirir. Böylece şu mantıksal eşdeğerlik geçerlidir:
Naif bir uygulamada kökler zincir gibi uzayabilir. Örneğin 1, 2’nin; 2, 3’ün; 3 de 4’ün altında ise find(1) köke ulaşmak için üç bağlantı takip eder. DSU’nun etkileyici hızı iki optimizasyondan gelir: yol sıkıştırma ve rank/size ile birleştirme. Yol sıkıştırma, arama sırasında görülen düğümleri doğrudan köke bağlar. Boyuta göre birleştirme ise küçük ağacı büyük ağacın altına ekleyerek yüksekliği dengeler.
| Yaklaşım | find maliyeti |
Zincirleşme riski | Pratik kullanım |
|---|---|---|---|
| Naif ebeveyn dizisi | $O(n)$ | Yüksek | Küçük örnekler |
| Sadece boyuta göre birleştirme | $O(\log n)$ | Düşük | Dengeli kümeler |
| Boyut + yol sıkıştırma | $O(\alpha(n))$ amortize | Çok düşük | Büyük grafikler |
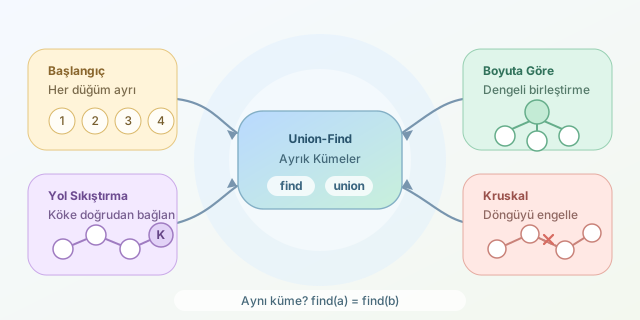
Buradaki $\alpha(n)$, ters Ackermann fonksiyonudur. Matematiksel olarak yavaş büyür; gerçek hayatta karşılaşacağınız tüm veri boyutlarında neredeyse sabit kabul edilir. Başka bir deyişle, yüz binlerce find ve union çağrısı genellikle göz açıp kapayıncaya kadar tamamlanır.
Aşağıdaki Python sınıfı, 0’dan n-1‘e kadar numaralanan düğümler için boyuta göre birleştirme ve yol sıkıştırmayı birlikte uygular:
class UnionFind:
    def __init__(self, n):
        self.parent = list(range(n))
        self.size = [1] * n

    def find(self, x):
        if self.parent[x] != x:
            self.parent[x] = self.find(self.parent[x])
        return self.parent[x]

    def union(self, a, b):
        root_a = self.find(a)
        root_b = self.find(b)

        if root_a == root_b:
            return False  # Zaten aynı bileşendeler.

        if self.size[root_a] < self.size[root_b]:
            root_a, root_b = root_b, root_a

        self.parent[root_b] = root_a
        self.size[root_a] += self.size[root_b]
        return True

    def connected(self, a, b):
        return self.find(a) == self.find(b)
union metodunun True veya False döndürmesi küçük ama güçlü bir tasarım ayrıntısıdır. True, iki ayrı bileşenin gerçekten birleştiğini; False ise eklenmek istenen bağlantının döngü oluşturacağını anlatır. Kruskal algoritması bu bilgiyi doğrudan kullanır: Kenarları ağırlıklarına göre sıralar, ardından yalnızca farklı kümeleri birleştiren kenarları seçer.
edges = [(1, 0, 1), (2, 1, 2), (3, 0, 2), (4, 2, 3)]
uf = UnionFind(4)
minimum_cost = 0

for weight, u, v in sorted(edges):
    if uf.union(u, v):
        minimum_cost += weight
        print(f"Seçildi: {u}-{v} ({weight})")

print("Toplam maliyet:", minimum_cost)
Bu örnekte 0-2 kenarı, 0 ve 2 zaten aynı bileşende olduğu anda atlanır; yani döngü engellenir. Sonuç olarak Kruskal’ın maliyeti çoğunlukla kenar sıralamadan gelir: $O(E \log E)$. DSU işlemlerinin toplam ek yükü ise yaklaşık $O(E\alpha(V))$ düzeyindedir.
Union-Find, kenar silme işlemlerinde doğal olarak güçlü değildir; çünkü ayrılmış bir kümeyi tekrar parçalamak için ek teknikler gerekir. Buna karşılık çevrimdışı bağlantı sorguları, ada/bölge birleştirme problemleri, eşdeğerlik sınıfları ve minimum yayılım ağacı için sade, hızlı ve güvenilir bir araçtır. Bir grafikte “bunlar hâlâ aynı grupta mı?” sorusunu sık soruyorsanız, DSU cebinizdeki küçük ama çok etkili algoritmik çakı olabilir.
Yorumlar