İçindekiler
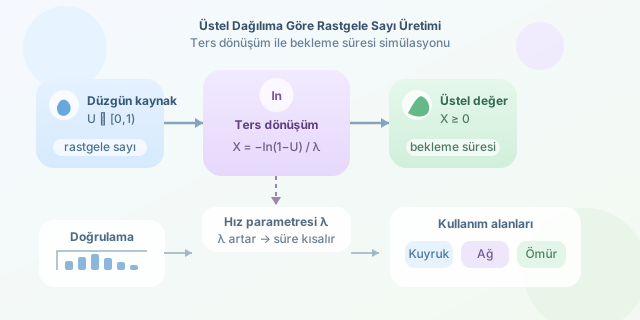
Bir sunucuya gelecek sıradaki isteğin kaç saniye sonra ulaşacağını veya bir elektronik parçanın ne kadar süre çalışacağını simüle etmek istediğimizi düşünelim. Sıradan rastgele sayılar çoğunlukla eşit olasılıklıdır; ancak gerçek hayattaki bekleme süreleri genellikle üstel dağılıma uyar. Neyse ki düzgün dağılımdan gelen tek bir sayı ve biraz logaritma ile bu davranışı taklit edebiliriz.
``
Üstel dağılımın teorik temeli
Üstel dağılım, bağımsız olaylar arasındaki bekleme süresini modellemek için kullanılır. Dağılımın temel parametresi $\lambda>0$, yani olayların birim zamandaki ortalama gerçekleşme hızıdır. Olasılık yoğunluk fonksiyonu şöyledir:
\[f(x)=\lambda e^{-\lambda x}, \qquad x\geq 0\]Kümülatif dağılım fonksiyonu ise bir değerin $x$ veya daha küçük olma olasılığını verir:
\[F(x)=P(X\leq x)=1-e^{-\lambda x}\]Dağılımın beklenen değeri ve varyansı sırasıyla şöyledir:
\[E[X]=\frac{1}{\lambda}, \qquad Var(X)=\frac{1}{\lambda^2}\]Dolayısıyla $\lambda$ büyüdükçe olaylar daha sık gerçekleşir ve bekleme süreleri kısalır.
| $\lambda$ | Ortalama bekleme | Genel davranış |
|---|---|---|
| 0.5 | 2 birim | Olaylar seyrek |
| 1 | 1 birim | Dengeli bekleme |
| 5 | 0.2 birim | Olaylar sık |
Ters dönüşüm yöntemi
Bilgisayarlar genellikle $[0,1)$ aralığında düzgün dağılımlı sözde rastgele sayılar üretir. Bizim görevimiz, $U\sim Uniform(0,1)$ değerini üstel dağılımlı bir $X$ değerine dönüştürmektir.
Kümülatif dağılımı $U$ değerine eşitleyelim:
\[U=1-e^{-\lambda X}\]Denklemi $X$ için çözdüğümüzde ters dönüşüm formülüne ulaşırız:
\[X=-\frac{\ln(1-U)}{\lambda}\]$1-U$ da düzgün dağılımlı olduğundan pratikte $X=-\ln(U)/\lambda$ biçimi de kullanılabilir. Bununla birlikte $U=0$ durumunda $\ln(0)$ tanımsızdır. Sayısal açıdan güvenli uygulamalarda sınır değerlerine dikkat edilmelidir.
| Yaklaşım | Avantaj | Dikkat edilmesi gereken |
|---|---|---|
| $-\ln(U)/\lambda$ | Basit ve hızlı | $U=0$ olmamalı |
| $-\ln(1-U)/\lambda$ | Formülü doğrudan izler | $U$ bire çok yakın olabilir |
log1p(-U) kullanımı |
Küçük sayılarda daha kararlı | Dil desteği gerekir |
Python ile üretim
Aşağıdaki fonksiyon, ters dönüşüm yöntemini kullanarak istenen miktarda üstel dağılımlı değer üretir:
import math
import random

def ustel_sayilar(lam, adet):
    if lam <= 0:
        raise ValueError("lambda pozitif olmalıdır")

    sonuclar = []
    for _ in range(adet):
        u = random.random()
        x = -math.log1p(-u) / lam
        sonuclar.append(x)

    return sonuclar

ornekler = ustel_sayilar(lam=2, adet=10_000)
print("Örnek ortalama:", sum(ornekler) / len(ornekler))
print("Teorik ortalama:", 1 / 2)
Burada random.random() düzgün dağılımlı $U$ değerini üretir. math.log1p(-u), özellikle $u$ sıfıra yakınken $\ln(1-u)$ hesabını daha kararlı gerçekleştirir. On bin örneğin ortalaması, teorik değer olan $1/\lambda=0.5$ civarında çıkmalıdır.
Python ayrıca aynı işlemi hazır olarak sunar:
bekleme_suresi = random.expovariate(2.0)
Sonuçları nasıl doğrularız?
Tek birkaç sonuca bakmak yanıltıcıdır; rastgelelik küçük örneklerde hayli şakacıdır. Çok sayıda değer üretip örnek ortalamasını $1/\lambda$ ile, örnek varyansını da $1/\lambda^2$ ile karşılaştırmak daha anlamlıdır. Histogram çizildiğinde değerlerin sıfır yakınında yoğunlaşıp sağa doğru azaldığı görülmelidir.
Üstel dağılım ayrıca belleksizlik özelliğine sahiptir:
\[P(X>s+t\mid X>s)=P(X>t)\]Yani şimdiye kadar ne kadar beklediğimiz, kalan bekleme süresinin dağılımını değiştirmez. Bu özellik; kuyruk sistemleri, ağ trafiği, güvenilirlik analizleri ve Monte Carlo simülasyonlarında üstel dağılımı son derece kullanışlı hâle getirir.
Yorumlar