İçindekiler
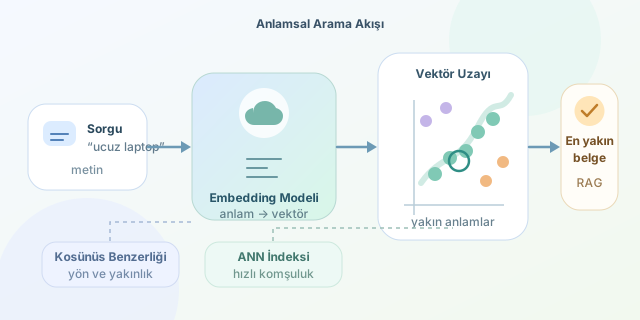
Klasik arama motorları kelimeleri eşleştirir; vektör veritabanları ise kelimelerin arkasındaki anlamı yakalamaya çalışır. Örneğin “uygun fiyatlı dizüstü bilgisayar” araması, metinde birebir “ucuz laptop” yazsa bile doğru sonucu bulabilir. Bu yeteneğin merkezinde embedding modelleri, benzerlik ölçümleri ve milyonlarca vektör arasında hızla komşu bulabilen özel indeksler bulunur.
``
Metinler nasıl sayılara dönüşüyor?
Bilgisayarlar kavramları doğrudan anlayamaz; onları sayısal biçimde temsil eder. Bir embedding modeli, metin, görsel veya ses gibi bir veriyi çok boyutlu bir vektöre dönüştürür:
\[x = [x_1, x_2, x_3, ..., x_d]\]Buradaki $d$, vektörün boyut sayısıdır. Modern metin modellerinde bu değer yüzlerce veya binlerce olabilir. Benzer anlama sahip içeriklerin vektörleri uzayda birbirine yakın konumlanır. Böylece “köpek maması” ile “evcil hayvan besini” yakınlaşırken, “vergi mevzuatı” daha uzakta kalır.
Bir sorgu geldiğinde aynı embedding modeli sorguyu da vektöre çevirir. Ardından veritabanı, sorgu vektörüne en yakın kayıtları arar. Yani mesele artık kelime bulmak değil, geometrik komşuluk bulmaktır.
Benzerlik nasıl ölçülür?
En yaygın yöntemlerden biri kosinüs benzerliğidir:
\[similarity(A,B) = \frac{A \cdot B}{\Vert A\Vert \,\Vert B\Vert }\]Bu ölçüm, iki vektör arasındaki açıyı dikkate alır. Sonuç $1$ değerine yaklaştıkça vektörlerin yönleri ve dolayısıyla anlamları daha benzer kabul edilir. Öklid uzaklığı ise iki nokta arasındaki düz çizgi mesafesini hesaplar.
| Yöntem | Neyi ölçer? | Uygun kullanım |
|---|---|---|
| Kosinüs benzerliği | Vektörlerin yönünü | Metin ve belge arama |
| Öklid uzaklığı | Noktalar arasındaki mesafeyi | Görsel ve konum kümeleri |
| İç çarpım | Yön ile büyüklüğü | Öneri ve sıralama sistemleri |
Doğru ölçüm, kullanılan embedding modelinin nasıl eğitildiğine bağlıdır. Model kosinüs benzerliği için hazırlanmışsa rastgele başka bir metrik seçmek, pusulayla çorba karıştırmaya benzeyebilir: Araç çalışır ama sonuç pek iştah açıcı olmaz.
Neden normal veritabanı yetmiyor?
İlişkisel veritabanları kesin eşleşme, filtreleme ve transaction işlemlerinde harikadır. Ancak milyonlarca yüksek boyutlu vektörü tek tek karşılaştırmak pahalıdır. Vektör veritabanları, yaklaşık en yakın komşu anlamına gelen ANN algoritmalarını kullanır.
| Özellik | İlişkisel veritabanı | Vektör veritabanı |
|---|---|---|
| Temel arama | Kesin değer eşleşmesi | Anlamsal benzerlik |
| Tipik indeks | B-tree | HNSW, IVF, PQ |
| Güçlü olduğu alan | Siparişler, kullanıcılar | Belgeler, öneriler, RAG |
| Sorgu örneği | id = 42 |
“Buna benzeyenleri getir” |
HNSW, vektörleri katmanlı bir komşuluk grafında düzenler. Arama üst katmanlarda büyük sıçramalarla başlar, alt katmanlarda hassaslaşır. Böylece her kayıtla karşılaştırma yapmak yerine umut vadeden bölgeler gezilir.
Küçük bir anlamsal arama örneği
Aşağıdaki Python kodu, cümleleri embedding’e dönüştürür ve sorguya en yakın sonucu seçer:
from sentence_transformers import SentenceTransformer
from sklearn.metrics.pairwise import cosine_similarity

model = SentenceTransformer("all-MiniLM-L6-v2")

belgeler = [
    "Python ile web uygulaması geliştirme",
    "Kediler için sağlıklı beslenme önerileri",
    "Django projesini sunucuya dağıtma"
]

belge_vektorleri = model.encode(belgeler)
sorgu_vektoru = model.encode(["Python web projesi yayınlama"])

skorlar = cosine_similarity(sorgu_vektoru, belge_vektorleri)[0]
en_iyi = skorlar.argmax()

print(belgeler[en_iyi], skorlar[en_iyi])
Kod, sorguda “Django” kelimesi geçmese bile üçüncü belgeyi güçlü bir aday olarak belirleyebilir. Gerçek sistemlerde bu vektörler Pinecone, Weaviate, Milvus, Qdrant veya pgvector gibi çözümlerde saklanır.
RAG ve ötesi
Vektör veritabanları özellikle RAG mimarisinde önemlidir. Kullanıcının sorusuna benzeyen belgeler bulunur, bu belgeler bir dil modeline bağlam olarak verilir ve daha güvenilir yanıt üretilir. Aynı yaklaşım ürün önerisi, benzer görsel bulma, dolandırıcılık tespiti ve müşteri destek sistemlerinde de kullanılabilir.
Yine de embedding modeli, indeks türü, filtreler ve güncelleme stratejisi birlikte tasarlanmalıdır. Vektör veritabanı sihirli bir hafıza değil; anlamı koordinatlara çevirip yakın komşuları olağanüstü hızla bulan, iyi ayarlanması gereken bir arama motorudur.
Yorumlar