İçindekiler
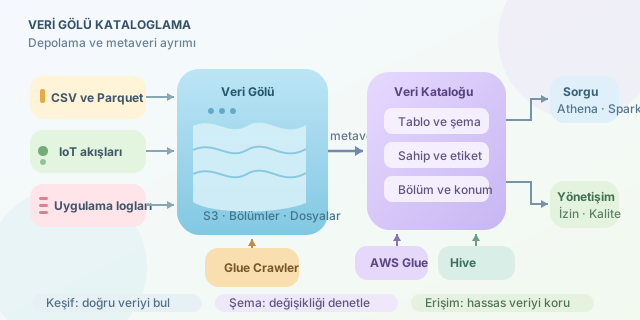
Veri gölü, ham CSV dosyalarından IoT akışlarına, Parquet tablolarından uygulama loglarına kadar farklı kaynakları düşük maliyetle saklar. Fakat klasörler büyüdükçe klasik “dosya nerede?” yaklaşımı hızla yetersiz kalır. Veri kataloglama; dosyaların fiziksel konumunu, şemasını, sahipliğini, etiketlerini ve kullanım kurallarını merkezi bir envantere dönüştürür. Böylece analistler doğru veriyi bulur, veri mühendisleri aynı tabloyu tekrar üretmez, yönetişim ekipleri ise erişimi denetlenebilir biçimde yönetir.
``
Bir veri gölünde depolama ile metaveriyi ayırmak kritik fikirdir. Örneğin S3 üzerindeki s3://göl/satis/yil=2026/ay=08/ yolu verinin kendisini taşırken, katalog bu yolun satis adlı bir tabloya ait olduğunu; tarih, musteri_id ve tutar sütunlarını içerdiğini belirtir. Sorgu motoru—Athena, Spark, Trino veya Hive—dosyaları rastgele yorumlamak yerine bu metaveriyi kullanır. Basitçe, sorgulanacak veri miktarı şu ilişkiyle düşünülebilir:
Burada $P$ okunan bölüm (partition) sayısı, $B$ ise bölüm başına ortalama veri boyutudur. Tarih bölümlendirmesi ve doğru katalog kaydı, $P$ değerini düşürerek hem maliyeti hem sorgu süresini azaltır.
AWS Glue Data Catalog: Yönetilen Metaveri Katmanı
AWS Glue Data Catalog, veritabanları, tablolar, partition’lar ve bağlantılar için yönetilen bir katalog servisidir. Glue Crawler, S3’teki dosyaları tarar; JSON, CSV, Avro veya Parquet gibi biçimleri algılar ve başlangıç şemasını çıkarır. Bu otomasyon özellikle keşif aşamasında çok değerlidir. Ancak crawler’ın ürettiği şema “kesin doğru” kabul edilmemelidir: 00123 gibi bir müşteri kodu yanlışlıkla sayısal türe dönüşebilir. Üretimde şema değişikliklerini inceleme akışına bağlamak daha güvenlidir.
import boto3

glue = boto3.client("glue")
response = glue.get_table(
    DatabaseName="analitik",
    Name="satis"
)

columns = response["Table"]["StorageDescriptor"]["Columns"]
for column in columns:
    print(f"{column['Name']}: {column['Type']}")
Bu orta düzey örnek, Glue kataloğundan tablo şemasını programatik olarak okur. CI/CD hattında eski ve yeni şemayı karşılaştırmak, beklenmeyen sütun silinmelerini erkenden yakalamak için kullanılabilir.
Hive Metastore: Açık Ekosistemin Ortak Dili
Hive Metastore, Hive kökenli olsa da Spark SQL, Presto/Trino ve birçok Hadoop aracı tarafından desteklenen yaygın bir metaveri servisidir. Kurum içi Hadoop kümelerinde veya bulut bağımsız tasarımlarda güçlü bir tercihtir. AWS Glue Data Catalog, uygun yapılandırmayla Hive Metastore uyumlu bir arayüz gibi de kullanılabilir; bu sayede AWS servisleri ile Hive uyumlu motorlar ortak tablo tanımlarından yararlanabilir.
| Özellik | AWS Glue Data Catalog | Hive Metastore |
|---|---|---|
| İşletim modeli | AWS tarafından yönetilir | Genellikle ekip tarafından işletilir |
| Ekosistem | Athena, Glue, Lake Formation | Hive, Spark, Trino, Hadoop |
| Şema keşfi | Crawler ile yerleşik | Harici araç veya komutlarla |
| Altyapı yükü | Düşük | Veritabanı ve servis yönetimi gerekir |
Keşiften Yönetişime Geçiş
İyi katalog yalnızca tablo adları listesi değildir. Her varlık için veri sahibi, iş tanımı, güncellenme sıklığı, hassasiyet etiketi ve kalite seviyesi kaydedilmelidir. Örneğin musteri_eposta sütununu “kişisel veri” olarak etiketlemek, bu alanın kimlerce görülebileceğine dair politikanın temelidir. AWS Lake Formation, Glue kataloğu üzerindeki tablo, sütun ve satır düzeyi izinleri merkezileştirebilir.
| Yönetişim ihtiyacı | Katalogdaki karşılığı | Pratik sonuç |
|---|---|---|
| Veriyi bulmak | Açıklama, etiket, sahip | Daha hızlı self-service analiz |
| Güvenlik | Sütun sınıflandırması, izin | Hassas alanlara kontrollü erişim |
| İzlenebilirlik | Kaynak ve güncelleme bilgisi | Hatalı verinin kökenini bulma |
| Kalite | Şema ve tazelik kuralları | Bozuk yükleri erken fark etme |
Başarılı başlangıç için önce yüksek değerli veri kümelerini kataloglayın, isimlendirme standardı belirleyin ve partition stratejisini belgeleyin. Ardından crawler otomasyonunu, şema onay süreçlerini ve erişim politikalarını ekleyin. Böylece veri gölü, içinde veri bulunan büyük bir depodan; güvenilir, keşfedilebilir ve denetlenebilir bir veri platformuna dönüşür.
Yorumlar