İçindekiler
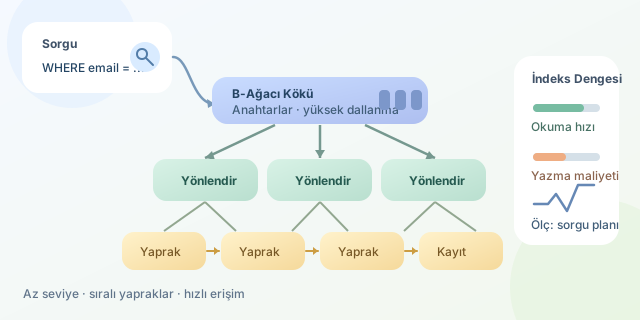
Bir veritabanı tablosunda milyonlarca kayıt varken WHERE email = '...' sorgusunun milisaniyeler içinde dönmesi sihir değildir; çoğu zaman arka planda çalışan bir B-ağacı indeksidir. İndeksler, kitabın sonundaki alfabetik dizin gibidir: Her sayfayı tek tek okumak yerine, aranan bilginin bulunduğu yere yönlendirir. Ancak her sütuna gelişigüzel indeks koymak da çözüm değildir; doğru indeks stratejisi, okuma performansı ile yazma maliyeti arasında dikkatli bir denge kurar.
``
B-ağacı neden hızlıdır?
B-ağacı (B-tree), veritabanı sistemlerinin en sık kullandığı dengeli arama ağacı yapısıdır. Klasik ikili arama ağacında her düğümün en fazla iki çocuğu bulunurken, B-ağacındaki bir düğüm çok sayıda anahtar ve çocuk işaretçisi taşıyabilir. Bu yüksek dallanma oranı, ağacın yüksekliğini dramatik biçimde azaltır.
Bir B-ağacında arama maliyeti kabaca aşağıdaki gibidir:
\[T(n) = O(\log_b n)\]Burada $n$ kayıt sayısını, $b$ ise düğüm başına ortalama dallanma oranını ifade eder. Örneğin her indeks sayfası yaklaşık 200 yönlendirme saklayabiliyorsa, 1 milyon kayda ulaşmak için yaklaşık $\log_{200}(1.000.000) \approx 3$ seviye yeterlidir. Yani diskten üç-dört indeks sayfası okumak, milyonlarca satırı taramaktan çok daha ucuzdur.
| Yaklaşım | Kayıt bulma maliyeti | 1 milyon kayıtta davranış | Uygun kullanım |
|---|---|---|---|
| Tam tablo taraması | $O(n)$ | Potansiyel olarak 1 milyon satır incelenir | Küçük tablolar, geniş sonuç kümeleri |
| İkili arama | $O(\log_2 n)$ | Yaklaşık 20 karşılaştırma | Bellek içi sıralı yapılar |
| B-ağacı indeks | $O(\log_b n)$ | Genellikle 3-4 sayfa erişimi | Eşitlik, aralık ve sıralama sorguları |
B-ağaçlarının bir diğer önemli gücü, yaprak düğümlerinin sıralı olmasıdır. Bu sayede BETWEEN, <, >, ORDER BY ve önek tabanlı LIKE 'ali%' sorguları verimli çalışır. Veritabanı, başlangıç anahtarını bulur; sonra yaprak sayfaları sırayla dolaşır.
Doğru sütunu indekslemek
İndeks, en çok filtrelenen, birleştirilen veya sıralanan sütunlarda anlamlıdır. Örneğin kullanıcı e-postası benzersiz ve seçiciliği yüksek bir alandır. Buna karşılık aktif_mi gibi yalnızca iki değer içeren bir boolean sütun, tek başına çoğu zaman zayıf bir adaydır. Çünkü sorgu sonuçlarının büyük kısmı yine okunmak zorunda kalabilir.
CREATE INDEX idx_users_email ON users (email);

SELECT id, full_name
FROM users
WHERE email = '[email protected]';
Bu indeks, email üzerinden doğrudan ilgili kayıt konumuna gider. Ancak sorgu aşağıdaki biçimdeyse indeks kullanımı zorlaşabilir:
SELECT *
FROM users
WHERE LOWER(email) = '[email protected]';
Fonksiyon çağrısı, normal email indeksindeki sıralamayı doğrudan kullanmayı engelleyebilir. Çözüm olarak fonksiyonel indeks oluşturulabilir:
CREATE INDEX idx_users_lower_email ON users (LOWER(email));
Bileşik indekslerde sütun sırası
Birden fazla koşulu olan sorgularda bileşik indeksler güçlüdür. Fakat (ulke, created_at) ile (created_at, ulke) aynı şey değildir. B-ağacındaki sıralama ilk sütundan başlar; bu nedenle sol önek kuralı kritik önemdedir.
| İndeks | Verimli sorgu örneği | Zayıf sorgu örneği |
|---|---|---|
(ulke, created_at) |
WHERE ulke = 'TR' AND created_at >= ... |
WHERE created_at >= ... |
(created_at, ulke) |
WHERE created_at >= ... |
WHERE ulke = 'TR' |
Genel kural, önce eşitlik ile filtrelenen sütunları, ardından aralık veya sıralama sütunlarını yerleştirmektir. Örneğin sipariş ekranında müşteri seçilip tarih aralığı taranıyorsa (customer_id, order_date) mantıklı bir tercihtir.
İndeksin bedeli ve ölçüm kültürü
İndeks ücretsiz değildir. Her INSERT, UPDATE ve DELETE işleminde B-ağacının güncellenmesi gerekir. Sayfalar bölünebilir, depolama alanı artar ve yazma işlemleri yavaşlayabilir. Bu yüzden “her kolona indeks” yaklaşımı performans optimizasyonu değil, bakım borcudur.
En güvenilir karar mekanizması sorgu planıdır. PostgreSQL’de EXPLAIN ANALYZE, MySQL’de ise EXPLAIN kullanarak optimizer’ın indeks taraması mı yoksa tam tablo taraması mı seçtiğini inceleyin. İyi indeks; popüler sorguları hızlandıran, gereksiz yazma maliyeti yaratmayan ve gerçek ölçümlerle doğrulanmış indekstir.
Yorumlar