İçindekiler
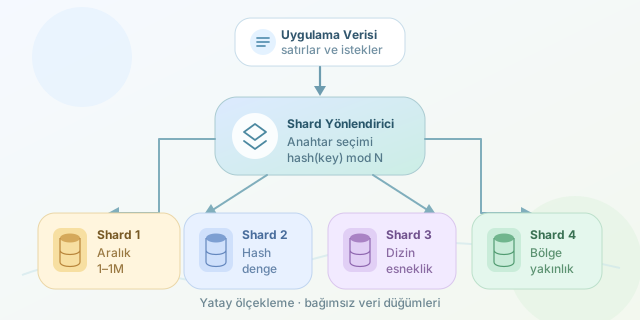
Uygulamanız büyüdükçe tek bir veritabanı sunucusu; işlemci, bellek, disk ve bağlantı sınırlarına yaklaşır. Daha güçlü bir sunucuya geçmek dikey ölçekleme olarak adlandırılır, ancak bunun hem fiziksel hem de ekonomik bir tavanı vardır. Sharding, satırları birden fazla bağımsız veritabanına dağıtarak yatay ölçekleme sağlar. Kısacası dev bir dosya dolabını büyütmeye çalışmak yerine, belgeleri düzenli biçimde farklı dolaplara yerleştiririz.
``
Sharding tam olarak nedir?
Bir tabloyu users, users_2 gibi aynı sunucuda parçalamak her zaman gerçek sharding değildir. Sharding yaklaşımında her shard, veri kümesinin belirli bir bölümünü barındıran bağımsız bir veritabanı düğümüdür. Satırların hangi düğüme gideceğine ise shard key denilen alan karar verir.
Toplam veri miktarı $D$, shard sayısı $N$ ise ideal ve dengeli dağılımda her düğümün taşıdığı veri yaklaşık olarak şöyledir:
\[D_{shard} \approx \frac{D}{N}\]Gerçek dünyada kullanıcı davranışları eşit olmadığı için bu formül bir hedeftir; garanti değildir. Bir müşterinin milyonlarca kaydı varken diğerlerinin yüzlerce kaydı bulunabilir.
| Yaklaşım | Dağıtım mantığı | Güçlü yanı | Temel riski |
|---|---|---|---|
| Range sharding | Anahtar aralıkları | Aralık sorguları hızlıdır | Sıcak shard oluşabilir |
| Hash sharding | Anahtarın özeti | Dengeli dağılım sağlar | Aralık sorguları zorlaşır |
| Directory sharding | Eşleme tablosu | Esnek yönlendirme sunar | Merkezi dizin bağımlılığı yaratır |
| Coğrafi sharding | Bölge veya ülke | Düşük gecikme sağlar | Bölgeler arası işlemler karmaşıktır |
Yaygın stratejiler
Aralık tabanlı sharding
Kayıtlar belirli aralıklara ayrılır. Örneğin kullanıcı kimlikleri 1–1.000.000 arasındaysa ilk shard, sonraki aralık ikinci shard tarafından tutulabilir. Tarih tabanlı kayıtlar için de kullanışlıdır. Ancak sürekli artan kimliklerde bütün yeni yazmalar son shard’a yönelir. Bu duruma hotspot denir.
Hash tabanlı sharding
Shard, anahtarın hash değerinden hesaplanır:
\[shardId = hash(key) \bmod N\]Basitleştirilmiş bir Python yönlendiricisi şöyle yazılabilir:
import hashlib

def select_shard(user_id: str, shard_count: int) -> int:
    digest = hashlib.sha256(user_id.encode()).hexdigest()
    numeric_hash = int(digest, 16)
    return numeric_hash % shard_count
Bu kod, aynı kullanıcıyı daima aynı shard’a gönderir ve yükü genellikle dengeli dağıtır. Fakat shard sayısı değiştiğinde mod sonucu da değişir; çok sayıda kayıt taşınmak zorunda kalabilir. Bu problemi azaltmak için consistent hashing kullanılabilir.
Directory tabanlı sharding
tenant_id -> shard_id eşleşmesi ayrı bir katalogda tutulur. Böylece büyük bir müşteri başka bir shard’a taşınabilir. Esneklik yüksektir, fakat katalog servisinin önbelleklenmesi, çoğaltılması ve kesintilere dayanıklı tasarlanması gerekir. Aksi hâlde veriler sağlam olsa bile uygulama onların adresini bulamaz.
Doğru shard key nasıl seçilir?
İyi bir shard key yüksek çeşitliliğe sahip olmalı, yükü dengeli dağıtmalı ve sık kullanılan sorgularla uyumlu çalışmalıdır. Çok kiracılı bir SaaS uygulamasında tenant_id mantıklı olabilir; kullanıcının tüm verileri aynı yerde kalır. Buna karşılık yalnızca country kullanmak, trafiğin çoğu tek ülkeden geliyorsa dengesizlik yaratır.
| Soru | İyi işaret | Kötü işaret |
|---|---|---|
| Değerler çeşitli mi? | Milyonlarca kullanıcı kimliği | Birkaç ülke kodu |
| Sorgular anahtarı içeriyor mu? | WHERE tenant_id = ? |
Anahtarsız genel tarama |
| Trafik dengeli mi? | Benzer müşteri yükleri | Tek dev müşteri |
| Anahtar değişiyor mu? | Değişmeyen kimlik | Sık güncellenen bölge |
Sharding’in görünmeyen faturası
Shard’lar arası JOIN, global sıralama ve benzersizlik kontrolleri zorlaşır. Dağıtık transaction gerektiğinde iki aşamalı commit gibi yöntemler gecikme ve hata senaryolarını artırır. Otomatik artan kimlikler yerine UUID veya Snowflake benzeri dağıtık kimlikler tercih edilebilir. Yedekleme, şema migrasyonu, izleme ve yeniden dengeleme de tüm shard’larda koordineli yürütülmelidir.
Bu nedenle sharding ilk performans refleksi olmamalıdır. Önce indeksleme, sorgu optimizasyonu, önbellekleme, read replica ve arşivleme değerlendirilmelidir. Tek düğüm gerçekten sınırına ulaştığında ise iyi seçilmiş shard key, otomatik yönlendirme ve gözlemlenebilirlik sayesinde sharding güçlü bir ölçekleme aracına dönüşür. Veriyi bölmek kolaydır; sistemi anlaşılır ve dengeli tutmak asıl mühendislik işidir.
Yorumlar