İçindekiler
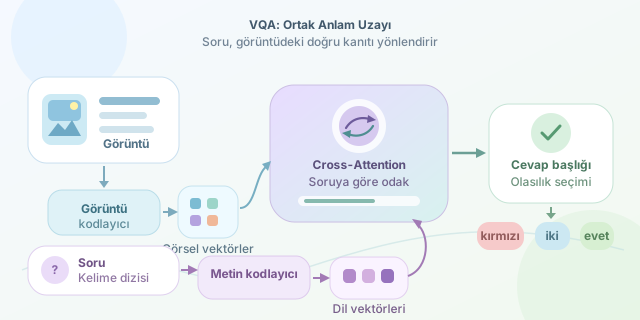
Bir fotoğrafa bakıp “Masanın üzerindeki kupa ne renk?” sorusunu cevaplamak insanlar için sıradan, makineler içinse iki farklı dünyayı uzlaştırma problemidir. Görüntü piksellerden, soru ise kelimelerden oluşur. Görsel Soru Cevaplama (Visual Question Answering, VQA) sistemlerinin temel görevi, bu iki veri türünü karşılaştırılabilir vektörlere dönüştürerek ortak bir anlam uzayında buluşturmaktır.
``
İki farklı dil: Piksel ve kelime
Bir VQA modeli genellikle üç ana parçadan oluşur: görüntü kodlayıcı, metin kodlayıcı ve füzyon modülü. Görüntü kodlayıcı resimdeki nesne, renk, konum ve doku gibi özellikleri çıkarır. Metin kodlayıcıysa sorunun sözdizimini ve anlamsal niyetini temsil eder.
| Bileşen | Girdi | Çıktı | Öğrendiği bilgi |
|---|---|---|---|
| Görüntü kodlayıcı | Piksel matrisi | Görsel vektörler | Nesneler, bölgeler, ilişkiler |
| Metin kodlayıcı | Token dizisi | Dil vektörleri | Kelime anlamı, bağlam, soru tipi |
| Füzyon modülü | İki vektör kümesi | Ortak temsil | Soruya uygun görsel kanıt |
| Cevap başlığı | Ortak temsil | Olasılık dağılımı | En olası cevap |
Modern sistemlerde görüntü, Vision Transformer veya CNN tarafından işlenebilir. Bir Vision Transformer resmi küçük yamalara böler. Her yama bir vektöre çevrilir:
\[z_i = W_p x_i + e_i\]Burada $x_i$ bir görüntü yamasını, $W_p$ öğrenilebilir projeksiyonu, $e_i$ ise konum bilgisini temsil eder. Metin tarafında soru token’lara ayrılır ve benzer biçimde gömme vektörlerine dönüştürülür.
Ortak uzaya projeksiyon
Görsel ve metinsel vektörlerin boyutları başlangıçta farklı olabilir. Örneğin görüntü kodlayıcı 1024, dil modeli 768 boyutlu çıktı üretebilir. Öğrenilebilir doğrusal katmanlar, iki temsili aynı $d$ boyutuna taşır:
\[v' = W_vv, \qquad q' = W_qq\]Ama boyutların eşitlenmesi tek başına yeterli değildir. Modelin “kırmızı” sözcüğüyle kırmızı bölgeler arasında anlamsal bağ kurması gerekir. Bu bağlantı, eğitim sırasında soru-cevap örneklerinden ve çoğu zaman görüntü-metin eşleştirme hedeflerinden öğrenilir.
Cross-attention: Soruyla görüntüye bakmak
Kesişimin asıl yıldızı cross-attention mekanizmasıdır. Metin vektörleri sorgu, görsel vektörler anahtar ve değer olarak kullanılabilir:
\[\text{Attention}(Q,K,V)=\text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]“Kaç köpek var?” sorusunda modelin gökyüzü veya sandalye yamalarına değil, köpek içeren bölgelere yüksek dikkat vermesi beklenir. Böylece bütün görüntüyü tek bir özete sıkıştırmak yerine, soruya bağlı dinamik bir görsel temsil üretilir.
| Füzyon yaklaşımı | Avantaj | Dezavantaj |
|---|---|---|
| Toplama/çarpma | Hızlı ve basit | Karmaşık ilişkilerde zayıf |
| Birleştirme | Bilgiyi korur | Vektör boyutunu büyütür |
| Bilinear füzyon | Güçlü etkileşim yakalar | Hesaplama maliyetlidir |
| Cross-attention | Soruya özel bölgeleri seçer | Bellek ve veri ihtiyacı yüksektir |
Aşağıdaki sade PyTorch örneği, iki modaliteyi aynı boyuta getirip attention ile birleştirir:
import torch
from torch import nn

class VQAFusion(nn.Module):
    def __init__(self, image_dim, text_dim, hidden_dim=512):
        super().__init__()
        self.image_projection = nn.Linear(image_dim, hidden_dim)
        self.text_projection = nn.Linear(text_dim, hidden_dim)
        self.attention = nn.MultiheadAttention(
            hidden_dim, num_heads=8, batch_first=True
        )

    def forward(self, image_tokens, text_tokens):
        visual = self.image_projection(image_tokens)
        question = self.text_projection(text_tokens)

        # Soru token'ları, ilgili görüntü bölgelerinden bilgi toplar.
        fused, weights = self.attention(
            query=question, key=visual, value=visual
        )
        return fused.mean(dim=1), weights
Üretilen ortak temsil, sınıflandırma katmanına verilerek “kırmızı”, “iki” veya “evet” gibi cevaplardan biri seçilebilir. Üretken VQA modellerindeyse bu temsil bir dil modelini koşullandırır ve cevap token token oluşturulur.
Aynı uzay, aynı anlayış mı?
Ortak vektör uzayı sihirli bir bilinç alanı değildir; eğitim verisindeki ilişkilerin geometrik bir özetidir. Benzer görüntü-metin çiftleri birbirine yaklaştırılırken alakasız çiftler uzaklaştırılabilir. Kontrastif öğrenmede amaç kabaca doğru çiftin benzerliğini artırmaktır:
\[\mathcal{L}=-\log\frac{\exp(\text{sim}(v,q)/\tau)}{\sum_j \exp(\text{sim}(v,q_j)/\tau)}\]Sonuç olarak başarılı VQA; iyi görsel özellikler, bağlama duyarlı dil temsilleri ve güçlü bir füzyon mekanizmasının ortak ürünüdür. Model yalnızca görmeyi veya okumayı değil, sorunun yönlendirdiği biçimde bakmayı öğrenir. Asıl kesişim de tam burada gerçekleşir: kelimeler dikkati yönetir, görüntü ise cevabın kanıtını sağlar.
Yorumlar