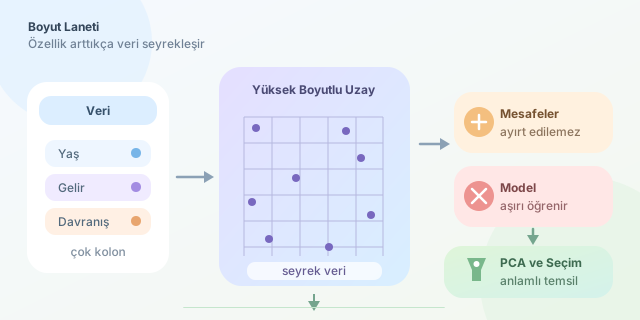
Bir makine öğrenmesi modeline yeni kolonlar eklemek ilk bakışta ona daha fazla ipucu vermek gibi görünür. Yaş, gelir ve şehir faydalıysa tarayıcı, cihaz, tıklama saati ve yüzlerce davranış özelliği de faydalı olmalıdır, değil mi? Ne yazık ki veri biliminin küçük bir şakası vardır: Masaya daha çok bilgi koyarken modelin önündeki haritayı devasa ve neredeyse boş bir çöle çevirebiliriz. İşte buna boyut laneti denir. ``
Veri uzayı neden boşalır?
Her özellik, veri uzayına yeni bir eksen ekler. İki özelliğimiz varsa noktalar bir düzlemde, üç özellikte bir küp içinde bulunur. Boyut sayısı $d$ olduğunda ise örnekler $d$ boyutlu bir uzaya dağılır.
Her ekseni yalnızca 10 parçaya ayırdığımızı düşünelim. Uzayı aynı yoğunlukta temsil etmek için gereken hücre sayısı:
\[N = 10^d\]olur. İki boyutta 100 hücre yeterliyken 10 boyutta 10 milyar hücre oluşur. Veri sayısı aynı kaldığında hücrelerin ezici çoğunluğu boş kalır. Başka bir ifadeyle, kenar uzunluğu $r$ olan bölgenin göreli hacmi $V(r)=r^d$ şeklinde küçülür. Örneğin $r=0.5$ için 20 boyutta hacim yaklaşık milyonda bire iner.
| Boyut sayısı | Hücre sayısı ($10^d$) | Veri yoğunluğu |
|---|---|---|
| 2 | 100 | Yönetilebilir |
| 5 | 100.000 | Seyrek |
| 10 | 10.000.000.000 | Aşırı seyrek |
Algoritmalar neden tökezler?
K-NN ve kümeleme gibi yöntemler, örnekler arasındaki uzaklıklara güvenir. Yüksek boyutlarda en yakın ve en uzak komşuların mesafeleri birbirine yaklaşır. Böylece “yakın komşu” kavramı anlamını kaybeder; herkes birbirine hemen hemen aynı uzaklıktadır.
Karar ağaçları çok sayıda anlamsız bölünme deneyebilir. Doğrusal modeller gereksiz katsayılar öğrenerek varyansı artırabilir. Sinir ağları ise daha fazla parametre ve daha fazla örnek ister. Sonuç çoğunlukla eğitim verisinde harika, yeni veride hayal kırıklığı yaratan overfitting olur.
| Belirti | Olası neden | Sonuç |
|---|---|---|
| Eğitim skoru yüksek, test skoru düşük | Fazla veya gürültülü özellik | Aşırı öğrenme |
| K-NN başarısı aniden düşüyor | Mesafelerin ayırt ediciliği azaldı | Kötü komşuluklar |
| Eğitim süresi büyüyor | Arama uzayı genişledi | Hesaplama maliyeti |
| Model kararsızlaşıyor | Örnek sayısı yetersiz | Yüksek varyans |
Lanet nasıl hafifletilir?
İlk savunma hattı özellik seçimidir. Hedefle ilişkisi zayıf, birbirini tekrar eden veya büyük ölçüde eksik kolonlar çıkarılabilir. L1 düzenlileştirme bazı katsayıları sıfıra iterken ağaç tabanlı modeller özellik önemleri sağlayabilir. Ancak önem değerlerini kesin gerçekler değil, araştırma ipuçları olarak görmek gerekir.
İkinci yaklaşım boyut indirgemedir. PCA, yüksek korelasyonlu özellikleri daha az sayıda bileşende özetler. PCA’nın amacı sınıfları doğrudan ayırmak değil, verideki varyansın mümkün olduğunca büyük bölümünü korumaktır.
from sklearn.decomposition import PCA
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

# Ölçekleme, büyük değerli kolonların PCA'yı yönetmesini önler.
model = make_pipeline(
    StandardScaler(),
    PCA(n_components=0.95),  # Varyansın %95'ini korur.
    LogisticRegression(max_iter=1000)
)

model.fit(X_train, y_train)
print(model.score(X_test, y_test))
Ayrıca çapraz doğrulama kullanmak, özellik sayısını artırdıkça test başarısını izlemek ve modele L1/L2 düzenlileştirme eklemek önemlidir. Görsel, metinsel veya kategorik verilerde alan bilgisiyle üretilmiş kompakt temsiller de yüzlerce ham kolondan daha yararlı olabilir.
Kısacası her yeni özellik ücretsiz bilgi değildir; bazen gürültü, maliyet ve boşluk getirir. İyi veri bilimi, mümkün olan en fazla kolonu toplamak değil, problemi açıklayan en küçük ve anlamlı temsili bulmaktır.
Yorumlar