İçindekiler
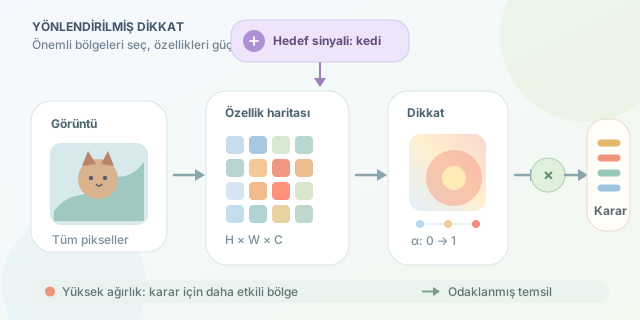
Bir fotoğrafta kedi ararken duvardaki çatlakları, masanın desenini veya perde kıvrımlarını uzun uzun incelemeyiz; gözümüz hızla kulak, göz ve pati gibi ayırt edici bölgelere yönelir. Yönlendirilmiş dikkat (targeted attention), sinir ağlarına benzer bir seçicilik kazandırır. Model bütün pikselleri eşit derecede önemli kabul etmek yerine, yaptığı görev açısından anlamlı bölgelere daha yüksek ağırlık verir. Böylece hem tahminler iyileşebilir hem de ağın kararını nereden çıkardığı daha anlaşılır hâle gelebilir.
``
Dikkat mekanizmasının temel fikri
Bir evrişimli sinir ağı, görüntüyü doğrudan “kedi” veya “otomobil” olarak görmez. Ara katmanlarda $H \times W \times C$ boyutlu özellik haritaları üretir. Burada $H$ ve $W$ uzamsal boyutları, $C$ ise kanal sayısını temsil eder. Dikkat modülü bu özellikler için genellikle $0$ ile $1$ arasında ağırlıklar hesaplar.
Bir konumdaki özellik vektörü $x_i$, dikkat puanı ise $a_i$ olsun. Dikkatli temsil şu şekilde yazılabilir:
\[z = \sum_{i=1}^{N} \alpha_i x_i, \qquad \alpha_i = \frac{e^{a_i}}{\sum_{j=1}^{N} e^{a_j}}\]Softmax sayesinde $\sum_i \alpha_i=1$ olur. Yani model, elindeki sınırlı “ilgi bütçesini” görüntünün farklı bölgelerine dağıtır. Yüksek $\alpha_i$ alan pikseller veya yamalar kararda daha etkili olur.
Hangi dikkat türü neye odaklanır?
| Yaklaşım | Odaklandığı şey | Güçlü yanı | Sınırlaması |
|---|---|---|---|
| Uzamsal dikkat | Görüntüdeki konumlar | Nesnenin bulunduğu alanı vurgular | Arka plan ipuçlarına aldanabilir |
| Kanal dikkati | Özellik kanalları | Renk, kenar veya doku filtrelerini seçer | Konumu doğrudan açıklamaz |
| Self-attention | Bölgeler arası ilişkiler | Uzak pikselleri ilişkilendirir | Hesaplama maliyeti büyüyebilir |
| Sert dikkat | Seçilen birkaç bölge | Verimli ve keskin odak sağlar | Ayrık seçim nedeniyle eğitimi zordur |
| Yumuşak dikkat | Tüm bölgelere ağırlık verir | Türevlenebilir ve kolay eğitilir | Gereksiz bölgelere küçük de olsa pay ayırır |
“Yönlendirilmiş” ifadesi, dikkatin yalnızca görüntü içinden kendiliğinden doğması gerekmediğini de anlatır. Bir sınıf etiketi, metin sorgusu, nesne koordinatı veya önceki video karesi hedef sinyali olabilir. Örneğin “kırmızı çantayı bul” sorgusu verildiğinde model hem kırmızılığa hem de çantaya benzeyen şekillere odaklanır.
Basit bir uzamsal dikkat modülü
Aşağıdaki PyTorch modülü, kanal boyunca ortalama ve maksimum özet çıkarır. Ardından bir evrişim ve sigmoid kullanarak tek kanallı dikkat haritası üretir. Son çarpma işlemi önemli bölgeleri güçlendirir:
import torch
import torch.nn as nn

class SpatialAttention(nn.Module):
    def __init__(self, kernel_size=7):
        super().__init__()
        padding = kernel_size // 2
        self.score = nn.Conv2d(
            2, 1, kernel_size, padding=padding, bias=False
        )

    def forward(self, features):
        average = features.mean(dim=1, keepdim=True)
        maximum, _ = features.max(dim=1, keepdim=True)
        summary = torch.cat([average, maximum], dim=1)
        attention = torch.sigmoid(self.score(summary))
        focused = features * attention
        return focused, attention
Buradaki attention, görselleştirilebilen bir ısı haritasıdır. Ancak parlak bir bölge görmek, modelin karar nedenini kesin olarak kanıtlamaz. Dikkat haritası açıklanabilirlik için yararlı bir ipucu olsa da nedensellik testi değildir.
Model gerçekten doğru yere mi bakıyor?
Sadece doğruluk ölçmek yeterli değildir. Dikkat haritası insan tarafından işaretlenmiş nesne maskesiyle karşılaştırılabilir. Eşiklenmiş dikkat alanı $A$, gerçek bölge $G$ ise kesişim-birleşim oranı şöyledir:
\[IoU = \frac{\vert A \cap G\vert }{\vert A \cup G\vert }\]Ayrıca görüntünün en dikkatli kısmını kapatıp tahmin güveninin düşüp düşmediği incelenebilir. Güven belirgin biçimde azalıyorsa model gerçekten o bölgeden yararlanıyor olabilir. Tersine, nesne yerine filigrana odaklanan bir ağ veri kümesindeki kestirme yolları öğrenmiş demektir.
Yönlendirilmiş dikkat; tıbbi görüntüleme, otonom sürüş, nesne takibi ve görsel soru cevaplama gibi alanlarda modelin enerjisini doğru yere toplar. Kısacası mesele daha fazla piksel görmek değil, hangi pikselin neden önemli olduğunu öğrenmektir.
Yorumlar