Bir metin içinde belirli bir deseni aramak, ilk bakışta basit görünür: her konumdan başlayıp karakterleri karşılaştırırız. Ancak uzun metinler ve tekrar eden örüntüler devreye girdiğinde bu yaklaşım pahalılaşır. Z Algoritması, daha önce yapılmış karşılaştırmaları akıllıca yeniden kullanarak örüntü eşleştirmeyi doğrusal zamanda gerçekleştiren zarif bir tekniktir.
``
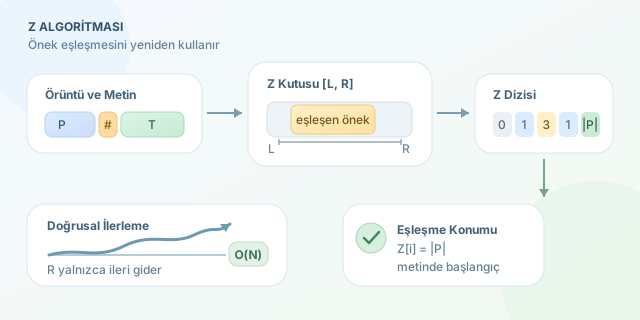
Temel fikir, bir dizinin her konumunda dizinin başıyla eşleşen en uzun önekin uzunluğunu hesaplamaktır. Bu değerlerden oluşan yapıya Z dizisi denir. Bir S dizisi için Z[i], S[i...] ile S dizisinin başlangıcı arasındaki en uzun ortak önek uzunluğudur. Başlangıç konumu için Z[0] çoğu uygulamada 0 kabul edilir; bazı tanımlarda ise dizinin uzunluğu yazılır.
Örneğin S = "aabcaabxaaaz" olsun. i = 4 konumunda başlayan alt dizi "aabxaaaz"dır. Bu alt dizinin, ana dizinin başındaki "aabc..." ile ortak öneki "aab" olduğundan Z[4] = 3 olur. Aranan örüntü P, metin T ise şu birleşik dizi oluşturulur:
Buradaki $, hem örüntüde hem metinde bulunmadığı garanti edilen bir ayraç karakteridir. Z dizisinde \vert P\vert değerini gördüğümüz her indeks, metinde örüntünün eksiksiz bulunduğu bir konuma karşılık gelir. Ayraç, örüntünün metin bölümüne taşarak sahte bir eşleşme üretmesini engeller.
\vert Yaklaşım \vert En kötü durum karmaşıklığı \vert Önceki eşleşmeleri kullanır mı? \vert \vert —\vert —:\vert —\vert \vert Naif arama \vert $O(n \cdot m)$ \vert Hayır \vert \vert Z Algoritması \vert $O(n+m)$ \vert Evet \vert \vert KMP \vert $O(n+m)$ \vert Evet \vert
Z Algoritmasının hız sırrı Z kutusudur. [L, R] aralığı, dizinin başlangıcıyla eşleştiği bilinen en sağdaki aralığı temsil eder. Yeni bir i indeksi bu kutunun dışındaysa karşılaştırmalar doğrudan yapılır. i kutunun içindeyse, simetrik konumdaki önceden hesaplanmış Z değeri başlangıç tahmini sağlar. Sadece bu tahmin kutunun sağ sınırını aşarsa yeni karakter karşılaştırmaları gerekir.
Bu mekanizmanın doğrusal çalışmasının sezgisel nedeni şudur: İç döngü ilk bakışta tehlikeli görünse de R sınırı sürekli sola geri dönmez. Her başarılı yeni karşılaştırma, sağ sınırı ilerletir. Dolayısıyla toplam karakter inceleme sayısı dizinin uzunluğu ile orantılı kalır:
Aşağıdaki Python kodu, önce Z dizisini hesaplar; ardından bu diziyi metin aramada kullanır:
def z_array(s):
    z = [0] * len(s)
    left = right = 0

    for i in range(1, len(s)):
        if i <= right:
            z[i] = min(right - i + 1, z[i - left])

        while i + z[i] < len(s) and s[z[i]] == s[i + z[i]]:
            z[i] += 1

        if i + z[i] - 1 > right:
            left, right = i, i + z[i] - 1
    return z


def z_search(pattern, text):
    combined = pattern + "#" + text
    z = z_array(combined)
    m = len(pattern)
    return [i - m - 1 for i, value in enumerate(z) if value == m]

print(z_search("ana", "bananalar ana vatanda yetişir"))
# [1, 3, 10]
Kodda z_array, tüm teorik yükü taşıyan fonksiyondur. left ve right değişkenleri aktif Z kutusunu saklar. z_search ise ayraçla birleşik diziyi kurar ve Z değeri örüntü uzunluğuna eşit olan indeksleri metindeki başlangıç konumlarına dönüştürür.
| Kavram | Görevi | KMP’deki yakın karşılığı |
|---|---|---|
| Z değeri | Her konumdaki önek eşleşmesini ölçer | Önek fonksiyonu dolaylı bilgi taşır |
| Z kutusu | Tekrarlanan karşılaştırmaları azaltır | Eşleşme durumunu geri sarar |
| Ayraç karakteri | Örüntü ve metni güvenle ayırır | Genellikle gerekmez |
Z Algoritması özellikle çok sayıda eşleşmenin aranacağı DNA dizileri, günlük kayıtları ve içerik filtreleme sistemlerinde güçlüdür. KMP daha yaygın öğretilse de Z yaklaşımı, “önek eşleşmesi” fikrini tek bir dizi üzerinde görünür hâle getirir. Bu yüzden yalnızca bir arama aracı değil, string algoritmalarını anlamak için de etkili bir zihinsel modeldir.
Yorumlar