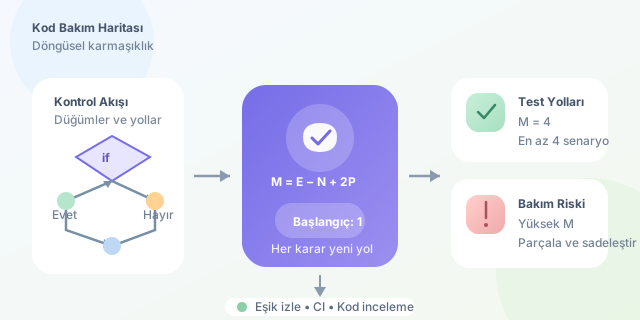
Bir fonksiyonun uzun olması her zaman karmaşık olduğu anlamına gelmez; asıl yorucu olan, kodun içinde kaç farklı karar yolunun saklandığıdır. Cyclomatic Complexity (döngüsel karmaşıklık), Thomas McCabe tarafından geliştirilen ve bir program parçasındaki bağımsız yürütme yollarını sayısallaştıran metriktir. Bu sayı yükseldikçe test senaryosu üretmek, davranışı anlamak ve güvenle değişiklik yapmak zorlaşır.
Devamı...
Git geçmişiniz yalnızca “neler değişti?” sorusunu değil, “bu değişiklik kullanıcıyı nasıl etkiler?” sorusunu da cevaplamalıdır. Conventional Commits, commit mesajlarını küçük ama anlamlı bir sözleşmeye bağlayarak bu cevabı makine tarafından okunabilir hâle getirir. Sonuç olarak changelog üretimi, sürüm numarası artırma ve yayın notu hazırlama gibi sıkıcı işler otomatikleşir.
Devamı...
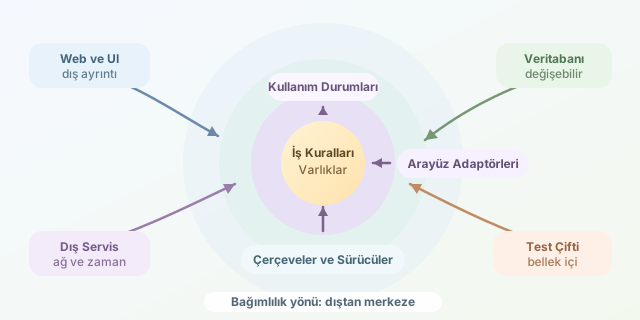
Bir yazılım projesinin en pahalı kısmı çoğu zaman ilk sürümünü geliştirmek değildir; asıl maliyet, değişen iş kurallarına ve yeni ihtiyaçlara yıllar boyunca uyum sağlamaktır. Clean Architecture, kodu yalnızca bugün çalışacak şekilde değil, yarın değiştirilebilecek şekilde tasarlamayı hedefler. Temel fikir basittir: İş kuralları; veritabanı, arayüz, framework veya dış servis gibi ayrıntılara bağımlı olmamalıdır.
Devamı...
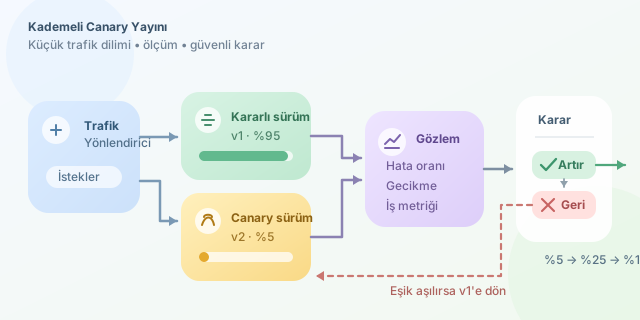
Yeni bir sürümü herkesin önüne aynı anda koymak, yazılım dünyasındaki en heyecanlı ama en riskli düğmelerdendir. Canary Release yaklaşımı bu riski küçültür: Yeni sürüm önce trafiğin küçük bir bölümüne sunulur, metrikler izlenir ve her şey yolundaysa erişim kademeli biçimde genişletilir. Adını, zehirli gazları erkenden fark etmek için madenlerde kullanılan kanaryalardan alır. Buradaki kanarya ise cesur birkaç kullanıcı değil; kontrollü bir trafik dilimidir.
Devamı...
Asal sayılar, yalnızca 1’e ve kendilerine bölünebilen 1’den büyük tam sayılardır; fakat bu kısa tanım, büyük veri aralıklarında hesaplama yaparken ciddi bir algoritma problemine dönüşür. Tek tek sayıları denemek küçük örneklerde işe yarasa da, örneğin $10^{12}$ civarındaki milyonlarca sayıyı taramak istediğimizde akıllı eleme stratejilerine ihtiyaç duyarız. Bu noktada Eratosthenes Eleği ve onun büyük aralıklara uyarlanmış hâli olan segmentli elek devreye girer.
Devamı...
Bir yapay zeka uygulamasının etkileyici cevaplar üretmesi tek başına başarı değildir; doğru bağlamda, güvenli sınırlar içinde ve tutarlı kalitede çalışması gerekir. Guardrail sistemleri, büyük dil modellerinin (LLM) girişlerini, araç kullanımını ve çıktılarını denetleyen koruyucu katmanlardır. Amaç modeli “sansürlemek” değil; kullanıcı, kurum verisi ve iş süreçleri için öngörülebilir bir çalışma alanı tanımlamaktır.
Devamı...
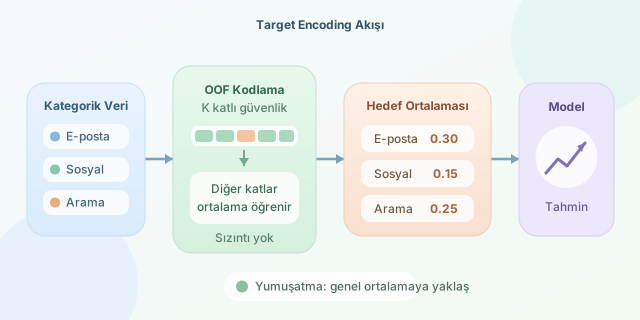
Kategorik veriler, makine öğrenmesi projelerinin görünmez kahramanlarıdır: şehir, ürün kategorisi, kampanya kodu, müşteri segmenti veya film türü gibi alanlar çoğu zaman tahmin gücünün önemli kısmını taşır. Ancak modeller metin etiketlerini doğrudan anlayamaz. Target encoding, kategorileri hedef değişkenle olan ilişkilerine göre sayısal hale getirerek bu sorunu güçlü ve pratik biçimde çözer.
Devamı...
Bir uygulamayı çalıştırmadan önce onun hakkında ne kadar çok şey öğrenebiliriz? Static Code Analysis (statik kod analizi), kaynak kodu derleme ya da çalıştırma aşamasına ihtiyaç duymadan inceleyerek olası hataları, standart ihlallerini ve güvenlik risklerini bulmaya çalışan yöntemlerin genel adıdır. Kısacası, kodunuzun içine el feneri tutar: Her gölge gerçek bir hata değildir ama araştırmaya değer olabilir.
Devamı...
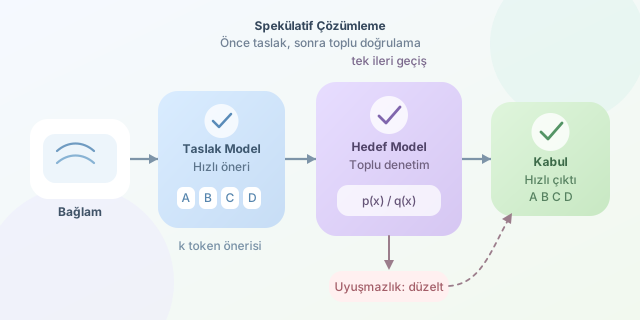
Büyük dil modelleri etkileyici metinler üretirken her token için devasa hesaplamalar yapar. Bu durum, özellikle uzun yanıtlar ve eşzamanlı kullanıcılar söz konusu olduğunda gecikmeyi büyütür. Speculative decoding (spekülatif çözümleme), kaliteyi belirgin biçimde düşürmeden üretimi hızlandırmak için küçük ve hızlı bir modelin yaptığı tahminleri büyük modelle topluca doğrulayan yaratıcı bir çıkarım tekniğidir.
Devamı...
Bir veritabanında aynı anda yüzlerce kullanıcının işlem yaptığını düşünün: biri bakiyesini güncellerken diğeri rapor alıyor, üçüncüsü aynı ürünü satın almaya çalışıyor. Snapshot Isolation (SI), her işleme verinin tutarlı bir “anlık görüntüsünü” vererek bu karmaşayı yönetmeye yardımcı olan izolasyon seviyesidir. Okuyucuların yazarları beklememesi sayesinde özellikle yoğun okuma yüklerinde oldukça akıcı bir deneyim sunar.
Devamı...
Büyük dil modelleri (LLM), doğal dili hem arayüz hem de komut kanalı olarak kullandığı için klasik yazılımlardan farklı bir saldırı yüzeyine sahiptir. Prompt injection, saldırganın modele verilen güvenilir talimatları gölgeleyerek hedef davranışı değiştirmeye çalışmasıdır. Bir sohbet botunun gizli yönergelerini açıklatmak, bir belge özetleyicisine yanlış sonuç ürettirmek veya araç kullanan bir ajana yetkisiz işlem yaptırmak bu tehdidin tipik sonuçlarıdır.
Devamı...
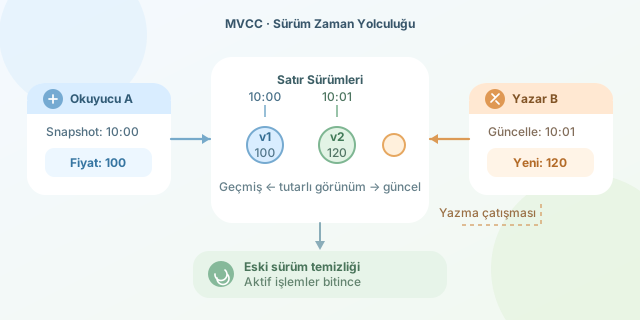
Bir veritabanında aynı müşteri kaydını yüzlerce kullanıcının aynı anda okumak ve güncellemek istediğini düşünün. Geleneksel kilitleme yaklaşımında bir yazma işlemi, okuyucuları bekletebilir; okuyucular da yazarı geciktirebilir. MVCC (Multi-Version Concurrency Control), yani Çok Sürümlü Eşzamanlılık Denetimi, bu trafik sıkışıklığını azaltmak için verinin tek bir kopyası yerine zaman damgalı birden fazla mantıksal sürümünü kullanır. PostgreSQL, MySQL InnoDB ve SQLite gibi sistemlerin farklı biçimlerde kullandığı bu fikir, yüksek eşzamanlılığın temel araçlarından biridir.
Devamı...
Bir büyük dil modelini, her soruya cevap vermek için şirketin tüm çalışanlarını aynı toplantıya çağıran bir kurum gibi düşünebilirsiniz. Herkes katılır, herkes hesap yapar; fakat bu hem pahalı hem de yavaştır. Mixture of Experts (MoE) yaklaşımı ise doğru soruyu doğru uzman ekibe yönlendirir. Böylece model, çok büyük bir bilgi kapasitesine sahipken her kelime üretiminde bu kapasitenin yalnızca ilgili bölümünü çalıştırır.
Devamı...
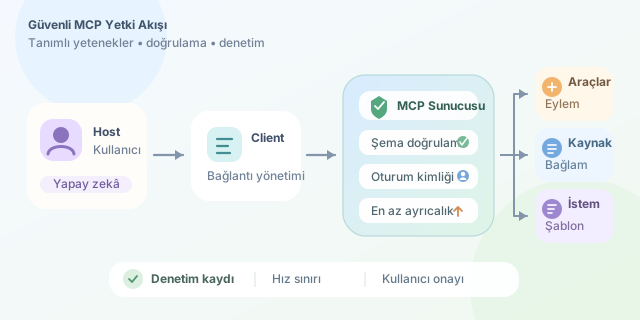
Büyük dil modelleri metin üretmekte harikadır; fakat takviminize bakmak, veritabanından sipariş sorgulamak veya dosya oluşturmak gibi gerçek dünya işleri için araçlara ihtiyaç duyarlar. Model Context Protocol (MCP), modeller ile bu araçlar arasında standart, denetlenebilir ve güvenli bir köprü kurar. Bir MCP sunucusu geliştirirken amaç, modele sınırsız sistem yetkisi vermek değil; iyi tanımlanmış yetenekleri kontrollü biçimde sunmaktır.
Devamı...
Modern uygulamalar saniyede binlerce olay, sipariş, metrik veya log üretiyor. Bu kadar yoğun yazma trafiğinde klasik B-Tree tabanlı yapıların disk üzerinde yaptığı rastgele güncellemeler pahalılaşabilir. LSM Tree (Log-Structured Merge Tree), yazmaları önce sıralı ve hızlı alanlara yönlendirip düzenleme işini sonraya bırakan veri yapısı ailesidir. RocksDB, LevelDB, Apache Cassandra ve birçok zaman serisi çözümünün performans hikâyesinde bu yaklaşım bulunur.
Devamı...
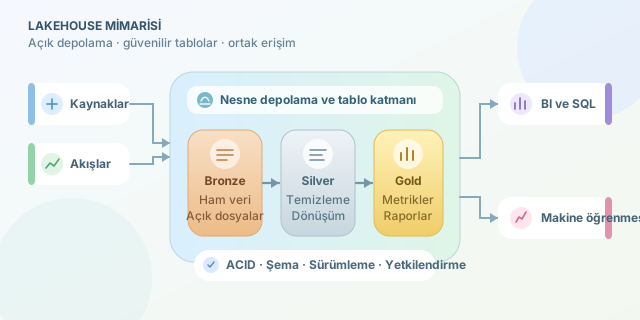
Kuruluşlar uzun süre verilerini iki ayrı dünyada yönetti: Raporlama ve karar destek için düzenli veri ambarları, ham ve büyük hacimli veriler için ise veri gölleri. Lakehouse mimarisi, bu iki yaklaşımın güçlü yanlarını tek bir platformda buluşturarak hem analitik ekiplerin hem de makine öğrenmesi ekiplerinin aynı veriye güvenle erişmesini hedefler. Kısacası gölün özgürlüğünü, ambarın düzeniyle birleştiren bir veri yerleşim planıdır.
Devamı...
Büyük dil ve görüntü modelleri etkileyici sonuçlar üretir; ancak çoğu zaman pahalı, yavaş ve cihaz üzerinde çalıştırılamayacak kadar hantaldırlar. Knowledge Distillation (bilgi damıtma), büyük bir öğretmen modelin öğrendiği davranışları daha küçük bir öğrenci modele aktararak bu sorunu hedefler. Amaç öğretmeni birebir kopyalamak değil, onun karar verme ipuçlarını sıkıştırılmış bir biçimde öğrencide yaşatmaktır.
Devamı...
Bir yapay zeka modelini eğitmek, maratonu bitirmek gibidir; inference ise her kullanıcı isteğinde yeniden başlayan sprinttir. Üretimde kullanıcılar modelinizin kaç gün eğitildiğiyle değil, yanıtın ne kadar hızlı geldiği, ne kadar maliyet oluşturduğu ve yoğun trafikte ne kadar kararlı kaldığıyla ilgilenir. Inference optimizasyonu; gecikmeyi düşürmek, saniyedeki istek sayısını artırmak ve donanım kaynaklarını daha verimli kullanmak için model, çalışma zamanı ve altyapı katmanlarını birlikte iyileştirme disiplinidir.
Devamı...
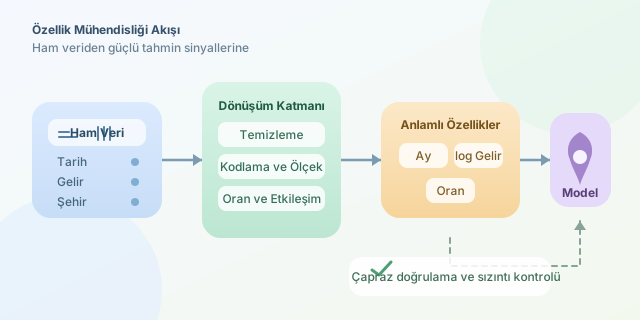
Makine öğrenmesinde model seçmek çoğu zaman sahnenin en parlak yıldızıdır; ancak performansı belirleyen görünmez kahraman genellikle özellik mühendisliğidir. Feature engineering, ham verideki bilgiyi modelin daha kolay anlayacağı sayısal, anlamlı ve tahmin gücü yüksek değişkenlere dönüştürme sanatıdır. İyi hazırlanmış özellikler, basit bir modeli bile güçlü hale getirebilir; kötü özellikler ise en iddialı algoritmayı bile şaşırtabilir.
Devamı...
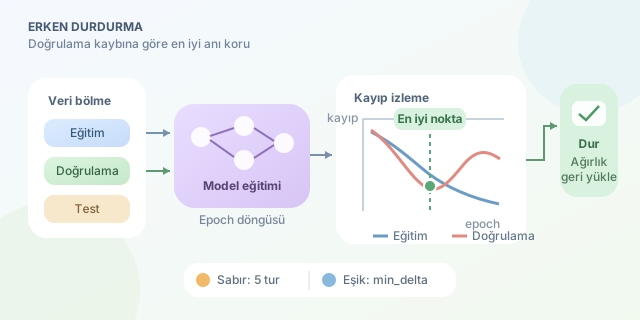
Bir yapay zeka modelini eğitmek, sınava çalışan bir öğrenciyi izlemeye benzer: İlk günlerde temel kavramları öğrenir, sonra soruları daha iyi çözmeye başlar. Ancak öğrencinin yalnızca deneme sorularının cevaplarını ezberlemesi gerçek sınavda başarısızlığa yol açar. Makine öğrenmesindeki karşılığı overfitting ya da aşırı öğrenmedir. Early Stopping (erken durdurma), model henüz genelleme yeteneğini kaybetmeden eğitimi bitirerek bu tuzağa karşı kullanılan pratik ve güçlü bir stratejidir.
Devamı...