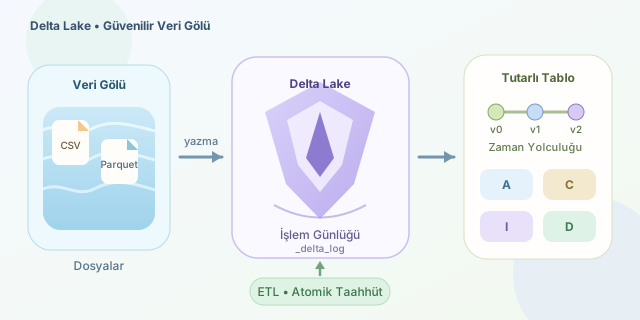
Veri gölleri; CSV, JSON, Parquet ve log dosyaları gibi büyük hacimli verileri ekonomik biçimde saklamak için harikadır. Ancak klasik bir veri gölü, aynı tabloya eşzamanlı yazan işler, yarıda kalan yüklemeler veya değişen şemalar karşısında kolayca karmaşaya dönüşebilir. Delta Lake, açık kaynaklı depolama katmanıyla bu esnek dünyaya veri ambarı disiplinini getirir: ACID işlemleri, sürüm geçmişi, şema denetimi ve güvenilir güncellemeler.
Devamı...
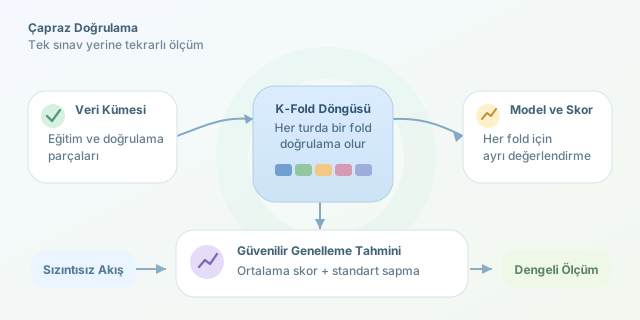
Bir makine öğrenmesi modelinin eğitim verisinde yüksek doğruluk vermesi, onun gerçek dünyada da başarılı olacağı anlamına gelmez. Model belki gerçekten örüntüyü öğrenmiştir; belki de eğitim kümesini ezberlemiştir. Cross validation (çapraz doğrulama), bu ikisini ayırmak için veriyi akıllıca ve tekrarlanabilir biçimde bölerek modelin genelleme yeteneğini ölçer. Kısacası, tek bir sınav yerine modeli birden fazla sınava sokar.
Devamı...
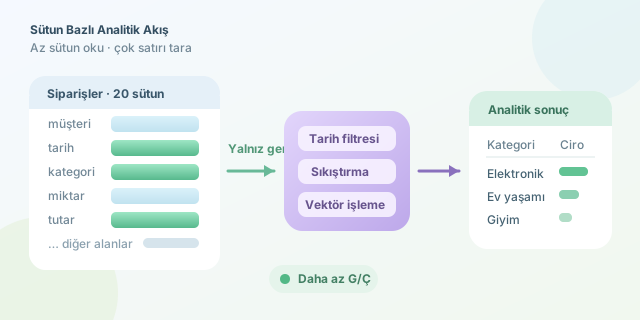
Analitik sistemlerde asıl soru genellikle “hangi müşteriler?” değil, “milyonlarca kayıttan hangi eğilim ortaya çıkıyor?” olur. İşte columnar database, yani sütun bazlı veritabanı mimarisi, bu soruya hızla yanıt vermek için tasarlanmıştır. Satır bazlı sistemlerin tüm kaydı birlikte taşıyan yaklaşımına karşılık, veriyi sütun sütun organize eder.
Devamı...
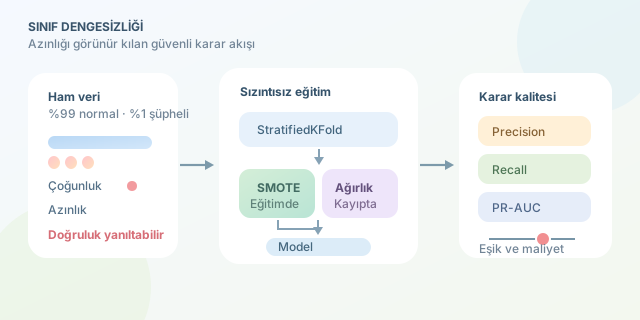
Bir dolandırıcılık tespit veri setinde işlemlerin %99’u normal, yalnızca %1’i şüpheli olabilir. Model her kayda “normal” diyerek %99 doğruluk elde eder; fakat asıl yakalamamız gereken vakaları tamamen kaçırır. İşte class imbalance (sınıf dengesizliği), başarı metriğinin alkış aldığı ama ürünün başarısız olduğu bu yanıltıcı sahnenin adıdır. Sorun sadece veri sayısı değil, modelin eğitim sırasında çoğunluk sınıfının hatalarını daha sık görmesi ve kayıp fonksiyonunun bu sınıfa doğal olarak daha fazla ağırlık vermesidir.
Devamı...
Veri gölleri, ham veriyi düşük maliyetle saklamak için harikadır; fakat klasik dosya klasörü yaklaşımı büyüdükçe yönetim kabusa dönüşebilir. Hangi Parquet dosyası güncel, silinen kayıt gerçekten silindi mi, iki farklı işlem aynı anda yazarsa ne olur? Apache Iceberg, bu sorulara modern bir tablo katmanı ekleyerek veri gölünü SQL dünyasının güvenilirliğiyle buluşturur.
Devamı...
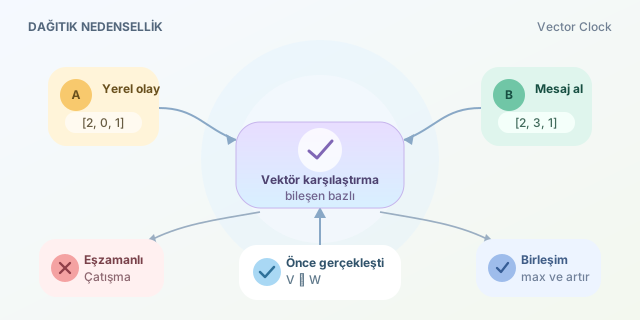
Dağıtık sistemlerde tek bir duvar saati, olayların gerçek sırasını güvenilir biçimde anlatamaz. Sunucuların saatleri kayabilir, ağ paketleri gecikebilir ve iki işlem fiziksel olarak farklı makinelerde aynı anda gerçekleşebilir. Vector Clock, “hangi olay hangisinden sonra oldu?” sorusuna odaklanan mantıksal zamanlama tekniğidir. Özellikle replikasyon, çatışma çözümü ve nedensellik analizi için çok değerlidir.
Devamı...
Bir kod editörünün yazarken hataları anında kırmızıyla işaretlemesi, fonksiyonları katlaması veya imlecin altındaki yapıyı seçmesi sihir değildir: arka planda kodu anlayan bir ayrıştırıcı çalışır. Tree-sitter, bu işi onlarca dil için hızlı, dayanıklı ve artımlı biçimde yapan açık kaynaklı bir ayrıştırma kütüphanesidir. Özellikle eksik, hatalı ya da henüz yazılmakta olan kodla başa çıkabilmesi onu modern editörler, analiz araçları ve geliştirici deneyimi projeleri için güçlü bir aday yapar.
Devamı...
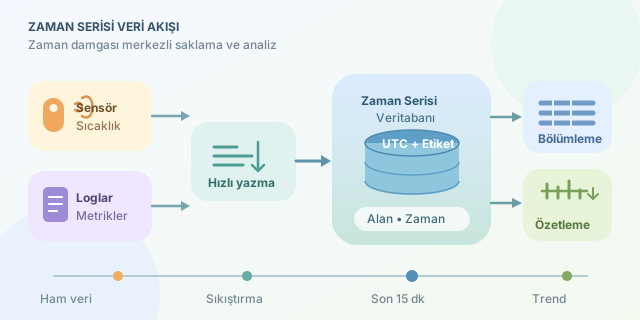
Bir fabrikanın saniyede yüzlerce sıcaklık ölçümü ürettiğini, bir web uygulamasının da her istekte log bıraktığını düşünün. Bu veriler klasik tablolara elbette yazılabilir; fakat sorgular büyüdükçe, disk maliyeti arttıkça ve “son bir saatteki ortalama nedir?” sorusu sıklaştıkça özel bir yaklaşıma ihtiyaç duyulur. Time series (zaman serisi) veritabanları, zaman damgasını verinin merkezine koyarak sensör, metrik, olay ve log akışlarını verimli biçimde saklamak için tasarlanmıştır.
Devamı...
Bir paketin 2.4.1 sürümünü gördüğünüzde bunun sadece üç rastgele sayı olduğunu düşünmek kolaydır. Oysa doğru kullanıldığında bu numara, güncellemenin projenizi bozup bozmayacağına dair güçlü bir sözleşmedir. Semantic Versioning (SemVer), geliştiriciler, paket yöneticileri ve kullanıcılar arasında ortak bir dil kurar: Yeni özellik mi geldi, hata mı düzeldi, yoksa mevcut entegrasyonlar tehlikede mi?
Devamı...
Programlama yarışmalarındaki klasik sorularda girdiyi bir kez okur, cevabı yazıp programı kapatırsınız. İnteraktif problemlerde ise karşınızda görünmez bir hakem vardır: Siz soru sorarsınız, hakem cevap verir, siz yeni bilgiye göre stratejinizi güncellersiniz. Bu yapı; ikili arama, bilgi teorisi, durum yönetimi ve iletişim protokolü gibi kavramları aynı sahnede buluşturur.
Devamı...
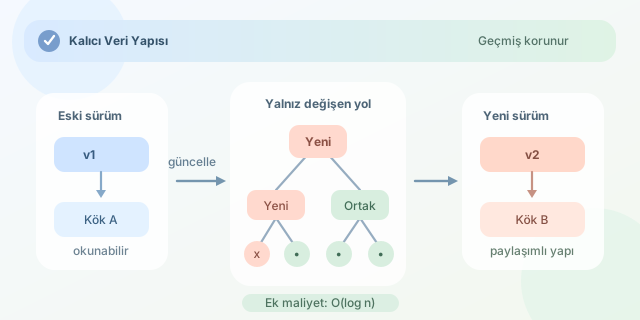
Bir diziyi güncellediğinizde eski hâlinin de erişilebilir kaldığını hayal edin: hata ayıklamada zaman yolculuğu, sürüm kontrolünde anlık geri alma ve eşzamanlı işlemlerde daha güvenli okuma mümkün olur. Persistent (kalıcı) veri yapıları tam olarak bunu sağlar. Buradaki “kalıcı” ifadesi diske yazılmayı değil, bir güncelleme sonrasında önceki mantıksal sürümlerin yaşamaya devam etmesini anlatır.
Devamı...
Bir projeyi yeni bir bilgisayarda çalıştırırken yaşanan “bende çalışıyordu” sendromu, çoğu zaman koddan değil ortamdan kaynaklanır. Farklı derleyici sürümleri, eksik kütüphaneler ve işletim sistemi farkları geliştirme sürecini tahmin edilmez hâle getirir. Nix, paketleri ve geliştirme ortamlarını deklaratif biçimde tanımlayarak bu kaosu kontrol altına alan güçlü bir paket yöneticisidir.
Devamı...
Büyüyen bir yazılım organizasyonunda kod depoları yalnızca dosyaların yaşadığı klasörler değildir; ekip sınırlarını, dağıtım hızını ve bağımlılık yönetimini doğrudan etkileyen mimari kararlardır. Monorepo, birçok uygulama ve kütüphaneyi tek Git deposunda toplarken; polyrepo yaklaşımı her servis, uygulama veya bileşen için ayrı depo kullanır. Doğru tercih, moda olan aracı seçmekten çok ürününüzün değişim ritmini anlamaktır.
Devamı...
Bir sözlüğün tüm kelimeleri, bir derleyicinin anahtar sözcükleri ya da bir servisin değişmeyen kimlik listesi için hızlı arama yapmak istediğinizi düşünün. Klasik hash tabloları güçlüdür; ancak çakışmalar, boş kovalar ve ek bellek maliyeti taşırlar. Veri kümesi oluşturulduktan sonra değişmeyecekse Minimal Perfect Hash Function (MPHF), her anahtarı çakışmasız biçimde tam gereken indeks aralığına yerleştirerek bu maliyeti dramatik biçimde azaltır.
Devamı...
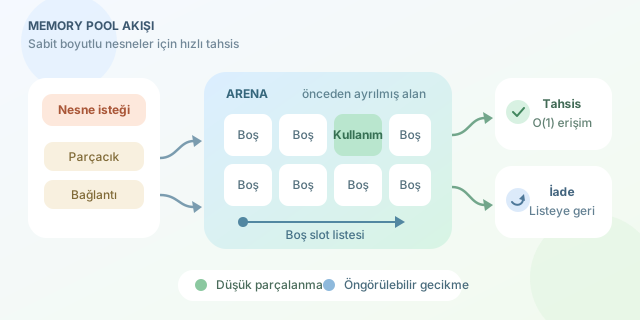
Bir uygulama saniyede binlerce küçük nesne oluşturup yok ediyorsa, asıl darboğaz her zaman algoritmanız olmayabilir. malloc, free, new ve delete çağrıları; uygun blok arama, meta veri güncelleme, kilit alma ve parçalanma yönetimi gibi görünmeyen maliyetler taşır. Memory pool, sık kullanılan benzer boyutlu nesneleri önceden ayrılmış bir bellek alanından dağıtarak bu maliyeti daha öngörülebilir hale getiren özel bir bellek yöneticisidir.
Devamı...
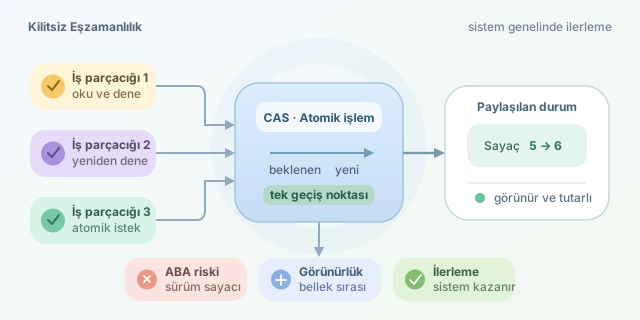
Modern uygulamalarda birden fazla iş parçacığının aynı veriye erişmesi kaçınılmazdır. Geleneksel çözüm mutex gibi kilitlerdir; ancak bir iş parçacığı kilidi bırakmayı unutursa, askıya alınırsa veya uzun süre çalışırsa diğerleri beklemeye mahkûm olur. Lock-free veri yapıları, bu bekleme zincirini kırmak için atomik donanım işlemlerini kullanır. Amaç, tek tek iş parçacıklarının değil, sistemin bütünüyle her zaman ilerlemesidir.
Devamı...
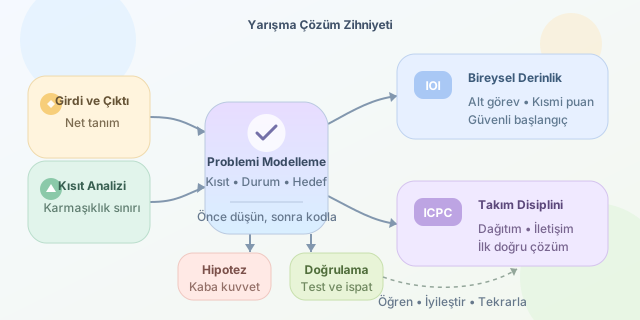
Uluslararası programlama yarışmaları yalnızca hızlı kod yazma sınavları değildir; belirsiz bir problemi modele dönüştürme, doğru algoritmayı seçme ve baskı altında hatasız uygulama sanatıdır. IOI bireysel, kısmi puan odaklı ve daha derin algoritmik analiz gerektirirken; ICPC ekip iletişimi, problem dağıtımı ve “ilk doğru çözüm” disiplinini öne çıkarır. Ortak payda ise düzenli düşünme alışkanlığıdır.
Devamı...
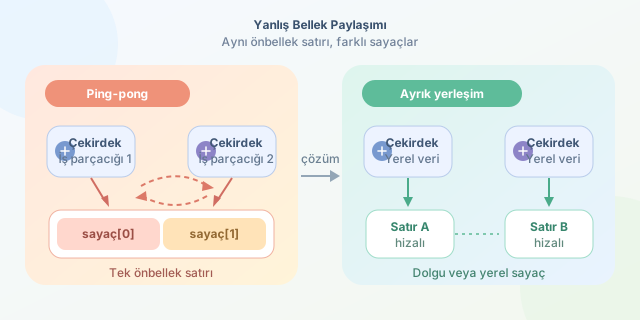
Paralel programlarda çekirdek sayısını artırmak her zaman beklenen hızlanmayı getirmez. Bazen iş parçacıkları farklı değişkenlerle çalıştığını düşündüğümüz hâlde uygulama yavaşlar, CPU kullanımı yükselir ve profil sonuçları gizemli görünür. Bu durumun sık rastlanan sorumlularından biri false sharing ya da Türkçesiyle yanlış bellek paylaşımıdır. Sorun, verinin mantıksal olarak değil, işlemcinin önbellek satırları düzeyinde paylaşılmasından doğar.
Devamı...
Modern işlemciler inanılmaz hızlıdır; fakat RAM erişimi, işlemci çekirdeğinin hızına kıyasla şaşırtıcı derecede yavaştır. Bu yüzden performans darboğazı çoğu zaman karmaşık matematiksel işlem değil, verinin bellekte nerede durduğu ve hangi sırayla okunduğudur. Cache dostu kod yazımı; veriyi işlemcinin sevdiği biçimde, yakın adreslerde ve öngörülebilir bir akışla tüketme sanatıdır.
Devamı...
Dağıtık veritabanları, veriyi birden fazla makineye yayarak ölçeklenebilirlik ve arıza toleransı sağlar. Ancak sistem farklı sunuculara, ağ bağlantılarına ve gecikmelere dağıldığında tek bir veritabanı gibi davranması zorlaşır. CAP Teoremi tam bu noktadaki temel gerçeği anlatır: Ağ bölünmesi yaşanırken tutarlılık, erişilebilirlik ve bölünme toleransının üçünü aynı anda eksiksiz sunamazsınız.
Devamı...