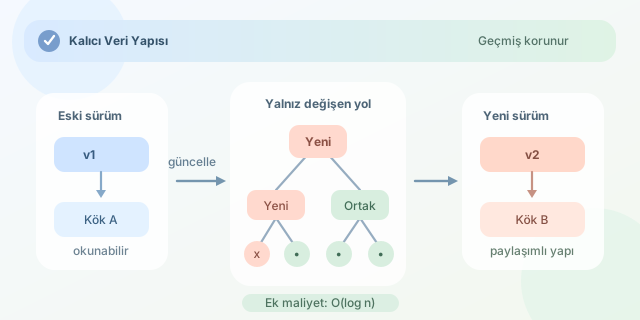
Bir diziyi güncellediğinizde eski hâlinin de erişilebilir kaldığını hayal edin: hata ayıklamada zaman yolculuğu, sürüm kontrolünde anlık geri alma ve eşzamanlı işlemlerde daha güvenli okuma mümkün olur. Persistent (kalıcı) veri yapıları tam olarak bunu sağlar. Buradaki “kalıcı” ifadesi diske yazılmayı değil, bir güncelleme sonrasında önceki mantıksal sürümlerin yaşamaya devam etmesini anlatır.
Devamı...
Bir projeyi yeni bir bilgisayarda çalıştırırken yaşanan “bende çalışıyordu” sendromu, çoğu zaman koddan değil ortamdan kaynaklanır. Farklı derleyici sürümleri, eksik kütüphaneler ve işletim sistemi farkları geliştirme sürecini tahmin edilmez hâle getirir. Nix, paketleri ve geliştirme ortamlarını deklaratif biçimde tanımlayarak bu kaosu kontrol altına alan güçlü bir paket yöneticisidir.
Devamı...
Büyüyen bir yazılım organizasyonunda kod depoları yalnızca dosyaların yaşadığı klasörler değildir; ekip sınırlarını, dağıtım hızını ve bağımlılık yönetimini doğrudan etkileyen mimari kararlardır. Monorepo, birçok uygulama ve kütüphaneyi tek Git deposunda toplarken; polyrepo yaklaşımı her servis, uygulama veya bileşen için ayrı depo kullanır. Doğru tercih, moda olan aracı seçmekten çok ürününüzün değişim ritmini anlamaktır.
Devamı...
Bir sözlüğün tüm kelimeleri, bir derleyicinin anahtar sözcükleri ya da bir servisin değişmeyen kimlik listesi için hızlı arama yapmak istediğinizi düşünün. Klasik hash tabloları güçlüdür; ancak çakışmalar, boş kovalar ve ek bellek maliyeti taşırlar. Veri kümesi oluşturulduktan sonra değişmeyecekse Minimal Perfect Hash Function (MPHF), her anahtarı çakışmasız biçimde tam gereken indeks aralığına yerleştirerek bu maliyeti dramatik biçimde azaltır.
Devamı...
Bir uygulama saniyede binlerce küçük nesne oluşturup yok ediyorsa, asıl darboğaz her zaman algoritmanız olmayabilir. malloc, free, new ve delete çağrıları; uygun blok arama, meta veri güncelleme, kilit alma ve parçalanma yönetimi gibi görünmeyen maliyetler taşır. Memory pool, sık kullanılan benzer boyutlu nesneleri önceden ayrılmış bir bellek alanından dağıtarak bu maliyeti daha öngörülebilir hale getiren özel bir bellek yöneticisidir.
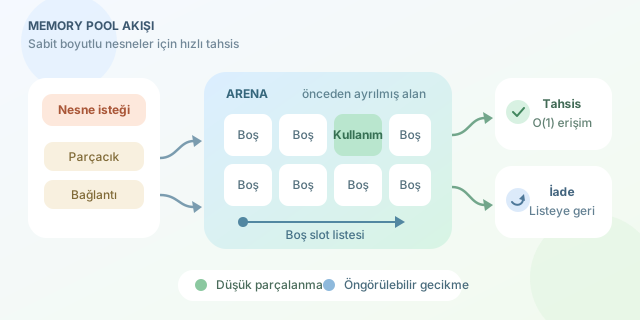
Devamı...
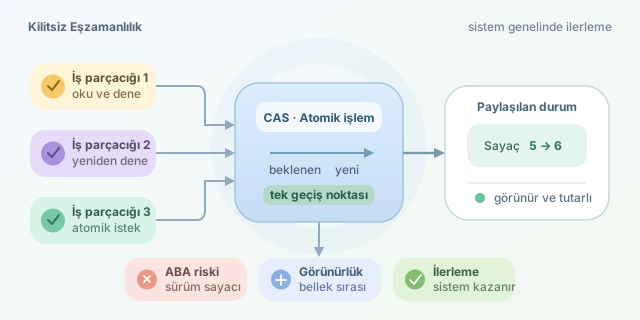
Modern uygulamalarda birden fazla iş parçacığının aynı veriye erişmesi kaçınılmazdır. Geleneksel çözüm mutex gibi kilitlerdir; ancak bir iş parçacığı kilidi bırakmayı unutursa, askıya alınırsa veya uzun süre çalışırsa diğerleri beklemeye mahkûm olur. Lock-free veri yapıları, bu bekleme zincirini kırmak için atomik donanım işlemlerini kullanır. Amaç, tek tek iş parçacıklarının değil, sistemin bütünüyle her zaman ilerlemesidir.
Devamı...
Uluslararası programlama yarışmaları yalnızca hızlı kod yazma sınavları değildir; belirsiz bir problemi modele dönüştürme, doğru algoritmayı seçme ve baskı altında hatasız uygulama sanatıdır. IOI bireysel, kısmi puan odaklı ve daha derin algoritmik analiz gerektirirken; ICPC ekip iletişimi, problem dağıtımı ve “ilk doğru çözüm” disiplinini öne çıkarır. Ortak payda ise düzenli düşünme alışkanlığıdır.
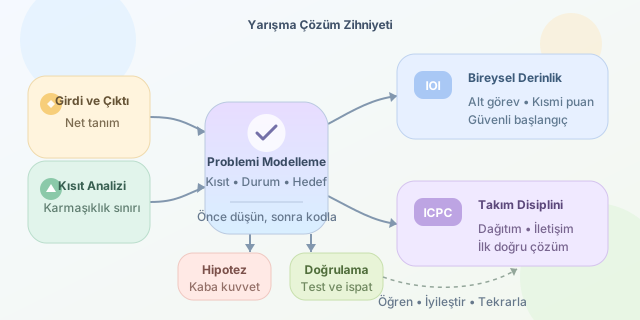
Devamı...
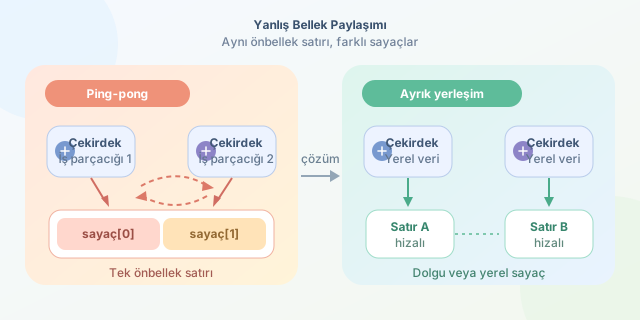
Paralel programlarda çekirdek sayısını artırmak her zaman beklenen hızlanmayı getirmez. Bazen iş parçacıkları farklı değişkenlerle çalıştığını düşündüğümüz hâlde uygulama yavaşlar, CPU kullanımı yükselir ve profil sonuçları gizemli görünür. Bu durumun sık rastlanan sorumlularından biri false sharing ya da Türkçesiyle yanlış bellek paylaşımıdır. Sorun, verinin mantıksal olarak değil, işlemcinin önbellek satırları düzeyinde paylaşılmasından doğar.
Devamı...
Modern işlemciler inanılmaz hızlıdır; fakat RAM erişimi, işlemci çekirdeğinin hızına kıyasla şaşırtıcı derecede yavaştır. Bu yüzden performans darboğazı çoğu zaman karmaşık matematiksel işlem değil, verinin bellekte nerede durduğu ve hangi sırayla okunduğudur. Cache dostu kod yazımı; veriyi işlemcinin sevdiği biçimde, yakın adreslerde ve öngörülebilir bir akışla tüketme sanatıdır.
Devamı...
Dağıtık veritabanları, veriyi birden fazla makineye yayarak ölçeklenebilirlik ve arıza toleransı sağlar. Ancak sistem farklı sunuculara, ağ bağlantılarına ve gecikmelere dağıldığında tek bir veritabanı gibi davranması zorlaşır. CAP Teoremi tam bu noktadaki temel gerçeği anlatır: Ağ bölünmesi yaşanırken tutarlılık, erişilebilirlik ve bölünme toleransının üçünü aynı anda eksiksiz sunamazsınız.
Devamı...
Modern bir işlemci, bir programdaki talimatları sırayla ve sabırla bekleyerek çalıştırmaz; adeta aceleci bir satranç oyuncusu gibi bir sonraki hamleyi önceden kestirmeye çalışır. Dallanma tahmini (branch prediction), if, while, for ve fonksiyon dönüşleri gibi karar noktalarında hangi kod yolunun izleneceğini tahmin eden donanım tekniğidir. Doğru tahminler işlem hattını dolu tutar, yanlış tahminler ise pahalı bir geri sarma etkisi yaratır.
Devamı...
Büyük bir yazılım projesinde derleme süresi, kahve molasından uzun sürmeye başladıysa Bazel ile tanışma vakti gelmiş olabilir. Google tarafından geliştirilen Bazel; C++, Java, Python, Go ve daha birçok dili aynı depoda yönetebilen, bağımlılıkları açıkça tanımlayan ve sonuçları önbelleğe alan modern bir derleme sistemidir. Temel hedefi basittir: Makineniz, işletim sisteminiz veya ekip arkadaşınız değişse bile aynı kaynak kodundan aynı çıktıyı hızlı biçimde üretmek.
Devamı...
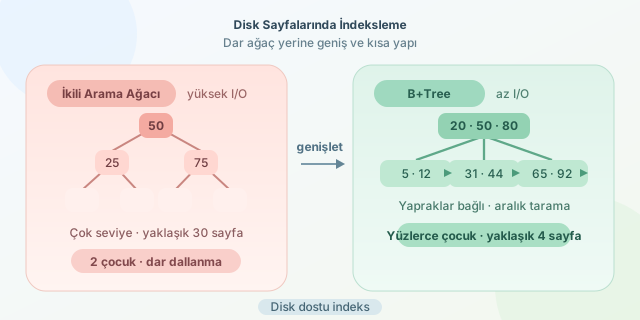
Bir veritabanında milyonlarca kaydı bulmak, bellekte küçük bir dizide arama yapmaktan oldukça farklıdır. Klasik ikili arama ağaçları (BST), teoride zarif görünür: her düğümün en fazla iki çocuğu vardır ve dengeli bir yapıda arama maliyeti $O(\log_2 N)$ olur. Ancak disk ve SSD üzerinde çalışan veritabanları için asıl pahalı işlem karşılaştırma değil, sayfa okuma yani I/O işlemidir. İşte B-Tree ve B+Tree bu maliyeti dramatik biçimde düşürmek için sahneye çıkar.
Devamı...
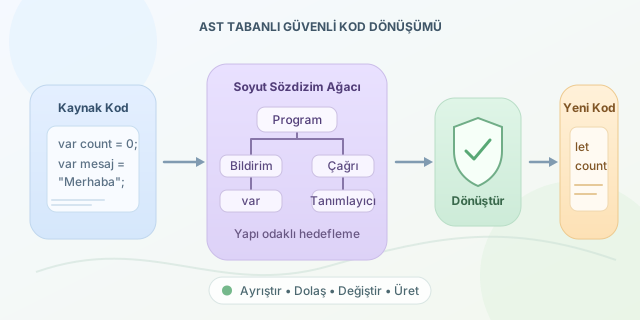
Kaynak kodunu metin olarak bul-değiştir yapmak ilk bakışta caziptir; ancak bir fonksiyon adını yorum satırında, metin içinde veya farklı bir kapsamda yanlışlıkla değiştirmek saniyeler içinde karmaşaya dönüşebilir. AST (Abstract Syntax Tree / Soyut Sözdizim Ağacı) tabanlı dönüşüm araçları, kodu karakter dizisi olarak değil, anlamlı program yapıları olarak ele alır. Böylece güvenli yeniden adlandırma, modern sözdizimine geçiş ve ekip standartlarına otomatik uyum mümkün olur.
Devamı...
Modern yazılımlarda performans sorunlarının önemli bir bölümü işlemciden değil, bellek tahsisinden doğar. Her geçici nesne için malloc, new ya da benzeri bir çağrı yapmak; ayırıcıyı kilitleme, uygun boş blok bulma ve parçalanmayı yönetme gibi ek maliyetler yaratır. Arena allocator yaklaşımı bu maliyeti dramatik biçimde azaltır: Büyük bir bellek bölgesi ayırır, küçük nesneleri bu bölge içinde sırayla yerleştirir ve iş bittiğinde hepsini tek hamlede temizler.
Devamı...
Bir ürün kataloğunda “kırmızı spor ayakkabı” aramak kolaydır; ancak “yağmurlu havada şehir yürüyüşüne uygun hafif bir şey” demek, klasik anahtar kelime aramasını zorlar. Vektör veritabanları tam burada devreye girer: metin, görsel, ses veya davranış verisini anlamı temsil eden sayısal koordinatlara dönüştürür ve birbirine en yakın kayıtları milisaniyeler içinde bulur.
Devamı...
Bir programı test ederken birkaç örnek girdi vermek çoğu zaman yeterli görünür: 0, 42, belki negatif bir sayı… Ancak bu yaklaşım, kodun karanlıkta kalan dallarını kolayca kaçırır. Symbolic Execution (sembolik çalıştırma), somut değerler yerine sembolik değişkenlerle ilerleyerek programın ulaşılabilir tüm mantıksal yollarını analiz etmeyi amaçlayan gelişmiş bir test ve hata bulma tekniğidir. Kısacası programı tek tek örneklerle değil, olası girdilerin matematiksel temsilcileriyle yürütür.
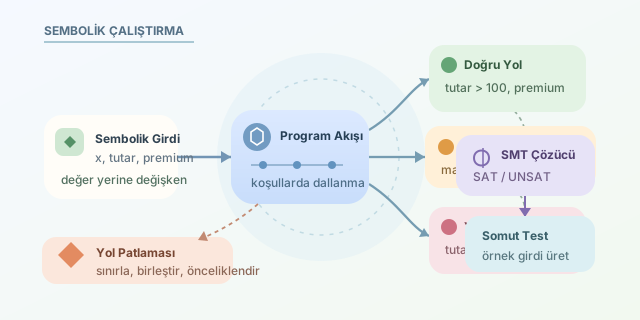
Devamı...
Bir makine öğrenmesi modeli yüksek doğruluk verdiğinde ilk soru genellikle “Ne kadar başarılı?” olur; ikinci ve çoğu zaman daha kritik soru ise “Bu karara neden vardı?”dır. SHAP (SHapley Additive exPlanations), bir tahmini özelliklerin katkılarına bölerek bu soruya sayısal bir yanıt verir. Böylece kredi reddi, müşteri terk tahmini veya fiyat tahmini gibi sonuçlarda modelin hangi sinyalleri ne yönde kullandığını görünür kılar.
Devamı...
Büyük dil modelleri (LLM), eğitim verilerindeki örüntülerden etkileyici yanıtlar üretir; ancak eğitim tarihinden sonra yaşanan gelişmeleri doğal olarak bilemezler. Daha da önemlisi, kurum içi dokümanlar, ürün katalogları veya sürekli değişen mevzuat gibi özel bilgileri doğrudan modelin parametrelerine koymak hem pahalı hem de risklidir. Retrieval-Augmented Generation (RAG), modeli yeniden eğitmek yerine doğru bilgiyi doğru anda bularak bu açığı kapatan mimaridir.
Devamı...
Büyük dil modelleri ve görüntü ağları etkileyici sonuçlar üretse de bunun bir bedeli vardır: milyarlarca parametre, yüksek RAM/VRAM tüketimi ve gecikme. Quantization (nicemleme), modelin öğrendiği bilgiyi mümkün olduğunca koruyup sayısal temsilini daha düşük hassasiyetli formatlara taşıyarak bu bedeli azaltan temel optimizasyon tekniklerinden biridir. Kısacası, modelin bavulunu hafifletirken yolculuk performansını korumaya çalışırız.
Devamı...