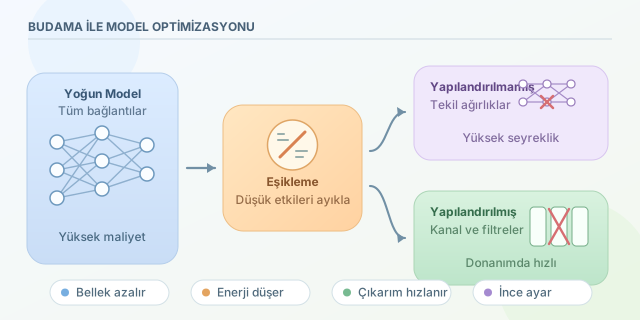
Derin öğrenme modelleri büyüdükçe doğrulukları genellikle artar; ancak bu büyümenin bir faturası vardır: daha fazla bellek, daha yüksek enerji tüketimi ve daha uzun çıkarım süresi. Pruning, yani budama, bir ağdaki düşük etkili ağırlıkları, nöronları veya hatta tüm katman parçalarını kaldırarak bu faturayı azaltmayı hedefler. Amaç modeli rastgele küçültmek değil, tahmin kalitesini mümkün olduğunca korurken gereksiz hesaplamaları ayıklamaktır.
Devamı...
Bir büyük dil modelinden tek seferde kapsamlı bir rapor yazmasını, verileri analiz etmesini, kaynakları denetlemesini ve sonucu belirli bir formatta sunmasını istemek caziptir. Ancak bu yaklaşım çoğu zaman belirsiz, tutarsız veya kolayca doğrulanamayan çıktılar üretir. Prompt chaining, büyük bir hedefi birbirini besleyen küçük istemlere ayırarak bu sorunu azaltan tekniktir. Zincirde her adım, önceki adımın çıktısını girdi olarak kullanır; böylece görev hem denetlenebilir hem de yeniden üretilebilir hâle gelir.
Devamı...
Bir programın kaynak kodu, insan gözüyle satırlardan oluşur; fakat analiz araçları için asıl değerli olan şey bu satırların taşıdığı yapıdır. Abstract Syntax Tree (AST), yani Soyut Sözdizim Ağacı, kodu değişken tanımı, fonksiyon çağrısı, koşul ve döngü gibi anlamlı düğümlere ayırır. Böylece otomatik kalite kontrolleri, güvenlik taramaları ve kod dönüşümleri düzenli ifadelerin kırılgan dünyasından kurtulur.
Devamı...
Bir yapay zeka modelini eğitmek çoğu zaman işin heyecanlı kısmıdır; asıl macera ise modeli üretime taşırken başlar. PyTorch ile eğitilmiş bir modeli Java tabanlı bir serviste, C# masaüstü uygulamasında veya edge cihazda çalıştırmak istediğinizde framework bağımlılıkları hız kesebilir. ONNX (Open Neural Network Exchange), modeller için ortak bir dil sunarak bu taşınabilirlik problemini çözmeyi hedefleyen açık standarttır.
Devamı...
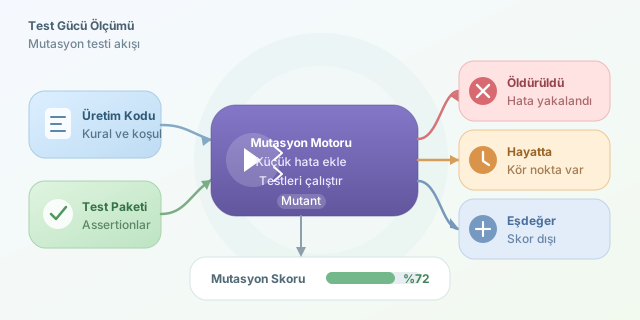
Bir test paketinin yeşil olması, uygulamanın iyi test edildiği anlamına gelmez. Testler yalnızca kodu çalıştırıyor, fakat yanlış sonucu fark etmiyor olabilir. Mutation testing (mutasyon testi), bu konfor alanını bozan bir tekniktir: Kodunuza kasıtlı, küçük hatalar ekler ve testlerinizin bu hataları yakalayıp yakalayamadığını ölçer. Kısacası soru “Kod çalışıyor mu?” değil, “Testlerim hatalı kodu reddedebiliyor mu?” olur.
Devamı...
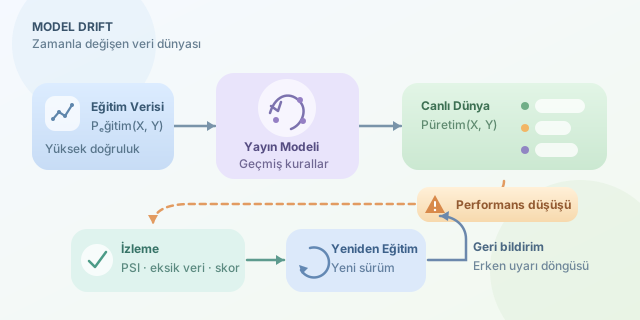
Bir makine öğrenmesi modelini yayına almak, yarışın bitiş çizgisi değil; aslında başlangıç tabancasıdır. Eğitim verisinde %95 doğruluk yakalayan bir dolandırıcılık, öneri ya da tahmin modeli, birkaç ay sonra beklenmedik biçimde hatalı kararlar vermeye başlayabilir. Bu olaya model drift denir: Modelin üretim ortamındaki performansının, zaman içinde eğitim dönemindeki performansından anlamlı biçimde uzaklaşmasıdır.
Devamı...
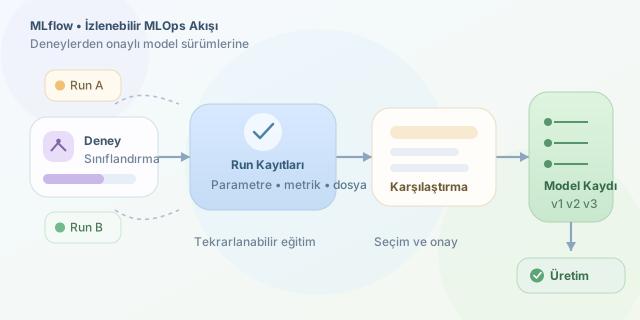
Bir makine öğrenmesi projesinde zor olan yalnızca yüksek doğruluk üreten modeli bulmak değildir; hangi veriyle, hangi parametrelerle ve hangi kod sürümüyle üretildiğini aylar sonra da kanıtlayabilmektir. MLflow, deney kayıtlarını, model dosyalarını ve dağıtıma uygun sürümleri aynı izlenebilir akışta toplayarak bu karmaşayı yönetir. Böylece “not defterimde çalışıyordu” cümlesi, yerini ölçülebilir ve tekrarlanabilir bir sürece bırakır.
Devamı...
Büyük dil modelleri metin üretmekte çok başarılıdır; ancak tek başlarına takviminize bakamaz, veritabanınızdan müşteri kaydı çekemez veya GitHub’daki bir depoyu analiz edemezler. Bu noktada MCP (Model Context Protocol), yapay zekâ uygulamalarının harici araçlar ve veri kaynaklarıyla güvenli, düzenli ve standart bir biçimde konuşmasını sağlayan açık bir protokol olarak devreye girer.
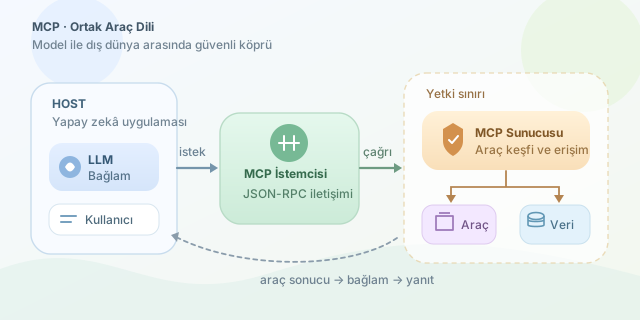
Devamı...
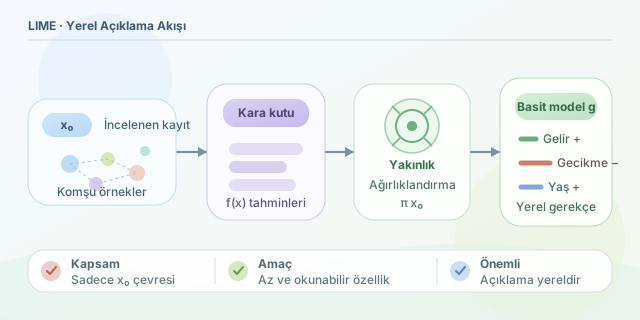
Derin öğrenme ve ansambl yöntemleri yüksek doğruluk sağlayabilir; fakat bir müşterinin kredi başvurusunun neden reddedildiğini ya da bir görselin neden “kedi” olarak etiketlendiğini açıklamak çoğu zaman zordur. LIME (Local Interpretable Model-agnostic Explanations), bu kara kutu hissini tamamen ortadan kaldırmasa da tek bir tahminin çevresine güçlü bir el feneri tutar: Karmaşık modelin belirli bir örnek için nasıl karar verdiğini, anlaşılabilir basit bir modelle yaklaşık olarak açıklar.
Devamı...
Bir yazılımın mutlu yolunda çalışması, onun her koşulda güvenli olduğu anlamına gelmez. Kullanıcıların boş metin, devasa dosya, bozuk karakter kodlaması veya beklenmeyen veri türleri gönderebildiği gerçek dünyada asıl sorunlar köşe durumlarda yaşanır. Fuzz testing ya da kısa adıyla fuzzing, uygulamalara otomatik biçimde sıra dışı, hatalı veya rastgele girdiler göndererek çökmeleri, istisnaları ve güvenlik açıklarını bulma disiplinidir. Bir bakıma yazılımınıza kontrollü kaos yaşatırsınız.
Devamı...
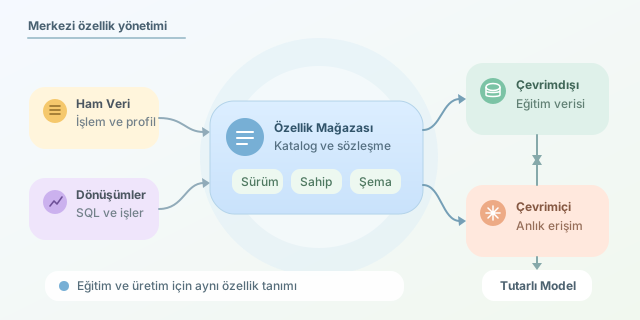
Makine öğrenmesi projelerinde model seçimi çoğu zaman sahnenin yıldızı gibi görünür; ancak gerçek hayatta performansı belirleyen oyuncu genellikle verilerdir. Özellikle özellikler (feature) farklı ekipler, SQL sorguları, notebook’lar ve üretim servisleri arasında dağınıksa aynı müşteri yaşı, satın alma toplamı veya risk puanı birbirinden farklı hesaplanabilir. Feature Store, bu karmaşayı azaltmak için özellikleri merkezi, tekrar kullanılabilir, izlenebilir ve güvenilir biçimde yöneten veri platformu katmanıdır.
Devamı...
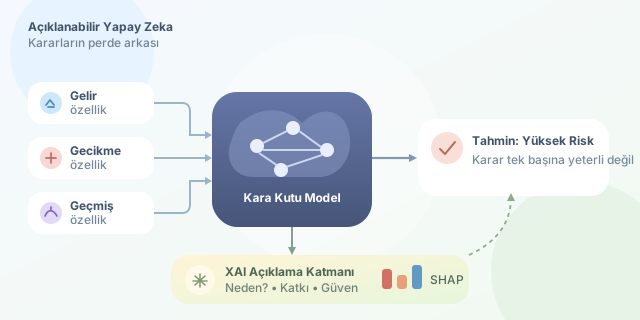
Bir kredi başvurusunun neden reddedildiğini, bir görüntünün neden “kedi” olarak sınıflandırıldığını veya bir tıbbi modelin neden yüksek risk uyarısı verdiğini bilmek isteriz. Klasik makine öğrenmesi modelleri çoğu zaman yüksek doğruluk sunarken karar süreçlerini gizleyen birer “kara kutu” gibi davranır. Explainable AI (XAI), yani Açıklanabilir Yapay Zeka, bu kutunun kapağını aralayarak modelin hangi verilere, hangi yönde ve ne kadar ağırlık vererek karar aldığını anlaşılır hale getiren yöntemler bütünüdür.
Devamı...
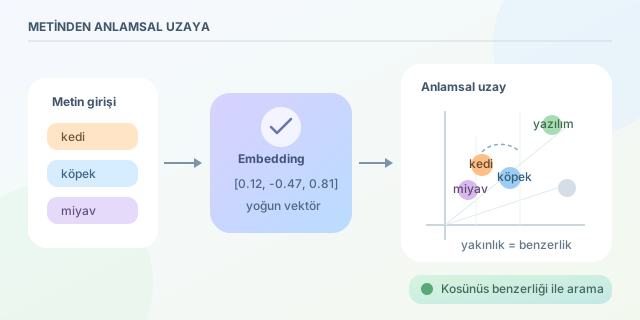
Bilgisayarlar için “kedi” ile “köpek” kelimeleri, ilk bakışta yalnızca farklı karakter dizileridir. Oysa insan zihni ikisinin de hayvan olduğunu, “kedi” ile “miyav” arasında güçlü bir ilişki bulunduğunu sezebilir. Embedding (gömme), metin, kelime, cümle ya da belge gibi verileri; bu anlamsal ilişkileri korumaya çalışan sayısal vektörlere dönüştürme yöntemidir. Böylece arama motorları, öneri sistemleri ve yapay zekâ uygulamaları metnin yalnızca yazılışını değil, yaklaşık anlamını da karşılaştırabilir.
Devamı...
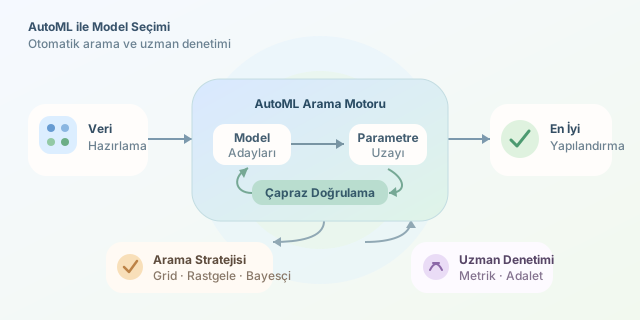
Makine öğrenmesi projelerinde en zor kısım çoğu zaman modeli eğitmek değil, hangi modeli denemek gerektiğine ve bu modelin ayarlarının nasıl yapılacağına karar vermektir. Karar ağacı mı, gradyan artırma mı, yoksa lojistik regresyon mu? Öğrenme oranı kaç olmalı? İşte AutoML (Automated Machine Learning), bu tekrar eden deneme-yanılma döngüsünü akıllı bir otomasyona dönüştürür. Amaç, veri bilimcisini ortadan kaldırmak değil; onu sonsuz parametre ayarı ekranından kurtarmaktır.
Devamı...
Tek bir büyük dil modeli etkileyici cevaplar üretebilir; ancak gerçek dünyadaki işler çoğunlukla araştırma, planlama, araç kullanımı, doğrulama ve raporlama gibi farklı uzmanlıklar ister. Ajan tabanlı yapay zeka mimarisi, bu yükü tek bir modele bırakmak yerine rolleri belirlenmiş birden fazla ajana dağıtır. Bunu küçük ama disiplinli bir yazılım ekibi gibi düşünebilirsiniz: biri işi parçalar, biri veri toplar, diğeri sonucu test eder, bir başkası da son kararı gözden geçirir.
Devamı...
Mikro servis mimarisi büyüdükçe asıl zorluk yalnızca servis yazmak değildir; servislerin birbirini güvenli, hızlı ve gözlemlenebilir biçimde çağırmasını sağlamaktır. Service mesh, bu iletişim katmanını uygulama kodundan ayıran altyapı yaklaşımıdır. Böylece Java, Go, Python ya da Node.js ile yazılmış servisler; tekrar tekrar istemci kütüphanesi eklemeden ortak ağ politikalarından yararlanabilir.
Devamı...
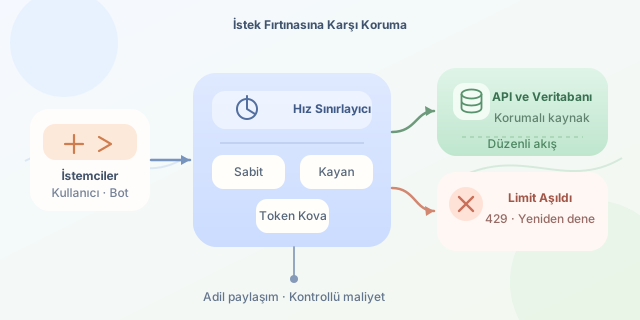
Bir API’nin başarısı bazen aldığı istek sayısıyla ölçülür; fakat kontrolsüz trafik, başarı hikâyesini saniyeler içinde kesinti raporuna dönüştürebilir. Rate limiting, belirli bir kullanıcı, IP adresi, API anahtarı veya uç nokta için kabul edilen istek miktarını sınırlayan savunma katmanıdır. Amaç yalnızca kötü niyetli botları engellemek değildir: adil kaynak paylaşımı sağlamak, maliyetleri öngörülebilir tutmak ve veritabanı gibi hassas bağımlılıkları korumaktır.
Devamı...
Dağıtık sistemlerde servislerin birbirini beklemeden iletişim kurması, hem performans hem de dayanıklılık için kritik önemdedir. RabbitMQ ve Apache Kafka bu ihtiyacı karşılayan iki güçlü araçtır; ancak aynı problemi farklı felsefelerle çözerler. Biri görev dağıtan hızlı bir postacı, diğeri ise olayların değişmez tarihçesini tutan dev bir günlük gibi düşünülebilir.
Devamı...
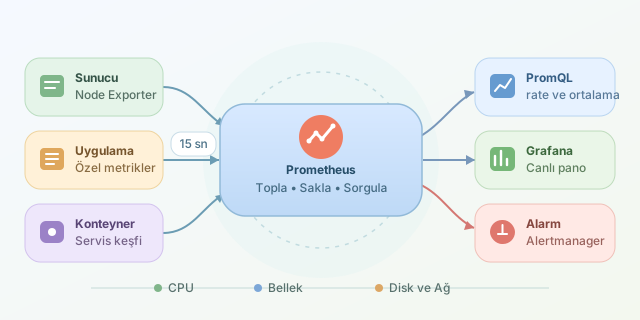
Bir sunucunun CPU kullanımı %95’e ulaştığında bunu kullanıcılar şikâyet etmeden önce görmek, modern operasyon ekiplerinin süper gücüdür. Prometheus; sunucular, uygulamalar ve konteynerler için zaman serisi verisi toplayan, sorgulayan ve alarm üreten açık kaynaklı bir izleme sistemidir. Temel hedefi basittir: “Şu anda ne oluyor, geçmişte ne oldu ve kötüye giderse bana kim haber verecek?” sorularını ölçülebilir verilerle yanıtlamak.
Devamı...
Dağıtık uygulamalarda bir isteğin nerede yavaşladığını bulmak, tek sunuculu günlerin rahatlığını özletebilir. Kullanıcı “sipariş ver” düğmesine basar; istek API ağ geçidinden ödeme servisine, stok servisine, kuyruk sistemine ve veritabanına uğrar. Hata ekranı ise yalnızca 500 döndürür. OpenTelemetry (OTel), bu karmaşık yolculuğu standart araçlarla görünür hâle getirerek izleme, hata ayıklama ve kapasite planlama süreçlerini aynı dilde buluşturur.
Devamı...