İçindekiler
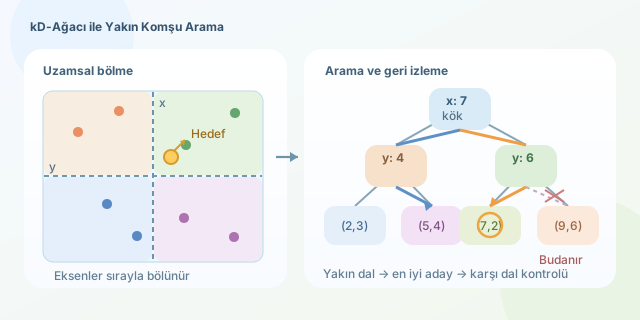
Bir haritadaki en yakın kafeyi, renk uzayındaki en benzer tonu veya oyun dünyasında karaktere en yakın nesneyi bulmak istediğinizi düşünün. Tüm noktaları tek tek karşılaştırmak kolaydır; ancak veri büyüdüğünde işlem kısa sürede kaplumbağa hızına iner. kD-ağacı, çok boyutlu noktaları akıllıca bölerek arama sırasında ilgisiz bölgeleri elememizi sağlayan uzamsal bir veri yapısıdır.
``
kD-ağacının temel fikri
Buradaki k, noktaların boyut sayısını ifade eder. İki boyutlu bir nokta $(x,y)$, üç boyutlu bir nokta $(x,y,z)$ biçimindedir. Ağaç oluşturulurken her seviyede farklı bir eksen kullanılır. Örneğin iki boyutta kök düğüm $x$ eksenine, çocukları $y$ eksenine, sonraki seviye yeniden $x$ eksenine göre ayrılır.
Derinliği $d$ olan bir düğümün bölme ekseni şöyle seçilebilir:
\[eksen = d \bmod k\]Dengeli bir ağaç kurmak için noktalar ilgili eksene göre sıralanır ve ortanca nokta düğüm yapılır. Ortancadan küçük değerler sol, büyük değerler sağ alt ağaca gider. Böylece uzay, iç içe geçmiş dikdörtgensel bölgelere ayrılır.
| Yaklaşım | Kurulum | Ortalama sorgu | Güçlü yanı |
|---|---|---|---|
| Doğrusal tarama | $O(1)$ | $O(n)$ | Basit ve küçük veride etkili |
| Dengeli kD-ağacı | $O(n\log n)$ | Yaklaşık $O(\log n)$ | Düşük boyutlarda hızlı |
| Hash tablosu | $O(n)$ | Yaklaşık $O(1)$ | Tam eşleşmede başarılı |
Hash tablosu yakınlık kavramını doğal olarak desteklemez. kD-ağacının avantajı ise geometrik uzaklıktan yararlanmasıdır. Öklid uzaklığının karesi hesaplanarak gereksiz karekök işleminden kaçınılabilir:
\[d^2(p,q)=\sum_{i=1}^{k}(p_i-q_i)^2\]Python ile ağacı oluşturalım
Aşağıdaki kod, noktaları ortanca değer çevresinde bölerek dengeli sayılabilecek bir kD-ağacı kurar:
class Node:
    def __init__(self, point, axis, left=None, right=None):
        self.point = point
        self.axis = axis
        self.left = left
        self.right = right


def build_kdtree(points, depth=0):
    if not points:
        return None

    k = len(points[0])
    axis = depth % k
    points = sorted(points, key=lambda p: p[axis])
    middle = len(points) // 2

    return Node(
        point=points[middle],
        axis=axis,
        left=build_kdtree(points[:middle], depth + 1),
        right=build_kdtree(points[middle + 1:], depth + 1)
    )
axis, düğümün uzayı hangi koordinata göre böldüğünü saklar. Her çağrıda veri iki parçaya ayrılır; bu da sonraki sorgularda bütün noktaları dolaşma ihtiyacını azaltır.
En yakın komşuyu aramak
Arama önce hedefin bulunduğu tarafa ilerler. Ardından hedef ile bölme düzlemi arasındaki fark, mevcut en iyi uzaklıktan küçükse diğer dal da incelenir. Bu adıma geri izleme denir.
def nearest(node, target, best=None):
    if node is None:
        return best

    distance = sum((a - b) ** 2
                   for a, b in zip(node.point, target))

    if best is None or distance < best[1]:
        best = (node.point, distance)

    axis = node.axis
    difference = target[axis] - node.point[axis]

    near = node.left if difference < 0 else node.right
    far = node.right if difference < 0 else node.left

    best = nearest(near, target, best)

    if difference ** 2 < best[1]:
        best = nearest(far, target, best)

    return best


points = [(2, 3), (5, 4), (9, 6), (4, 7), (8, 1), (7, 2)]
tree = build_kdtree(points)
point, squared_distance = nearest(tree, (6, 3))
print(point, squared_distance)
Kritik koşul difference ** 2 < best[1] ifadesidir. Bölme düzlemi mevcut adaydan daha uzaktaysa karşı tarafta daha iyi bir nokta bulunamaz; dolayısıyla o dal budanır.
Ne zaman tercih edilmeli?
kD-ağaçları harita uygulamaları, çarpışma tespiti ve düşük boyutlu makine öğrenmesi verileri için uygundur. Ancak boyut sayısı yükseldikçe bölgeler birbirine benzemeye başlar ve daha az dal elenir. “Boyutluluk laneti” olarak bilinen bu durumda sorgu maliyeti yeniden $O(n)$ seviyesine yaklaşabilir. Çok yüksek boyutlarda yaklaşık komşu arama algoritmaları daha iyi bir seçimdir; fakat iki veya üç boyutlu dünyalarda kD-ağacı hâlâ oldukça çevik bir rehberdir.
Yorumlar