Bir müşterinin aboneliğini iptal edip etmeyeceğini, bir e-postanın spam olup olmadığını veya bir görüntüde kedi bulunup bulunmadığını tahmin etmek sınıflandırma problemlerinin klasik örnekleridir. Karar ağaçları bu görevlerde anlaşılır kurallar üretir; rastgele ormanlar ise tek bir ağacın kararsızlığını çok sayıda ağacın ortak kararıyla dengeler. Kısacası: Tek bir uzman hata yapabilir, ama farklı uzmanlardan oluşan iyi bir kurul çoğu zaman daha isabetlidir.
Devamı...
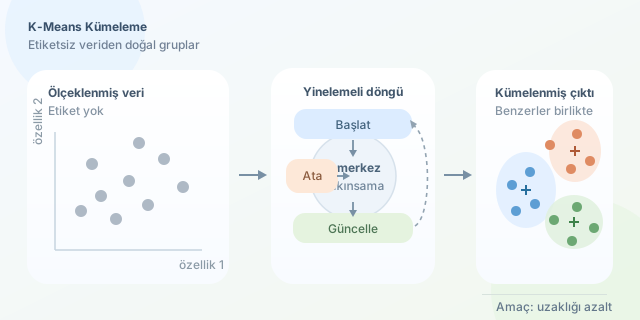
Elinizde müşteri davranışları, sensör ölçümleri ya da ürün özellikleri olsun; fakat satırlara yapıştırılmış hazır sınıf etiketleri bulunmasın. K-Means, tam bu noktada devreye giren gözetimsiz öğrenme algoritmalarından biridir. Verileri önceden bilinen sınıflara atamak yerine, benzer gözlemleri aynı kümelerde toplayarak veri içindeki doğal yapıyı görünür kılar. Bir nevi kalabalık bir partide benzer ilgi alanlarına sahip insanların kendiliğinden küçük gruplar oluşturmasını izleriz.
Devamı...
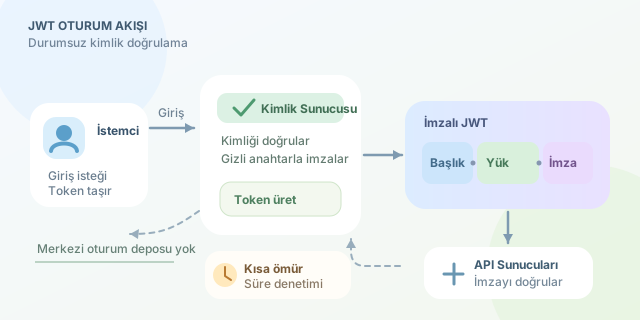
Modern web uygulamalarında kullanıcı oturumunu yönetmenin iki temel yolu vardır: sunucuda oturum bilgisi saklamak veya bu bilgiyi istemcinin taşıdığı imzalı bir belirtece emanet etmek. JSON Web Token (JWT), ikinci yaklaşımın popüler temsilcisidir. Kullanıcı giriş yaptığında sunucu, kimliği ve yetkileri içeren imzalı bir token üretir; sonraki isteklerde token gönderilir ve sunucu imzayı doğrulayarak kullanıcıyı tanır. Böylece her istekte veritabanına ya da merkezi bir oturum deposuna bakmak zorunda kalmazsınız.
Devamı...
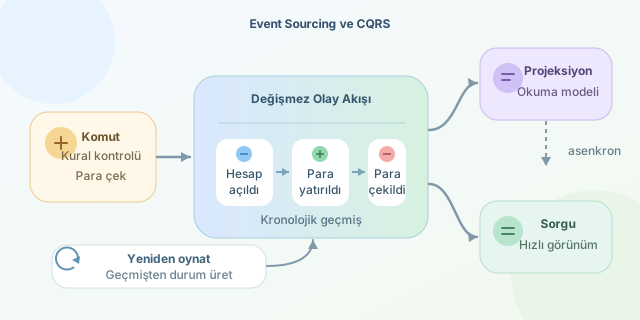
Geleneksel uygulamalar genellikle bir müşterinin mevcut bakiyesini, siparişin son durumunu veya kullanıcının güncel profilini saklar. Event Sourcing ise daha meraklı bir yaklaşım benimser: “Bu durum nasıl oluştu?” sorusunun cevabını da saklar. Sistem durumu, değişmez olayların kronolojik dizisinden yeniden üretilir. CQRS (Command Query Responsibility Segregation) bu fikri, yazma ve okuma modellerini ayırarak tamamlar. İkili birlikte kullanıldığında ilk bakışta karmaşık görünse de denetlenebilir, ölçeklenebilir ve geçmişi güçlü sistemler kurmayı sağlar.
Devamı...
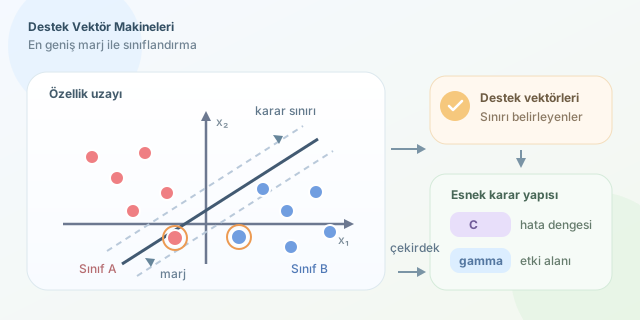
Destek Vektör Makineleri (Support Vector Machines, SVM), iki ya da daha fazla sınıfı ayırırken yalnızca bir çizgi çizmekle yetinmeyen klasik bir makine öğrenmesi algoritmasıdır. Temel hedefi, sınıflar arasındaki en güvenli koridoru, yani en geniş marjı bulmaktır. Bir tarafta kırmızı noktalar, diğer tarafta mavi noktalar olduğunu düşünün: SVM, iki grubun arasından geçen ve her iki gruba da olabildiğince uzak duran sınırı seçmeye çalışır. Bu yaklaşım, modelin yeni ve görülmemiş verilerde daha dayanıklı kararlar vermesine yardım eder.
Devamı...
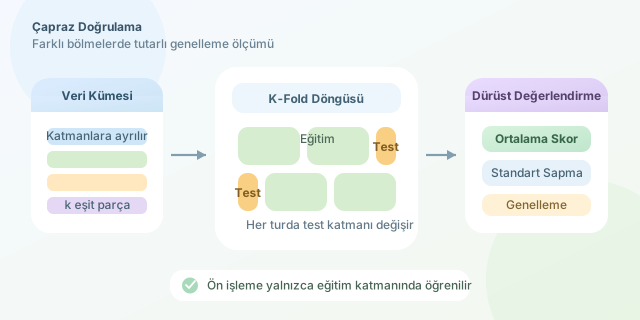
Bir makine öğrenmesi modelinin eğitim verisinde harika sonuç vermesi, henüz gerçek dünyada da başarılı olacağı anlamına gelmez. Asıl soru şudur: Model, daha önce hiç görmediği örneklerde ne kadar iyi çalışır? Çapraz doğrulama (cross-validation), veriyi akıllıca parçalara ayırarak bu soruya daha güvenilir bir yanıt üretir. Tek bir eğitim-test ayrımının şansına güvenmek yerine, modelin farklı veri dilimlerindeki tutarlılığını ölçer.
Devamı...
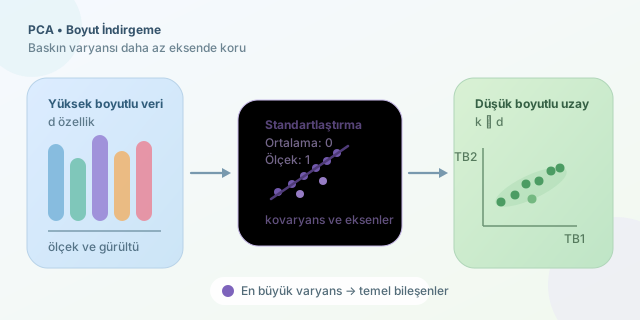
Yüksek boyutlu veriler ilk bakışta zengin görünür: her sütun yeni bir özellik, her özellik yeni bir ipucu demektir. Ancak onlarca hatta binlerce özellik, hesaplama maliyetini artırır; gürültüyü büyütür ve modellerin genelleme kabiliyetini zorlayabilir. Boyut indirgeme, bilgiyi rastgele silmek yerine verideki baskın örüntüleri daha az sayıda eksende toplamayı hedefler. Temel Bileşenler Analizi (PCA), bu işin en klasik ve güçlü araçlarından biridir.
Devamı...
Bir sınıfın çalışmak için ihtiyaç duyduğu nesneleri kendi içinde üretmesi, ilk bakışta pratik görünür: new yazılır ve iş biter. Ancak uygulama büyüdükçe bu küçük kolaylık; değiştirmesi zor, testleri pahalı ve bileşenleri birbirine yapışmış bir mimariye dönüşür. Bağımlılık Enjeksiyonu (Dependency Injection, DI), sınıfın ihtiyaç duyduğu bağımlılıkları oluşturmak yerine dışarıdan almasını sağlayarak bu yapışkanlığı azaltan güçlü bir tasarım tekniğidir.
Devamı...
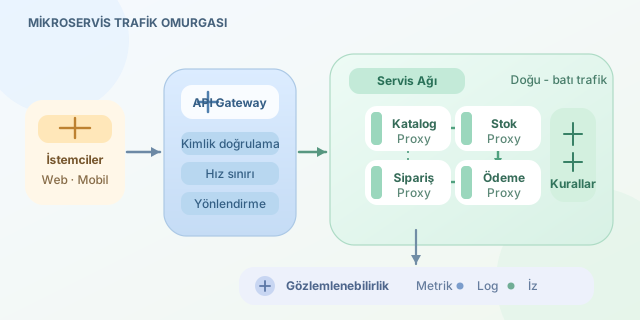
Mikroservis mimarisinde her servis kendi başına küçük ve bağımsız görünür; fakat sistem büyüdükçe aralarındaki iletişim hızla karmaşıklaşır. Bir kullanıcının tek isteği, kimlik doğrulama, katalog, stok, ödeme ve bildirim servislerine uğrayabilir. API Gateway dış dünyadan gelen trafiğin kontrol kulesiyken, servis ağı (service mesh) iç ağdaki servisler arası konuşmanın trafik polisi gibidir. Birlikte kullanıldıklarında güvenlik, yönlendirme, hata toleransı ve gözlemlenebilirlik için düzenli bir omurga oluştururlar.
Devamı...
Bir ürün ekibinin en tehlikeli cümlesi bazen şudur: “Yeni buton daha güzel görünüyor, yayınlayalım.” Güzel görünüm değerli olsa da dönüşümü gerçekten artırıp artırmadığını yalnızca kontrollü deney söyleyebilir. A/B testi, kullanıcıları rastgele iki veya daha fazla varyanta ayırarak tek bir değişikliğin davranış üzerindeki etkisini ölçme yöntemidir. Amaç, sezgiyi öldürmek değil; sezgiyi ölçülebilir kanıtla güçlendirmektir.
Devamı...
Bir sunucuyu panelden tek tek oluşturmak, ağ kurallarını elle yazmak ve hangi ayarın nerede değiştiğini hatırlamaya çalışmak; küçük projelerde bile hızla yorucu hâle gelir. Infrastructure as Code (IaC) yaklaşımı, altyapıyı Terraform dosyalarında tanımlayarak bu süreci yazılım geliştirmeye benzetir: değişiklikler sürüm kontrolüne girer, gözden geçirilir ve aynı ortam tekrar tekrar üretilebilir.
Devamı...
Bilgisayarlar son derece düzenli makinelerdir: aynı girdiye, aynı koşullarda daima aynı çıktıyı verirler. Bu yüzden ekranda “rastgele” görünen bir oyun zarı, şifreleme anahtarı ya da simülasyon sonucu aslında çoğu zaman dikkatle tasarlanmış bir algoritmanın ürünüdür. Bu algoritmalar, tahmin edilmesi zor ve istatistiksel olarak dengeli diziler üretmeye çalışır; fakat geçmişteki durumları bilen biri için sonuçlar teorik olarak yeniden üretilebilir.
Devamı...
Mikroservisler birbirini doğrudan ve senkron çağırdığında, küçük bir gecikme bile zincirleme arızaya dönüşebilir. RabbitMQ bu bağı gevşetir: sipariş servisi işi bir kuyruğa bırakır, bildirim servisi uygun olduğunda alır. Böylece servisler farklı hızlarda çalışabilir, yoğunluk dalgaları daha yönetilebilir hâle gelir.
Devamı...
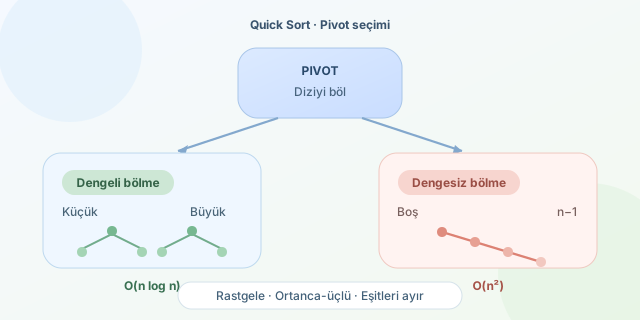
Quick Sort, pratikte son derece hızlı çalışan ancak kaderi büyük ölçüde pivot seçimine bağlı olan klasik bir sıralama algoritmasıdır. Temel fikir basittir: Diziden bir pivot seçilir, küçük elemanlar sol tarafa, büyük elemanlar sağ tarafa bölünür ve aynı işlem alt dizilerde tekrarlanır. Fakat kötü seçilmiş bir pivot, zarif görünen bu yaklaşımı beklenmedik biçimde yavaşlatabilir.
Devamı...
Bir uygulamanın kullanıcı adına Google Drive dosyalarına erişmesi, GitHub depolarını listelemesi veya Spotify çalma listesi oluşturması sık rastlanan bir ihtiyaçtır. Ancak uygulamanın kullanıcının parolasını istemesi hem tehlikeli hem de gereksizdir. OAuth 2.0, parolayı paylaşmadan, sınırlı ve süreli erişim izinleri vermeyi sağlayan yetkilendirme çerçevesidir. Kısacası uygulamaya evinizin anahtarını değil, yalnızca belirli odalara girebilen ve süresi dolan bir ziyaretçi kartı verirsiniz.
Devamı...
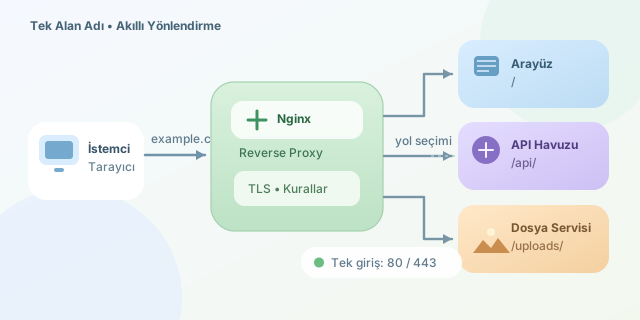
Modern bir web uygulaması çoğu zaman tek bir sunucudan ibaret değildir: arayüz, API, kimlik doğrulama ve dosya servisleri farklı süreçlerde hatta farklı makinelerde çalışabilir. Nginx reverse proxy, istemcinin tek bir alan adına yaptığı isteği uygun arka uç (backend) servisine ileterek bu karmaşıklığı görünmez kılar. Tarayıcı example.com/api/users adresini görür; Nginx ise isteği örneğin localhost:3000 üzerindeki API uygulamasına taşır.
Devamı...
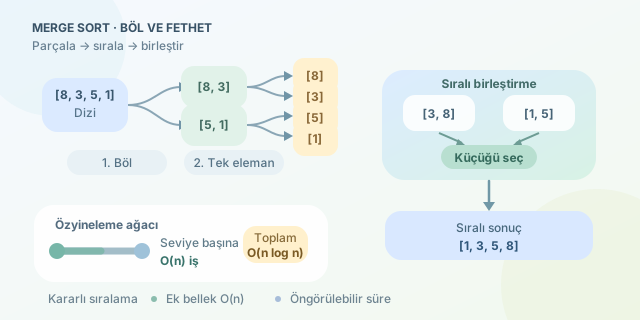
Merge Sort, karmaşık görünen bir sıralama işini şaşırtıcı derecede düzenli bir plana dönüştürür: Büyük diziyi sürekli ikiye böl, tek elemanlı parçalara ulaştığında bu parçaları sıralı biçimde geri birleştir. Bu yaklaşım, böl-fethet (divide and conquer) stratejisinin en tanınan örneklerinden biridir. Özellikle milyonlarca kayıt, log satırı veya zaman damgalı olay işlenirken öngörülebilir çalışma süresi sayesinde güven verir.
Devamı...
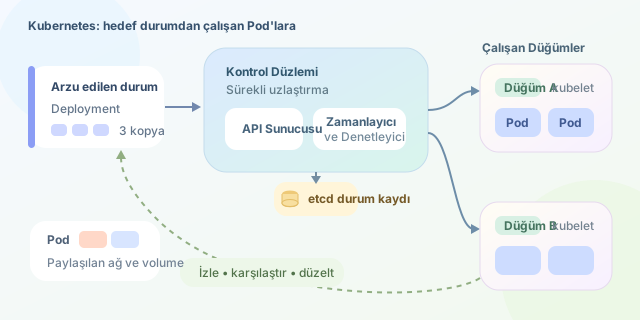
Modern uygulamalar tek bir sunucuda çalışan dev programlar olmaktan çıktı; küçük, bağımsız ve konteynerleşmiş servislerden oluşuyor. Ancak yüzlerce konteyneri doğru makineye yerleştirmek, çökenleri yeniden başlatmak ve trafik arttığında kapasiteyi büyütmek elle yapılabilecek bir iş değildir. Kubernetes, tam bu noktada konteyner kümelerini yöneten, dağıtımı otomatikleştiren ve uygulamanın arzu edilen durumunu koruyan orkestrasyon platformudur.
Devamı...
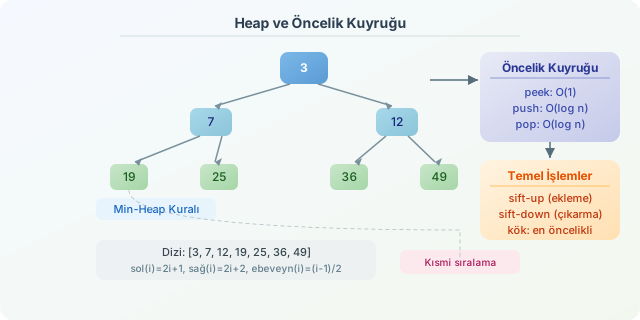
Bir iş kuyruğunda herkes sırayla beklemek zorunda değildir: acil bir hata kaydı, normal bir rapordan önce işlenmelidir. İşte öncelik kuyruğu bu ihtiyacı çözer; heap (ikili yığın) ise en yüksek ya da en düşük öncelikli elemana son derece hızlı ulaşmanın pratik yoludur. Heap, “tam sıralı dizi” kadar katı davranmaz; yalnızca her ebeveynin çocuklarıyla olan ilişkisini düzenler. Bu küçük kural, büyük performans kazancı sağlar.
Devamı...
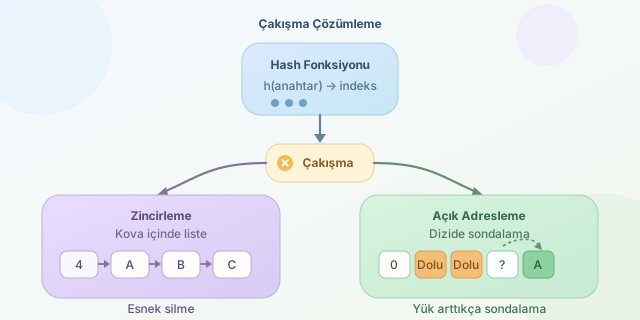
Hash tabloları, bir anahtarı hızlıca bir değere bağlamak için kullanılan en pratik veri yapılarındandır. İdeal senaryoda ekleme, arama ve silme işlemleri sabit zamanda çalışır; fakat iki farklı anahtarın aynı indekse düşmesi, yani çakışma, bu idealin küçük ama önemli düşmanıdır. Zincirleme ve açık adresleme, bu sorunu çözmek için iki temel yaklaşımdır.
Devamı...